


Sensitive Data Protection umfasst verschiedene Methoden, mit denen Sie Daten prüfen, transformieren (de-identifizieren), erkennen und klassifizieren können. Mit diesen Methoden können Sie Daten sowohl innerhalb als auch außerhalb von Google Cloud scannen und das Verhalten von Sensitive Data Protection für verschiedene Arten von Arbeitslasten optimieren.
Sensitive Data Protection bietet die folgenden Methodentypen:
Prüf- und De-Identifikationsmethoden
In diesem Abschnitt werden die Methoden beschrieben, mit denen Sie alle Daten, die einem in Ihrer Prüfkonfiguration aufgeführten Informationstyp entsprechen, finden und optional de-identifizieren können.
Inhaltsmethoden
Inhaltsmethoden sind synchrone, zustandslose Methoden. Die zu prüfenden oder zu transformierenden Daten werden direkt in der Anfrage an die DLP API gesendet. Die Prüfergebnisse von Sensitive Data Protection oder die transformierten Daten werden in der API-Antwort zurückgegeben. Anfragedaten werden bei der Übertragung verschlüsselt und nicht gespeichert.
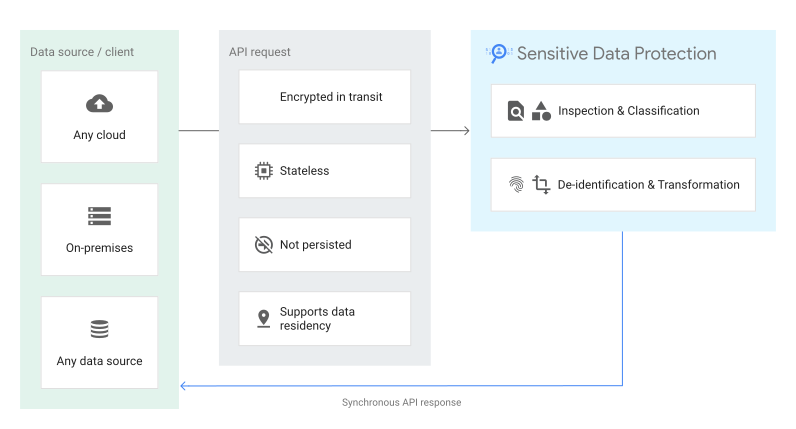
Wann sollten Inhaltsmethoden verwendet werden?
Im Folgenden sind einige gängige Anwendungsfälle aufgeführt:
- Nutzereingaben in Echtzeit prüfen: Formularfelder, Chatnachrichten oder Feedback-Einreichungen in Web- und mobilen Anwendungen synchron scannen, bevor Daten in Datenbanken gespeichert werden.
- Sensible Texte vor der externen Verarbeitung maskieren: Sensible Tokens aus Textstrings synchron de-identifizieren oder entfernen, bevor Inhalte an APIs von Drittanbietern oder Large Language Models (LLMs) übergeben werden.
- Sensible Daten aus hochgeladenen Bildern entfernen: Verschleiern Sie sensiblen Text in Bildformaten (z. B. JPEG, PNG oder BMP), indem Sie undurchsichtige Rechtecke über erkannte personenidentifizierbare Informationen legen, bevor das Bild angezeigt oder gespeichert wird.
- Tokenisierte Daten bei Bedarf re-identifizieren: De-tokenisieren Sie zuvor pseudonymisierte Tokens in autorisierten serverseitigen Workflows, wenn ein authentifizierter geschäftlicher Nutzer Zugriff auf den ursprünglichen Klartext benötigt.
- Datenschutz in clientseitigen Anwendungen validieren: Führen Sie zustandslose Datenschutzprüfungen auf Endpunkten aus, ohne Cloud Storage-Repositories bereitzustellen oder eine Backend-Jobinfrastruktur zu konfigurieren.
Weitere Informationen finden Sie in der REST API-Referenz für Inhaltsmethoden:
Speichermethoden
Speichermethoden sind für die Prüfung von Daten konzipiert, die auf Google Cloud in Systemen wie Cloud Storage, BigQuery und Firestore im Datastore-Modus (Datastore) gespeichert sind. Wenn Sie die Speicherprüfung aktivieren möchten, erstellen Sie einen Sensitive Data Protection-Job mit der Ressource dlpJobs. Jeder Job wird als verwalteter Dienst ausgeführt, um Daten zu prüfen und dann Sensitive Data Protection-Aktionen auszuführen, z. B. Ergebnisse zu speichern oder zu veröffentlichen. Zusätzlich zu diesen optionalen Aktionen erstellt und speichert Sensitive Data Protection Details zum Job, einschließlich Jobstatus, gescannter Byte und zusammengefasster Ergebnisse pro infoType. Sie können Jobs mit der DLP API oder Sensitive Data Protection in der Google Cloud -Console verwalten.

Wann Speichermethoden verwendet werden sollten
Im Folgenden sind einige gängige Anwendungsfälle aufgeführt:
- Große analytische Tabellen scannen: Datasets im Petabyte-Bereich in BigQuery mit verteiltem, serverlosem Batch-Scanning prüfen.
- Unstrukturierte Datei-Repositories prüfen: Prüfen Sie Dokumente, Archive und Mediendateien, die in Cloud Storage-Buckets gespeichert sind, um unverschlüsselte oder falsch platzierte sensible Daten zu finden.
- Verlauf der Scanergebnisse und Trends verfolgen: Speichern Sie detaillierte Prüfergebnisse direkt in BigQuery-Tabellen, um Ergebnisse im Zeitverlauf zu verfolgen und Compliance-Audit-Trails zu generieren.
- Ereignisgesteuerte Workflows zur Problembehebung auslösen: Streamen Sie Ereignisse zum Abschluss von Scans und Benachrichtigungen zu Ergebnissen mit hohem Risiko an Pub/Sub, um automatisierte Playbooks für Sicherheitsreaktionen zu starten.
- Stichproben aus großen Datasets für Kosteneffizienz: Konfigurieren Sie Stichprobenlimits oder Zeilenlimits, um den Datenrisikostatus in großen Datenbanken zu schätzen, ohne ganze Datasets zu scannen.
Weitere Informationen finden Sie in der REST API-Referenz für die Ressource projects.dlpJobs. Die Speicherdetails geben Sie im Objekt StorageConfig an.
Hybridmethoden
Hybridmethoden sind eine Reihe asynchroner API-Methoden, mit denen Sie Nutzlasten von Daten, die von praktisch jeder Quelle gesendet werden, auf vertrauliche Informationen prüfen und die Ergebnisse in Google Cloudspeichern können. Hybridmethoden ähneln Inhaltsmethoden, da die zu prüfenden Daten in einer oder mehreren Prüfanfragen enthalten sind. Im Gegensatz zu Inhaltsmethoden geben Hybridmethoden jedoch keine Prüfergebnisse in der API-Antwort zurück. Stattdessen werden die Prüfergebnisse serverseitig asynchron verarbeitet und die Ergebnisse werden ähnlich wie bei Speichermethoden tabellarisch dargestellt und gespeichert.
Wenn Sie die Hybridprüfung aktivieren möchten, erstellen Sie einen Sensitive Data Protection-Job mit der Ressource dlpJobs. Jeder Hybridjob wird als verwalteter Dienst ausgeführt, um auf Prüfanfragen zu warten, und führt Sensitive Data Protection-Aktionen aus, z. B. das Speichern oder Veröffentlichen von Ergebnissen. Zusätzlich zu diesen optionalen Aktionen erstellt und speichert Sensitive Data Protection Details zum Job, einschließlich Jobstatus, gescannter Byte und zusammengefasster Ergebnisse pro infoType. Sie können Jobs mit der DLP API oder Sensitive Data Protection in der Google Cloud Console verwalten.

Wann sollten Hybridmethoden verwendet werden?
Im Folgenden sind einige gängige Anwendungsfälle aufgeführt:
- Daten in Hybrid- und Multi-Cloud-Umgebungen prüfen: Streamen Sie Daten aus lokalen Datenbanken, Bare-Metal-Servern oder anderen Cloud-Anbietern in Sensitive Data Protection, während die Ergebnisberichte inGoogle Cloudzentralisiert bleiben.
- Datenpipelines benutzerdefinierter Anwendungen prüfen: Senden Sie Streamingdaten von benutzerdefinierten Crawlern, Mikrodiensten oder ETL-Pipelines an Sensitive Data Protection, ohne lokale Scanner-Worker-Flotten verwalten zu müssen.
- Arbeitslasten während der Cloud-Migration bereinigen: Sensible Assets während der Live-Datenbankreplikation von Legacy-Systemen in Google Cloudkontinuierlich prüfen und tokenisieren.
- Multi-Cloud-Compliance-Berichte zentralisieren: Aggregieren Sie Prüfergebnisse aus verschiedenen Betriebsumgebungen in einem einzigen BigQuery-Dataset für eine einheitliche Governance.
- Benutzerdefinierte Dateitypen und proprietäre Formate verarbeiten: Extrahieren Sie Text clientseitig aus proprietären Binärformaten und streamen Sie die extrahierten Nutzlasten zur Prüfung an Sensitive Data Protection.
Weitere Informationen finden Sie in der REST API-Referenz für die Ressource projects.dlpJobs. Sie geben die Datenquelle im Feld hybridOptions des StorageConfig-Objekts an.
Erkennungsmethoden
Mit Erkennungsmethoden können Sie die Erkennung sensibler Daten so konfigurieren, dass Datenprofile generiert werden. Datenprofile liefern Informationen, mit denen Sie feststellen können, wo sich sensible Daten in Ihrer Organisation befinden, welche Art von sensiblen Daten Sie speichern und ob für diese Daten Zugriffssteuerungen vorhanden sind.
Sie können die Erkennung so konfigurieren, dass in Google Cloud Datenspeichern in Systemen wie BigQuery, Cloud SQL, Cloud Storage und Vertex AI gespeicherte Daten gescannt werden. Wenn Sie Security Command Center Enterprise aktiviert haben, können Sie Sensitive Data Protection auch zum Scannen von Daten anderer Cloud-Anbieter verwenden.
Sie können Aktionen angeben, die Sensitive Data Protection nach jedem Erkennungsscan ausführen soll. Sie können beispielsweise Scanergebnisse an andereGoogle Cloud -Dienste wie Security Command Center und Google Security Operations senden, um einen besseren Überblick über den Datensicherheitsstatus Ihrer Organisation zu erhalten. Sie können den Discovery-Dienst so konfigurieren, dass Ihre profilierten Ressourcen getaggt werden, um den IAM-Zugriff auf diese Ressourcen automatisch zu gewähren oder zu verweigern. Sie können die Datenprofile auch nach BigQuery exportieren. Sie können die exportierten Profile mit Data Studio verbinden, um den vorgefertigten Bericht aufzurufen. Sie können auch eigene benutzerdefinierte Abfragen und Berichte erstellen.
Zum Aktivieren der Erkennung erstellen Sie eine DiscoveryConfig-Ressource. Die Erkennung wird basierend auf dem Umfang und der Häufigkeit ausgeführt, die Sie in der Erkennungskonfiguration festgelegt haben. Informationen dazu, wo Sensitive Data Protection die generierten Profile speichert, finden Sie unter Überlegungen zum Datenstandort.
Sie können die Erkennungskonfigurationen, Datenprofile und Cloud SQL-Verbindungen über die DLP API oder die Google Cloud Console verwalten.

Wann sollten Erkennungsmethoden verwendet werden?
Im Folgenden sind einige gängige Anwendungsfälle aufgeführt:
- Organisationsweite Datenerkennung automatisieren: Alle Datenbestände in BigQuery, Cloud SQL und Cloud Storage kontinuierlich scannen und profilieren, ohne einzelne Scanjobs oder Zeitpläne schreiben zu müssen.
- Daten-Repositories mit hohem Risiko identifizieren: Generieren Sie Datenrisiko- und Datensensitivitätswerte für Tabellen und Buckets, um Datenschutz- und Governance-Initiativen zu priorisieren.
- Dynamische Zugriffssteuerungen mit Daten-Tags erzwingen: Profilierte Ressourcen werden automatisch anhand der erkannten InfoTypes getaggt, um den Zugriff mithilfe von IAM-Richtlinien (Identity and Access Management) zu gewähren oder einzuschränken.
- Datensicherheitsstatus-Verwaltung füttern: Senden Sie Insights aus Erkennungsprofilen an Security Command Center und Google Security Operations, um Datenrisiken mit Infrastrukturbedrohungen zu korrelieren.
- Compliancestatus mit Executive Dashboards visualisieren: Exportieren Sie Datenprofile nach BigQuery und verbinden Sie vorgefertigte Data Studio-Dashboards, um die Verteilung sensibler Daten in der Organisation, in Ordnern und Projekten zu überwachen.
Weitere Informationen finden Sie in der REST API-Referenz für Folgendes:
Erkennungskonfigurationen
Verbindungen
Verbindungen sind nur für die Erkennung für Cloud SQL relevant.
Datenprofile
organizations.locations.projectDataProfilesprojects.locations.projectDataProfilesorganizations.locations.fileStoreDataProfilesprojects.locations.fileStoreDataProfilesorganizations.locations.tableDataProfilesprojects.locations.tableDataProfilesorganizations.locations.columnDataProfilesprojects.locations.columnDataProfiles
Nächste Schritte
- Lesen Sie die Anleitungen, um zu erfahren, wie Sie Texte und Bilder auf sensible Daten prüfen und sensible Daten aus Texten und Bildern entfernen:
- Weitere Informationen zum Prüfen des Speichers und zum Verwenden von Aktionen finden Sie unter Speicher und Datenbanken auf sensible Daten prüfen.
- Weitere Informationen zur Erkennung sensibler Daten finden Sie unter Datenprofile.
- Preise prüfen