Questa pagina elenca i tipi di file che Sensitive Data Protection può scansionare e descrive le modalità di scansione utilizzate da Sensitive Data Protection per analizzare i file.
Tipi di file supportati nelle operazioni di ispezione e anonimizzazione
La tabella seguente mostra i tipi di file che Sensitive Data Protection può ispezionare e trasformare (anonimizzare).
Sensitive Data Protection si basa sulle estensioni dei file e sui tipi MIME per identificare i tipi di file da scansionare e le modalità di scansione da applicare. Ad esempio, Sensitive Data Protection scansiona un file .txt in modalità testo normale, anche se il file è strutturato come un file CSV, che normalmente viene scansionato in modalità di analisi strutturata.
| Tipo di file | Estensioni dei file | Limiti | Modalità di scansione | Supporto per la trasformazione |
|---|---|---|---|---|
Apache Avro |
avro |
Limiti di Avro | Analisi strutturata | |
Comma- or tab-separated values | csv, tsv | Analisi strutturata | Anonimizza i contenuti | |
PDF |
Limiti dei PDF | Analisi intelligente dei documenti | ||
Text |
asc, brf, c, c++, cc, cpp, cs, css, cxx, dart, eml, go, h, h++, hh, hpp, hs, htm, html, hxx, ini, java, js, json, jsonl, lhs, m, markdown, md, mkd, ml, mli, ocaml, php, pht, phtml, pl, pm, py, pyw, rb, rbw, rc, rs, scala, sh, shtm, shtml, sql, tex, text, txt, vcard, vcs, wml, xhtml, xml, xsd, xsl, yaml, yml |
Testo normale | Anonimizza i contenuti | |
Microsoft Word |
docm, docx, dotm, dotx |
Limiti di parole | Analisi intelligente dei documenti | |
Microsoft Excel |
xlsm, xlsx, xltm, xltx |
Limiti di Excel | Analisi intelligente dei documenti | |
Microsoft Powerpoint |
potm, potx, pptm, pptx |
Limiti di PowerPoint | Analisi intelligente dei documenti | |
Image |
bmp, gif, jpe, jpeg, jpg, png, tif, tiff |
Limiti dei file TIFF |
|
Oscuramento per tutti i tipi di immagini, ad eccezione di TIFF |
Binary |
Tipi di file non riconosciuti e immagini che non possono essere scansionate utilizzando il riconoscimento ottico dei caratteri (OCR), il rilevamento dei contenuti delle immagini o la classificazione dei contenuti delle immagini. |
Binario |
Cluster di file supportati nelle operazioni di discovery
Durante il discovery, Sensitive Data Protection organizza i file rilevati in cluster di file. Questi cluster sono gruppi di tipi di file simili. La tabella seguente mostra i cluster di file e le estensioni dei file supportati. Non tutti i file rilevati sono scansionabili.
I file potrebbero spostarsi tra i cluster di file man mano che Sensitive Data Protection aggiunge il supporto per altri cluster di file. Man mano che il supporto della scansione si espande, il servizio di rilevamento potrebbe iniziare a scansionare file che in precedenza non venivano scansionati. La fatturazione avviene come descritto in Prezzi di Discovery.
| Cluster di file | Estensioni dei file | Limiti | Modalità di scansione |
|---|---|---|---|
Text |
asc, eml, htm, html, ini, json, jsonL, log, markdown, md, mkd, plist, shtm, shtml, sql, tex, text, txt, vcard, vcs, xsd, xsl |
Testo normale | |
Source Code |
bat, brf, c, c++, cc, cmd, cpp, cs, css, cxx, dart, go, h, hh, hpp, hs, hxx, java, js, lhs, m, ml, ocaml, php, phtm, phtml, pl, ps1, py, pyw, rb, rbw, rc, rs, scala, scpt, scr, script, sh, sql, vb, vbs, wml, xml, yaml, yml |
Testo normale | |
Structured Data |
avro, csv, tsv, proto |
Analisi strutturata per file Avro, CSV e TSV. Analisi del testo normale per i file proto | |
Rich Documents |
doc, docm, docx, dotm, dotx, pdf, potm, potx, ppt, pptm, pptx, xls, xlsm, xlsx, xltm, xltx |
Vengono scansionati i file PDF, Microsoft Word, Excel e PowerPoint supportati di dimensioni inferiori a 30 MiB. | Analisi intelligente dei documenti |
Images |
bmp, gif, heic, ico, jpe, jpeg, jpg, pm, png, svg, tif, tiff, webp |
Le immagini supportate (bmp, gif, jpe, jpeg, jpg, png, tif e tiff) di dimensioni inferiori a 4 MiB vengono scansionate utilizzando l'OCR nelle regioni che supportano la scansione delle immagini. Le immagini TIFF sono soggette ai limiti TIFF. |
|
Executables |
ac, air, apk, app, appimage, bas, bin, bms, class, cls, com, command, ctl, ctx, dca, ddf, dep, dll, dob, dox, dsr, dsx, dws, exe, frm, frx, gadget, ipa, mpk, oca, ocx, pag, pgx, pif, pyc, res, run, scb, tlb, vbd, vbg, vbl, vbp, vbr, vbw, vbz, vlx, wct, widget, workflow, wsf, x86, x86_64, xap, xbe, xlm |
Al momento non analizzato | |
Archives |
7z, a, ace, afa, alz, apk, ar, arc, arj, ark, b1, b6z, ba, bh, cab, car, cdx, cfs, cpio, cpt, dar, dd, dgc, dmg, ear, esd, gca, genozip, gz, ha, hki, ice, ima, img, iso, jar, kgb, lha, lpaq#*, lzh, lzx, mou, pak, paq#*, paq6, paq7, paq8 e varianti, partimg, pea, phar, pim, pit, qda, rar, rk, run, s7z, sda, sea, sen, sfx, shar, shk, sit, sitx, sqx, swm, tar, tar.bz2, tar.gz, tar.lz4, tar.lzma, tar.xz, tar.z, tgz, uc, uc0, uc2, uca, ucn, ue2, uha, ur2, war, wim, xar, xp3, yz1, zip, zipx, zoo, zpaq, zz |
Sensitive Data Protection scansiona i file all'interno di archivi con queste estensioni del file: bz2, cpio, gz, jar, lz4, lzma, tar, tar.bz2, tar.gz, tar.lz4, tar.lzma, tar.xz, tar.z, xz, z, zip La modalità di scansione utilizzata per ogni file dipende dal tipo di file. |
|
Multimedia |
3g2, 3gp, 8svx, aa, aac, aax, act, aiff, alac, amr, amv, ape, asf, au, avi, awb, cda, drc, dss, dvf, f4a, f4b, f4p, f4v, flac, flv, gif, gifv, gsm, iklax, ivs, M2TS, m2v, m4a, m4b, m4p, m4p (con DRM), m4v, mkv, mmf, mng, mogg, mov, movpkg, mp2, mp3, mp4, mpc, mpe, mpeg, mpg, mpv, msv, MTS, mxf, nmf, nsv, oga, ogg, ogv, opus, qt, ra, raw, rf64, rm, rmvb, roq, sln, svi, TS, tta, viv, vob, voc, vox, wav, webm, wma, wmv, wv, yuv |
Al momento non analizzato | |
AI Models |
caffemodel, ckpt, coreml, dlc, ggjt, ggmf, ggml, gguf, h5, keras, llamafile, mar, mleap, nc, npy, npz, onnx, pb, pkl, prompt, pt, pt2, pte, pth, ptl, safetensors, surml, tflite, tfrecords |
Al momento non scansionato | |
Unknown |
Qualsiasi altro file non incluso in un altro cluster. | Si tratta di file privi di estensioni o che utilizzano estensioni comuni, ma non standard, come .dat, .1 o .2. | Al momento non scansionato |
Tipi di file non riconosciuti in Cloud Storage
Se un file non viene riconosciuto durante una scansione dello spazio di archiviazione, il sistema lo scansionerà per impostazione predefinita come file binario. Tenta di convertire i contenuti in UTF_8, quindi li analizza come testo normale.
Se un file non viene riconosciuto durante una scansione di rilevamento, il sistema non lo scansiona.
Se hai una raccolta di file che vuoi saltare perché Sensitive Data Protection non li riconosce, puoi specificare un elenco di esclusione utilizzando CloudStorageOptions.file_set.regex_file_set.exclude_regex.
Limiti relativi ai byte analizzati per file
In generale, puoi limitare il numero di byte scansionati per file. Nella consoleGoogle Cloud , devi attivare il campionamento. Nell'API Cloud Data Loss Prevention, imposta il campo bytes_limit_per_file o bytesLimitPerFilePercent.
Il campionamento non è supportato nelle modalità OCR e di analisi intelligente. In altre parole, quando i seguenti tipi di file vengono scansionati in modalità OCR o di analisi intelligente dei documenti, Sensitive Data Protection ignora le impostazioni applicate per limitare i byte scansionati per file.
- Immagine
- Microsoft Excel
- Microsoft PowerPoint
- Microsoft Word
Se analizzi questi file in modalità binaria, si applicano i limiti.
Modalità di scansione
Ogni modalità di scansione fornisce dettagli sulla posizione aggiuntivi nei risultati dell'ispezione.
Per le immagini TIFF, l'oggetto ImageLocation include anche un campo pageNumber, che identifica la pagina che contiene il risultato. I numeri di pagina iniziano da 0.
| Modalità di scansione | Note | Ulteriori dettagli sulla località da fornire |
|---|---|---|
| Binario | Se un file non viene analizzato come un altro tipo, verrà convertito in UTF_8 e scansionato come testo. La scansione binaria influisce sulla qualità del rilevamento. |
|
| Analisi intelligente dei documenti | I documenti vengono analizzati con il testo estratto dalla formattazione. Le immagini incorporate vengono analizzate utilizzando l'OCR nelle regioni che lo supportano. Al di fuori di queste regioni, le immagini vengono scansionate come file binari. |
DocumentLocation |
| Estrazione dei metadati | Tutti i file scansionati da Cloud Storage avranno |
MetadataLocation |
| Riconoscimento ottico dei caratteri (OCR) |
Nelle regioni che supportano la scansione delle immagini, Sensitive Data Protection utilizza l'OCR per trovare infoType basati su testo nelle immagini. |
ImageLocation |
| Rilevamento contenuti nelle immagini | Nelle regioni che supportano la scansione delle immagini, Sensitive Data Protection può analizzare direttamente i pixel e le caratteristiche delle immagini, anziché il testo estratto dalle immagini. Questa modalità di scansione si concentra sull'individuazione di un elemento specifico all'interno dell'immagine e produce un riquadro di delimitazione attorno ad esso. Ad esempio, questa modalità di analisi può rilevare una persona o un codice a barre in una posizione specifica di un'immagine. Sensitive Data Protection utilizza questa modalità di scansione per tutti gli infoType oggetto specificati nella configurazione di ispezione o oscuramento. |
ImageLocation |
| Classificazione dei contenuti delle immagini | Nelle regioni che supportano la scansione delle immagini, Sensitive Data Protection può analizzare direttamente i pixel e le caratteristiche delle immagini, anziché il testo estratto dalle immagini. Questa modalità di scansione analizza l'intera immagine per assegnare un singolo tema o una singola categoria e genera un'etichetta o una classificazione. Sensitive Data Protection utilizza questa modalità di scansione per tutti i rilevatori di infoType di contesto delle immagini specificati nella configurazione di ispezione o oscuramento. |
ImageLocation |
| Testo normale | Nessun dettaglio aggiuntivo | |
| Analisi strutturata | Le informazioni strutturali vengono utilizzate per influenzare i risultati. In questa modalità di analisi, Sensitive Data Protection utilizza le informazioni dell'intestazione per il contesto. Esegue un'analisi tra righe e colonne per trovare dati correlati. Ad esempio, questa modalità di analisi può identificare l'indirizzo di una via i cui componenti sono distribuiti all'interno di più colonne consecutive. I risultati della scansione contengono informazioni strutturali, come la riga che contiene il risultato e il nome della colonna. I risultati non superano i confini delle celle di una tabella. |
RecordLocation |
Scansione di file strutturati in modalità di analisi strutturata
Quando esegui la scansione di un file strutturato, ad esempio un file Avro, CSV o TSV, Sensitive Data Protection tenta di eseguire la scansione del file in modalità di scansione con analisi strutturata. Questa modalità di scansione ha una qualità di rilevamento superiore rispetto alla scansione binaria perché la modalità di analisi strutturata cerca correlazioni tra righe e colonne nei dati strutturati.
I risultati vengono restituiti con metadati aggiuntivi che indicano la posizione del risultato, tra cui fieldId.
Tuttavia, nei seguenti casi, Sensitive Data Protection potrebbe tornare alla modalità di scansione binaria, che non include i miglioramenti della modalità di analisi strutturata:
- Il file o l'intestazione sono danneggiati.
- La configurazione del job di ispezione ha limiti di dimensioni, come
bytesLimitPerFileebytesLimitPerFilePercent, troppo piccoli. Ad esempio, se il limitebytesLimitPerFilenon è sufficientemente grande da includere un'intestazione di blocco completa e almeno una riga di dati validi, Sensitive Data Protection potrebbe scansionare il file in modalità di scansione binaria.
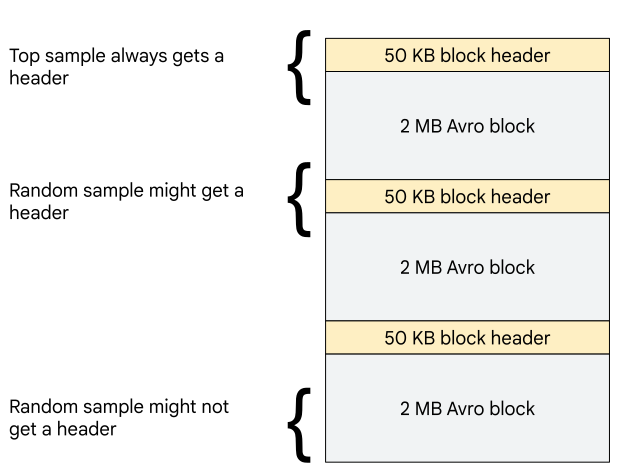
La selezione dei dati scansionati dipende dal fatto che il campionamento sia impostato per iniziare dall'inizio del file o da una posizione casuale.
Ad esempio, supponiamo di avere un file Avro con intestazioni di blocco da 50 kB e data block da 2 MB. In generale, iniziare il campionamento dall'alto ti aiuta a assicurarti che l'intestazione del blocco sia sempre inclusa nel campione prelevato da Sensitive Data Protection. Se inizi il campionamento da una posizione casuale nel file e le dimensioni del campione sono inferiori a quelle di un data block, è possibile che l'intestazione del blocco non sia inclusa nel campione. In questo esempio,
l'aumento della dimensione del campione (specificata da bytesLimitPerFile o
bytesLimitPerFilePercent) a 2,05 MB aiuta a evitare che l'ispezione
torni alla modalità di analisi binaria.