


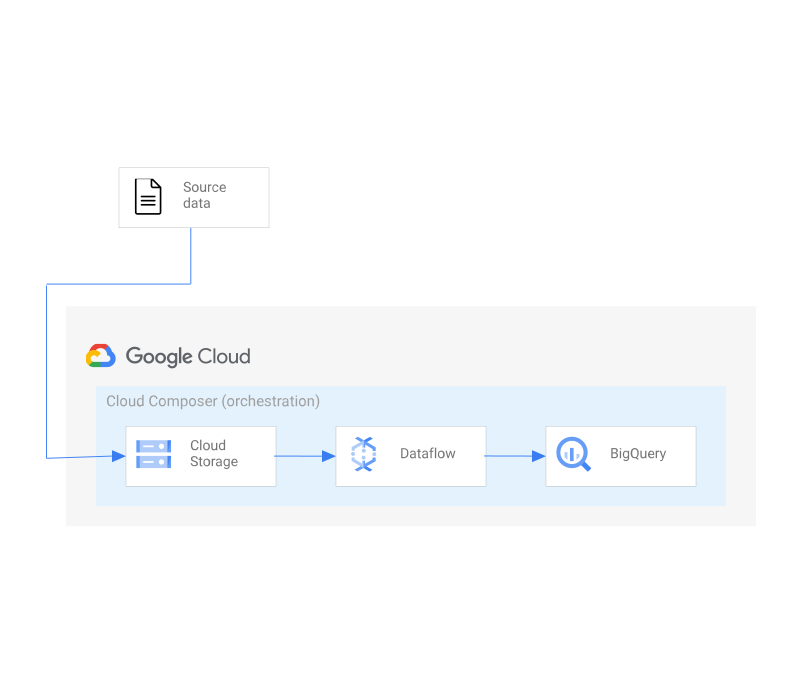
פייפליין ETL הוא ארכיטקטורה להפעלת פייפליינים לעיבוד נתונים באצווה באמצעות השיטה 'חילוץ, טרנספורמציה, טעינה'. הארכיטקטורה הזו מורכבת מהרכיבים הבאים:
- Google Cloud Storage לאחסון נתוני מקור
- Dataflow לביצוע טרנספורמציות בנתוני המקור
- BigQuery כיעד לנתונים שעברו טרנספורמציה
- סביבת Cloud Composer לתזמור תהליך ה-ETL
שנתחיל?
כדי להעתיק את קוד המקור ב-Cloud Shell, לוחצים על הקישור הבא. אחרי שמגיעים לשם, פקודה אחת תתחיל הרצה של עותק עובד של האפליקציה בפרויקט.

רכיבים של צינור ETL
ארכיטקטורת צינור ה-ETL משתמשת בכמה מוצרים. ברשימה הבאה מפורטים הרכיבים, וגם מידע נוסף על הרכיבים, כולל קישורים לסרטונים קשורים, למסמכי מוצר ולמדריכים אינטראקטיביים.


סקריפטים
סקריפט ההתקנה משתמש בקובץ הפעלה שנכתב ב-go ובכלים של Terraform CLI כדי לקחת פרויקט ריק ולהתקין בו את האפליקציה. הפלט צריך להיות אפליקציה פעילה וכתובת URL לכתובת ה-IP של איזון העומסים.
./main.tf
הפעלת שירותים
שירותי Google Cloud מושבתים בפרויקט כברירת מחדל. כדי להשתמש באחד מהפתרונות שמופיעים כאן, צריך להפעיל את האפשרויות הבאות:
- IAM – ניהול זהויות וגישה למשאבים ב-Google Cloud
- Storage – שירות לאחסון נתונים ב-Google Cloud ולגישה אליהם
- Dataflow – שירות מנוהל להרצה של מגוון רחב של דפוסי עיבוד נתונים
- BigQuery – פלטפורמת נתונים ליצירה, לניהול, לשיתוף ולשאילת נתונים
- Composer – ניהול סביבות Apache Airflow ב-Google Cloud
- Compute – מכונות וירטואליות ושירותי רשת (בשימוש ב-Composer)
variable "gcp_service_list" {
  description = "The list of apis necessary for the project"
  type        = list(string)
  default = [
    "dataflow.googleapis.com",
    "compute.googleapis.com",
    "composer.googleapis.com",
    "storage.googleapis.com",
    "bigquery.googleapis.com",
    "iam.googleapis.com"
  ]
}

resource "google_project_service" "all" {
  for_each           = toset(var.gcp_service_list)
  project            = var.project_number
  service            = each.key
  disable_on_destroy = false
}
יצירת חשבון שירות
יוצר חשבון שירות לשימוש ב-Composer וב-Dataflow.
resource "google_service_account" "etl" {
  account_id   = "etlpipeline"
  display_name = "ETL SA"
  description  = "user-managed service account for Composer and Dataflow"
  project = var.project_id
  depends_on = [google_project_service.all]
}
הקצאת תפקידים
מקצה לחשבון השירות את התפקידים הנדרשים, ומקצה לסוכן השירות של Cloud Composer את התפקיד Cloud Composer v2 API Service Agent Extension (נדרש לסביבות Composer 2).
variable "build_roles_list" { description = "The list of roles that Composer and Dataflow needs" type = list(string) default = [ "roles/composer.worker", "roles/dataflow.admin", "roles/dataflow.worker", "roles/bigquery.admin", "roles/storage.objectAdmin", "roles/dataflow.serviceAgent", "roles/composer.ServiceAgentV2Ext" ] }
resource "google_project_iam_member" "allbuild" {
  project    = var.project_id
  for_each   = toset(var.build_roles_list)
  role       = each.key
  member     = "serviceAccount:${google_service_account.etl.email}"
  depends_on = [google_project_service.all,google_service_account.etl]
}

resource "google_project_iam_member" "composerAgent" {
  project    = var.project_id
  role       = "roles/composer.ServiceAgentV2Ext"
  member     = "serviceAccount:service-${var.project_number}@cloudcomposer-accounts."
  depends_on = [google_project_service.all]
}
יצירת סביבת Composer
ההפעלה של Airflow תלויה במיקרו-שירותים רבים, ולכן Cloud Composer מקצה את רכיבי Google Cloud להפעלת תהליכי העבודה. הרכיבים האלה נקראים ביחד סביבת Cloud Composer.
# Create Composer environment
resource "google_composer_environment" "example" {
  project   = var.project_id
  name      = "example-environment"
  region    = var.region
  config {

    software_config {
      image_version = "composer-2.0.12-airflow-2.2.3"
      env_variables = {
        AIRFLOW_VAR_PROJECT_ID  = var.project_id
        AIRFLOW_VAR_GCE_ZONE    = var.zone
        AIRFLOW_VAR_BUCKET_PATH = "gs://${var.basename}-${var.project_id}-files"
      }
    }
    node_config {
      service_account = google_service_account.etl.name
    }
  }
  depends_on = [google_project_service.all, google_service_account.etl, google_project_iam_member.allbuild, google_project_iam_member.composerAgent]
}
יצירת מערך נתונים וטבלה ב-BigQuery
יצירת מערך נתונים וטבלה ב-BigQuery כדי לאחסן את הנתונים המעובדים ולהפוך אותם לזמינים לניתוח.
resource "google_bigquery_dataset" "weather_dataset" {
  project    = var.project_id
  dataset_id = "average_weather"
  location   = "US"
  depends_on = [google_project_service.all]
}

resource "google_bigquery_table" "weather_table" {
  project    = var.project_id
  dataset_id = google_bigquery_dataset.weather_dataset.dataset_id
  table_id   = "average_weather"
  deletion_protection = false

  schema     = <<EOF
[
  {
    "name": "location",
    "type": "GEOGRAPHY",
    "mode": "REQUIRED"
  },
  {
    "name": "average_temperature",
    "type": "INTEGER",
    "mode": "REQUIRED"
  },
   {
    "name": "month",
    "type": "STRING",
    "mode": "REQUIRED"
  },
   {
    "name": "inches_of_rain",
    "type": "NUMERIC",
    "mode": "NULLABLE"
  },
   {
    "name": "is_current",
    "type": "BOOLEAN",
    "mode": "NULLABLE"
  },
   {
    "name": "latest_measurement",
    "type": "DATE",
    "mode": "NULLABLE"
  }
]
EOF
  depends_on = [google_bigquery_dataset.weather_dataset]
}
יצירת קטגוריות של Cloud Storage והוספת קבצים
יוצרת קטגוריית אחסון להחזקת הקבצים שנדרשים לצינור, כולל נתוני המקור (inputFile.txt), סכימת היעד (jsonSchema.json) והפונקציה שהוגדרה על ידי המשתמש להמרה (transformCSCtoJSON.js).
# Create Cloud Storage bucket and add files
resource "google_storage_bucket" "pipeline_files" {
  project       = var.project_number
  name          = "${var.basename}-${var.project_id}-files"
  location      = "US"
  force_destroy = true
  depends_on    = [google_project_service.all]
}

resource "google_storage_bucket_object" "json_schema" {
  name       = "jsonSchema.json"
  source     = "${path.module}/files/jsonSchema.json"
  bucket     = google_storage_bucket.pipeline_files.name
  depends_on = [google_storage_bucket.pipeline_files]
}

resource "google_storage_bucket_object" "input_file" {
  name       = "inputFile.txt"
  source     = "${path.module}/files/inputFile.txt"
  bucket     = google_storage_bucket.pipeline_files.name
  depends_on = [google_storage_bucket.pipeline_files]
}

resource "google_storage_bucket_object" "transform_CSVtoJSON" {
  name       = "transformCSVtoJSON.js"
  source     = "${path.module}/files/transformCSVtoJSON.js"
  bucket     = google_storage_bucket.pipeline_files.name
  depends_on = [google_storage_bucket.pipeline_files]
}
העלאת קובץ DAG
קודם משתמשים במקור נתונים כדי לקבוע את הנתיב המתאים לקטגוריה של Cloud Storage להוספת קובץ ה-DAG, ואז מוסיפים את קובצי ה-DAG לקטגוריה. קובץ ה-DAG מגדיר את תהליכי העבודה, התלות והתזמונים של Airflow כדי לתזמר את צינור עיבוד הנתונים.
data "google_composer_environment" "example" {
  project    = var.project_id
  region     = var.region
  name       = google_composer_environment.example.name
  depends_on = [google_composer_environment.example]
}

resource "google_storage_bucket_object" "dag_file" {
  name       = "dags/composer-dataflow-dag.py"
  source     = "${path.module}/files/composer-dataflow-dag.py"
  bucket     = replace(replace(data.google_composer_environment.example.config.0.dag_gcs_prefix, "gs://", ""),"/dags","")
  depends_on = [google_composer_environment.example, google_storage_bucket.pipeline_files, google_bigquery_table.weather_table]
}
סיכום
אחרי ההרצה, אמורה להיות לכם סביבת Composer שהוגדרה להרצת משימות ETL על הנתונים שמוצגים בדוגמה. בנוסף, צריך שיהיה לכם את כל הקוד כדי לשנות או להרחיב את הפתרון הזה כך שיתאים לסביבה שלכם.