


Auf dieser Seite finden Sie eine Übersicht über Fehler vom Typ „Frist überschritten“ in Spanner: was sie sind, warum sie auftreten und wie Sie sie beheben können.
Beim Zugriff auf Spanner APIs können Anfragen aufgrund von DEADLINE_EXCEEDED-Fehlern fehlschlagen. Dieser Fehler weist darauf hin, dass innerhalb des konfigurierten Zeitlimits keine Antwort empfangen wurde.
Ein Fehler vom Typ „Frist überschritten“ kann aus vielen verschiedenen Gründen auftreten, z. B. aufgrund überlasteter Spanner-Instanzen, nicht optimierter Schemas oder nicht optimierter Abfragen. Auf dieser Seite werden häufige Szenarien beschrieben, in denen ein Fehler vom Typ „Frist überschritten“ auftritt. Außerdem finden Sie hier eine Anleitung zur Untersuchung und Behebung dieser Probleme.
Fristen und Wiederholungsversuche in Spanner
Die Frist- und Wiederholungsphilosophie von Spanner unterscheidet sich von vielen anderen Systemen. In Spanner sollten Sie eine Zeitüberschreitungsfrist als maximale Zeitspanne angeben, in der eine Antwort nützlich ist. Es wird nicht empfohlen, eine künstlich kurze Frist festzulegen, nur um denselben Vorgang sofort noch einmal zu wiederholen, da dies dazu führt, dass Vorgänge nie abgeschlossen werden. In diesem Zusammenhang werden die folgenden Strategien und Vorgänge nicht empfohlen. Sie sind kontraproduktiv und verhindern das interne Wiederholungsverhalten von Spanner:
Eine zu kurze Frist festlegen. Das bedeutet, dass der Vorgang nicht gegen gelegentliche Erhöhungen der Tail-Latenz resistent ist und nicht abgeschlossen werden kann, bevor ein Zeitüberschreitungsfehler auftritt. Legen Sie stattdessen eine Frist fest, die der maximalen Zeit entspricht, in der eine Antwort nützlich ist.
Festlegen einer zu langen Frist und Abbrechen des Vorgangs, bevor die Frist überschritten wird. Dies führt zu Wiederholungsversuchen und verschwendeter Arbeit bei jedem Versuch. Insgesamt kann dies zu einer erheblichen zusätzlichen Last auf Ihrer Instanz führen.
Was ist ein Fehler vom Typ „Frist überschritten“?
Wenn Sie eine der Spanner-Clientbibliotheken verwenden, übernimmt die zugrunde liegende gRPC-Ebene die Kommunikation, das Marshalling, das Unmarshalling und die Durchsetzung von Fristen. Mit Fristen können Sie in Ihrer Anwendung angeben, wie lange auf den Abschluss einer Anfrage gewartet werden soll, bevor die Anfrage mit dem Fehler „Frist überschritten“ beendet wird.
In der Anleitung zur Zeitüberschreitungskonfiguration wird gezeigt, wie Sie in jeder der unterstützten Spanner-Clientbibliotheken Fristen (oder Zeitüberschreitungen) angeben können. Die Spanner-Clientbibliotheken verwenden die Standardeinstellungen für Zeitüberschreitungen und Wiederholungsrichtlinien, die in den folgenden Konfigurationsdateien definiert sind:
- spanner_grpc_service_config.json
- spanner_admin_instance_grpc_service_config.json
- spanner_admin_database_grpc_service_config.json
Weitere Informationen zu gRPC-Fristen finden Sie unter gRPC und Fristen.
Häufige Fehler vom Typ „Frist überschritten“ untersuchen und beheben
Bei den folgenden Problemtypen können DEADLINE_EXCEEDED-Fehler auftreten:
- Probleme mit der Data Access API
- Probleme mit der Data API
- Probleme mit der Admin API
- Google Cloud Console-Probleme
- Dataflow-Probleme
Probleme mit der Data Access API
Eine Spanner-Instanz muss für Ihre spezifischen Arbeitslasten entsprechend konfiguriert sein, um Probleme mit der Datenzugriffs-API zu vermeiden. In den folgenden Abschnitten wird beschrieben, wie Sie verschiedene Probleme mit der Datenzugriffs-API untersuchen und beheben können.
CPU-Last der Spanner-Instanz prüfen
Die Anfragelatenz kann erheblich steigen, wenn die CPU-Auslastung den empfohlenen Schwellenwert überschreitet. Sie können die CPU-Auslastung von Cloud Spanner in der Monitoring-Konsole in der Google Cloud Console prüfen. Sie können auch Benachrichtigungen basierend auf der CPU-Auslastung der Instanz erstellen.
Lösung
Eine Anleitung zum Reduzieren der CPU-Auslastung der Instanz finden Sie unter CPU-Auslastung reduzieren.
End-to-End-Latenzaufschlüsselung der Anfrage prüfen
Wenn eine Anfrage vom Client an die Spanner-Server und zurück gesendet wird, müssen mehrere Netzwerksprünge ausgeführt werden: von der Clientbibliothek zum Google Front End (GFE), vom GFE zum Spanner API-Frontend und schließlich vom Spanner API-Frontend zur Spanner-Datenbank. Wenn in einer dieser Phasen Netzwerkprobleme auftreten, werden möglicherweise Fehler vom Typ „Frist überschritten“ angezeigt.
Es ist möglich, die Latenz in jeder Phase zu erfassen. Weitere Informationen finden Sie unter Latenzpunkte in einer Spanner-Anfrage. Informationen dazu, wo in Spanner Latenz auftritt, finden Sie unter Latenzursachen in Spanner identifizieren.
Lösung
Sobald Sie die Latenzaufschlüsselung erhalten haben, können Sie Messwerte verwenden, um die Latenz zu diagnostizieren, die Ursache zu verstehen und Lösungen zu finden.
Probleme mit der Data API
Bestimmte nicht optimale Nutzungsmuster der Data API von Spanner können zu Fehlern vom Typ „Frist überschritten“ führen. In diesem Abschnitt finden Sie Richtlinien, wie Sie nach diesen nicht optimalen Nutzungsmustern suchen können.
Nach ressourcenintensiven Abfragen suchen
Wenn Sie versuchen, ressourcenintensive Abfragen auszuführen, die nicht innerhalb der konfigurierten Zeitüberschreitung in den Clientbibliotheken ausgeführt werden, kann dies zu einem Fehler vom Typ „Frist überschritten“ führen. Beispiele für ressourcenintensive Abfragen sind unter anderem vollständige Scans einer großen Tabelle, Cross Joins über mehrere große Tabellen oder eine Abfrageausführung mit einem Prädikat über eine Nicht-Schlüsselspalte (ebenfalls ein vollständiger Tabellenscan).
Sie können teure Abfragen mithilfe der Abfragestatistiktabelle und der Transaktionsstatistiktabelle prüfen. Diese Tabellen enthalten Informationen zu langsam ausgeführten Abfragen und Transaktionen, z. B. die durchschnittliche Anzahl der gelesenen Zeilen, die durchschnittliche Anzahl der gelesenen Byte, die durchschnittliche Anzahl der gescannten Zeilen und mehr. Außerdem können Sie Abfrageausführungspläne generieren, um die Ausführung Ihrer Abfragen genauer zu untersuchen.
Lösung
Informationen zum Optimieren Ihrer Abfragen finden Sie im Leitfaden zu Best Practices für SQL-Abfragen. Sie können auch die Daten aus den zuvor erwähnten Statistiktabellen und Ausführungsplänen verwenden, um Ihre Abfragen zu optimieren und Schemaänderungen an Ihren Datenbanken vorzunehmen. Mit diesen Best Practices können Sie die Ausführungszeit der Anweisungen verkürzen und so möglicherweise Fehler aufgrund von Fristüberschreitungen vermeiden.
Auf Sperrkonflikte prüfen
Spanner-Transaktionen müssen Sperren erwerben, um einen Commit auszuführen. Anwendungen mit hohem Durchsatz können dazu führen, dass Transaktionen um dieselben Ressourcen konkurrieren. Dies führt zu einer längeren Wartezeit für das Abrufen der Sperren und beeinträchtigt die Gesamtleistung. Dies kann dazu führen, dass Fristen für Lese- oder Schreibanfragen überschritten werden.
Die Ursache für Lese-/Schreibtransaktionen mit hoher Latenz können Sie mithilfe der Tabelle mit Sperrstatistiken und dem folgenden Blogpost ermitteln. In der Tabelle mit den Sperrstatistiken finden Sie die Zeilenschlüssel mit den höchsten Sperrwartezeiten.
In diesem Leitfaden zur Fehlerbehebung bei Sperrkonflikten wird erläutert, wie Sie die Transaktionen finden, die auf die am Sperrkonflikt beteiligten Spalten zugreifen. Mithilfe des Leitfadens zur Fehlerbehebung mit Transaktions-Tags können Sie auch herausfinden, welche Transaktionen an einem Sperrkonflikt beteiligt sind.
Lösung
Wenden Sie diese Best Practices an, um Sperrkonflikte zu reduzieren. Verwenden Sie außerdem schreibgeschützte Transaktionen für reine Lesevorgänge, um Sperrkonflikte mit Schreibvorgängen zu vermeiden. Lese-/Schreibtransaktionen sollten für Schreibvorgänge oder gemischte Lese-/Schreib-Workflows reserviert werden. Wenn Sie diese Schritte ausführen, sollte sich die Gesamtlatenz der Transaktionsausführungszeit verbessern und die Anzahl der Fehler vom Typ „Frist überschritten“ verringern.
Auf nicht optimierte Schemas prüfen
Bevor Sie ein optimales Datenbankschema für Ihre Spanner-Datenbank entwerfen, sollten Sie sich überlegen, welche Arten von Abfragen in Ihrer Datenbank ausgeführt werden sollen. Suboptimale Schemas können bei der Ausführung einiger Abfragen zu Leistungsproblemen führen. Diese Leistungsprobleme können dazu führen, dass Anfragen nicht innerhalb der konfigurierten Frist abgeschlossen werden.
Lösung
Das optimale Schemadesign hängt von den Lese- und Schreibvorgängen in Ihrer Datenbank ab. Die Leitfäden zu Best Practices für das Schemadesign und Best Practices für SQL sollten unabhängig von den Schemaspezifika befolgt werden. Wenn Sie diese Anleitungen befolgen, vermeiden Sie die häufigsten Probleme beim Schemadesign. Andere Ursachen für eine schlechte Leistung sind die Auswahl der Primärschlüssel, das Tabellenlayout (siehe Verschachtelte Tabellen für schnelleren Zugriff verwenden), das Schemadesign (siehe Schema für Leistung optimieren) und die Leistung des Knotens, der in Ihrer Spanner-Instanz konfiguriert ist (siehe Leistungsübersicht für Spanner).
Auf Hotspots prüfen
Da Cloud Spanner eine verteilte Datenbank ist, muss das Schemadesign Hotspots verhindern. Wenn Sie beispielsweise monoton steigende Spalten erstellen, wird die Anzahl der Aufteilungen begrenzt, mit denen Spanner die Arbeitslast gleichmäßig verteilen kann. Diese Engpässe können zu Zeitüberschreitungen führen. Außerdem können Sie mit dem Key Visualizer Leistungsprobleme beheben, die durch Hotspots verursacht werden.
Lösung
Sehen Sie sich die im vorherigen Abschnitt Nicht optimierte Schemas prüfen beschriebenen Lösungen an, um dieses Problem zu beheben. Gestalten Sie Ihr Datenbankschema neu und verwenden Sie verschachtelte Indexe, um Indexe zu vermeiden, die Hotspotting verursachen könnten. Wenn das Problem durch diese Schritte nicht behoben wird, lesen Sie den Leitfaden zur Auswahl eines Primärschlüssels, um Hotspots zu vermeiden. Vermeiden Sie außerdem suboptimale Trafficmuster wie Lesevorgänge in großen Bereichen, die eine lastbasierte Aufteilung verhindern könnten.
Auf falsch konfigurierte Zeitlimits prüfen
Die Clientbibliotheken bieten angemessene Standard-Zeitlimits für alle Anfragen in Spanner. Diese Standardkonfigurationen müssen jedoch möglicherweise für Ihre spezifische Arbeitslast angepasst werden. Es lohnt sich, die Kosten Ihrer Abfragen zu beobachten und die Fristen an Ihren spezifischen Anwendungsfall anzupassen.
Lösung
Die Standardeinstellungen für Zeitlimits sind für die meisten Anwendungsfälle geeignet. Nutzer können diese Konfigurationen überschreiben (siehe Anleitung zu benutzerdefinierten Zeitüberschreitungen und Wiederholungsversuchen). Es wird jedoch nicht empfohlen, aggressivere Zeitüberschreitungen als die Standardwerte zu verwenden. Wenn Sie das Zeitlimit ändern möchten, legen Sie es auf die tatsächliche Zeit fest, die die Anwendung auf das Ergebnis warten soll. Sie können mit längeren konfigurierten Zeitlimits experimentieren, aber legen Sie nie ein Zeitlimit fest, das kürzer ist als die tatsächliche Zeit, die die Anwendung bereit ist zu warten, da dies dazu führen würde, dass der Vorgang häufiger wiederholt wird.
Probleme mit der Admin API
Admin API-Anfragen sind im Vergleich zu Data API-Anfragen rechenintensiv.
Bei Administratoranfragen wie CreateInstance, CreateDatabase oder CreateBackups kann es viele Sekunden dauern, bis eine Antwort zurückgegeben wird. Spanner-Clientbibliotheken legen für Administratoranfragen für Instanzen und Datenbanken eine Frist von 60 Minuten fest. So hat der Server die Möglichkeit, die Anfrage abzuschließen, bevor der Client einen neuen Versuch unternimmt oder fehlschlägt.
Lösung
Wenn Sie die Spanner-Clientbibliothek von Google für den Zugriff auf die Administrator API verwenden, muss die Clientbibliothek auf dem neuesten Stand sein. Wenn Sie direkt über eine von Ihnen erstellte Clientbibliothek auf die Spanner API zugreifen, achten Sie darauf, dass Sie für Ihre Instanz- und Datenbank-Administratoranfragen keine strengeren Fristeinstellungen als die Standardeinstellungen (60 Minuten) haben.
Probleme mit derGoogle Cloud Console
Abfragen, die über die Spanner Studio-Seite der Google Cloud Console ausgegeben werden, dürfen fünf Minuten nicht überschreiten. Wenn Sie eine ressourcenintensive Abfrage erstellen, deren Ausführung länger als fünf Minuten dauert, wird die folgende Fehlermeldung angezeigt:
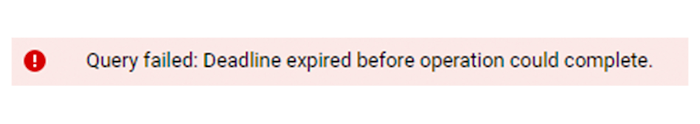
Das Backend bricht die fehlgeschlagene Abfrage ab und die Transaktion wird bei Bedarf zurückgesetzt.
Lösung
Sie können die Abfrage mithilfe des Leitfadens zu Best Practices für SQL-Abfragen umschreiben.
Dataflow-Probleme
In Apache Beam beträgt die Standard-Zeitüberschreitungskonfiguration zwei Stunden für Lesevorgänge und 15 Sekunden für Commit-Vorgänge. Diese Konfigurationen ermöglichen längere Vorgänge im Vergleich zu den Zeitlimits für die eigenständige Clientbibliothek. Es ist jedoch weiterhin möglich, dass ein Zeitüberschreitungs- und Fristüberschreitungsfehler auftritt, wenn die Arbeitselemente zu groß sind. Bei Bedarf können Sie die Apache Beam-Commit-Zeitüberschreitungskonfiguration anpassen.
Lösung
Wenn in den Schritten ReadFromSpanner / Execute
query / Read from Spanner / Read from Partitions ein Fehler vom Typ „Frist überschritten“ auftritt, sehen Sie in der Tabelle mit Abfragestatistiken nach, welche Abfrage eine große Anzahl von Zeilen gescannt hat. Ändern Sie dann diese Abfragen, um die Ausführungszeit zu verkürzen.
Ein weiteres Beispiel für einen Fehler aufgrund einer überschrittenen Dataflow-Frist wird in der folgenden Ausnahmemeldung angezeigt:
exception:
     org.apache.beam.sdk.util.UserCodeException:
     com.google.cloud.spanner.SpannerException: DEADLINE_EXCEEDED:
     io.grpc.StatusRuntimeException: DEADLINE_EXCEEDED: deadline exceeded after
     3599.999905380s.
     [remote_addr=batch-spanner.googleapis.com/172.217.5.234:443] at
 org.apache.beam.runners.dataflow.worker.GroupAlsoByWindowsParDoFn$1.output(GroupAlsoByWindowsParDoFn.java:184)
Diese Zeitüberschreitung ist aufgetreten, weil die Arbeitselemente zu groß sind. Im vorherigen Beispiel könnten die folgenden beiden Empfehlungen hilfreich sein. Zuerst können Sie versuchen, den Shuffle-Dienst zu aktivieren, falls er noch nicht aktiviert ist. Zweitens können Sie versuchen, die Konfigurationen im Lesevorgang Ihrer Datenbank anzupassen, z. B. maxPartitions und partitionSizeBytes. Weitere Informationen finden Sie unter PartitionOptions, um die Größe des Arbeitselements zu reduzieren. Ein Beispiel dafür finden Sie in dieser Dataflow-Vorlage.
Zusätzliche Ressourcen zur Fehlerbehebung bei Fristüberschreitungen
Wenn Sie nach Abschluss der Schritte zur Fehlerbehebung immer noch einen DEADLINE_EXCEEDED-Fehler sehen, öffnen Sie eine Supportanfrage, wenn die folgenden Szenarien auftreten:
- Eine hohe Google Front End-Latenz, aber eine niedrige Spanner API-Anfragelatenz
- Eine hohe Latenz für Cloud Spanner API-Anfragen, aber eine niedrige Abfragelatenz
Weitere Informationen zur Fehlerbehebung finden Sie in den folgenden Ressourcen: