


Übersicht
Auf dieser Seite werden die Konzepte hinter Abfrageausführungsplänen erläutert und wie Spanner sie zum Ausführen von Abfragen in einer verteilten Umgebung verwendet. Informationen zum Abrufen eines Ausführungsplans für eine bestimmte Abfrage mit derGoogle Cloud Console finden Sie unter So werden Abfragen von Spanner ausgeführt. Sie können sich auch Stichproben von Abfrageplänen aus der Vergangenheit ansehen, um die Abfrageleistung im Zeitverlauf zu vergleichen. Weitere Informationen finden Sie unter Abfragepläne mit Stichproben.
Spanner verwendet deklarative SQL-Anweisungen, um seine Datenbanken abzufragen. SQL-Anweisungen definieren, was der Nutzer möchte, ohne anzugeben, wie die Ergebnisse abgerufen werden sollen. Ein Abfrageausführungsplan beinhaltet eine Reihe von Schritten, mit denen die Ergebnisse erzielt werden sollen. Bei einer gegebenen SQL-Anweisung kann es mehrere Möglichkeiten geben, die Ergebnisse zu erhalten. Das Spanner-Abfrageoptimierungstool wertet verschiedene Ausführungspläne aus und wählt den effizientesten aus. Spanner verwendet dann den Ausführungsplan, um die Ergebnisse abzurufen. Ausführungspläne unterstützen Datenbanken im GoogleSQL-Dialekt und Datenbanken im PostgreSQL-Dialekt.
Weitere Informationen zum Abfrageoptimierer finden Sie unter Übersicht über den Abfrageoptimierer.
Das Konzept eines Abfrageausführungsplans ist eine Struktur relationaler Operatoren. Jeder Operator liest Zeilen aus seinen Eingaben und erzeugt Ausgabezeilen. Das Ergebnis des Operators am Stammverzeichnis der Ausführung wird als Ergebnis der SQL-Abfrage zurückgegeben.
Betrachten Sie beispielsweise die folgende Abfrage:
SELECT s.SongName FROM Songs AS s;
Diese Abfrage führt zu einem Abfrageausführungsplan, der so visualisiert werden kann:
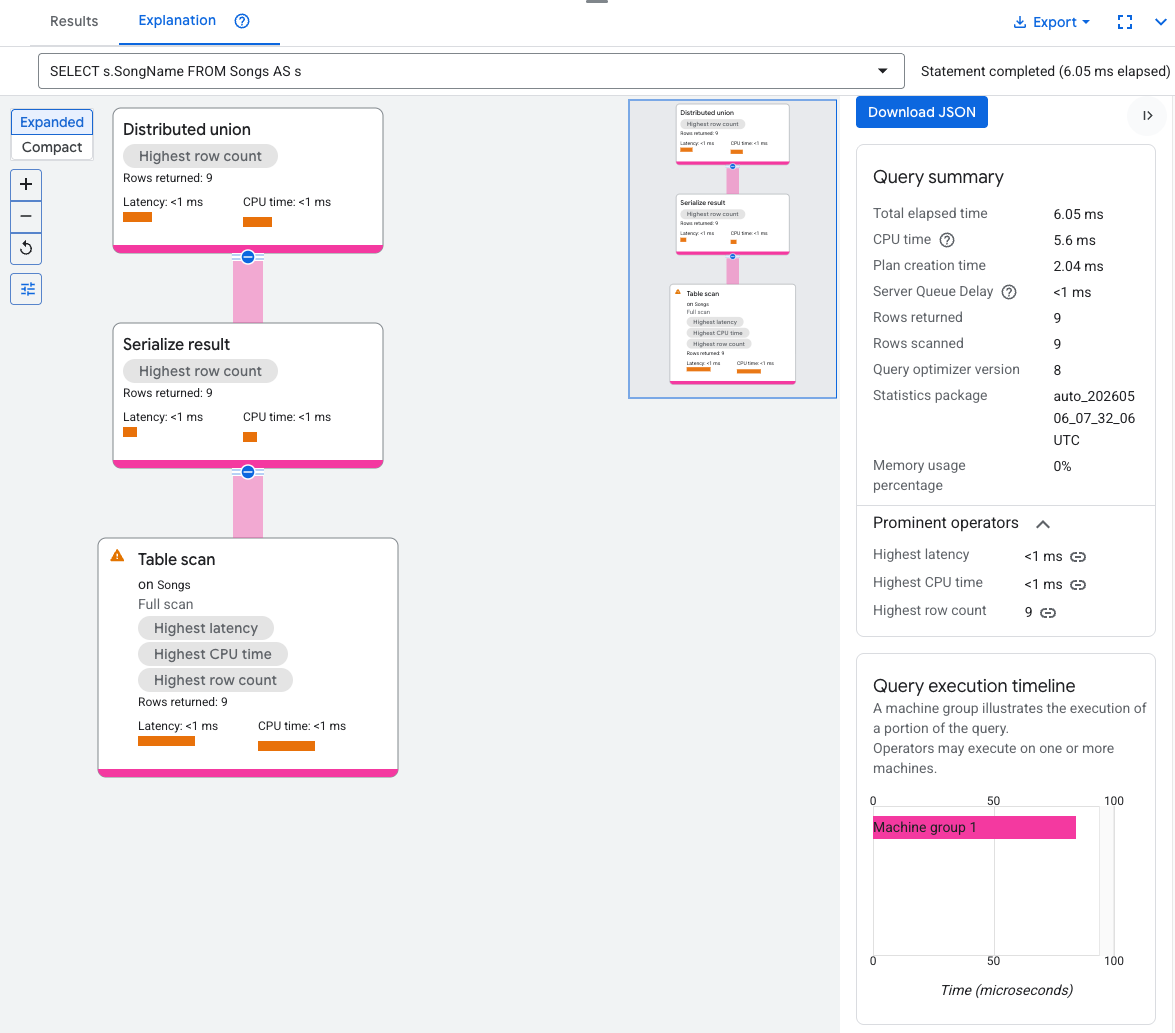
In diesem Beispiel führt Spanner den Abfrageplan von oben nach unten aus und die Daten fließen von unten nach oben. Der Operator distributed union wird zuerst ausgeführt. Die gestrichelten blauen Linien weisen darauf hin, dass dieser Operator einen Remote-Aufruf ausführen kann. Unabhängig davon, ob lokal oder remote, wird der Operator serialize result aufgerufen und die Ausführung im Baum fortgesetzt. Wenn der Operator table scan eine Zeile erzeugt, gibt er die Steuerung sofort an den Operator serialize result zurück. Dieser Vorgang wird fortgesetzt, bis die Abfrage alle Zeilen gescannt hat.
Die Abfragen und Ausführungspläne auf dieser Seite basieren auf dem folgenden Datenbankschema:
CREATE TABLE Singers (
  SingerId   INT64 NOT NULL,
  FirstName  STRING(1024),
  LastName   STRING(1024),
  SingerInfo BYTES(MAX),
  BirthDate  DATE
) PRIMARY KEY(SingerId);

CREATE INDEX SingersByFirstLastName ON Singers(FirstName, LastName);

CREATE TABLE Albums (
  SingerId        INT64 NOT NULL,
  AlbumId         INT64 NOT NULL,
  AlbumTitle      STRING(MAX),
  MarketingBudget INT64
) PRIMARY KEY(SingerId, AlbumId),
  INTERLEAVE IN PARENT Singers ON DELETE CASCADE;

CREATE INDEX AlbumsByAlbumTitle ON Albums(AlbumTitle);

CREATE INDEX AlbumsByAlbumTitle2 ON Albums(AlbumTitle) STORING (MarketingBudget);

CREATE TABLE Songs (
  SingerId  INT64 NOT NULL,
  AlbumId   INT64 NOT NULL,
  TrackId   INT64 NOT NULL,
  SongName  STRING(MAX),
  Duration  INT64,
  SongGenre STRING(25)
) PRIMARY KEY(SingerId, AlbumId, TrackId),
  INTERLEAVE IN PARENT Albums ON DELETE CASCADE;

CREATE INDEX SongsBySingerAlbumSongNameDesc ON Songs(SingerId, AlbumId, SongName DESC), INTERLEAVE IN Albums;

CREATE INDEX SongsBySongName ON Songs(SongName);

CREATE TABLE Concerts (
  VenueId      INT64 NOT NULL,
  SingerId     INT64 NOT NULL,
  ConcertDate  DATE NOT NULL,
  BeginTime    TIMESTAMP,
  EndTime      TIMESTAMP,
  TicketPrices ARRAY<INT64>
) PRIMARY KEY(VenueId, SingerId, ConcertDate);
Sie können die folgenden DML-Anweisungen (Data Manipulation Language, Datenbearbeitungssprache) verwenden, um diesen Tabellen Daten hinzuzufügen:
INSERT INTO Singers (SingerId, FirstName, LastName, BirthDate)
VALUES (1, "Marc", "Richards", "1970-09-03"),
       (2, "Catalina", "Smith", "1990-08-17"),
       (3, "Alice", "Trentor", "1991-10-02"),
       (4, "Lea", "Martin", "1991-11-09"),
       (5, "David", "Lomond", "1977-01-29");

INSERT INTO Albums (SingerId, AlbumId, AlbumTitle)
VALUES (1, 1, "Total Junk"),
       (1, 2, "Go, Go, Go"),
       (2, 1, "Green"),
       (2, 2, "Forever Hold Your Peace"),
       (2, 3, "Terrified"),
       (3, 1, "Nothing To Do With Me"),
       (4, 1, "Play");

INSERT INTO Songs (SingerId, AlbumId, TrackId, SongName, Duration, SongGenre)
VALUES (2, 1, 1, "Let's Get Back Together", 182, "COUNTRY"),
       (2, 1, 2, "Starting Again", 156, "ROCK"),
       (2, 1, 3, "I Knew You Were Magic", 294, "BLUES"),
       (2, 1, 4, "42", 185, "CLASSICAL"),
       (2, 1, 5, "Blue", 238, "BLUES"),
       (2, 1, 6, "Nothing Is The Same", 303, "BLUES"),
       (2, 1, 7, "The Second Time", 255, "ROCK"),
       (2, 3, 1, "Fight Story", 194, "ROCK"),
       (3, 1, 1, "Not About The Guitar", 278, "BLUES");
Das Erstellen effizienter Ausführungspläne ist schwierig, da Spanner Daten in Splits unterteilt. Splits können sich unabhängig voneinander bewegen und Spanner kann sie verschiedenen Servern zuweisen, die sich an unterschiedlichen physischen Standorten befinden können. Zum Bewerten von Ausführungsplänen für verteilte Daten führt Spanner die folgenden Aufgaben aus:
- Führt Unterpläne lokal auf Servern aus, auf denen die Daten gespeichert sind.
- Orchestriert und aggregiert mehrere Remote-Ausführungen mit aggressivem Verteilungs-Pruning.
Um dieses Modell zu aktivieren, verwendet Spanner den Operator distributed union zusammen mit den Varianten distributed cross apply und distributed outer apply.
So werden Abfragen von Spanner ausgeführt
Die Abfrageausführung wird konzeptionell von oben nach unten ausgeführt und Abfrageergebnisse werden von unten nach oben ausgegeben. Im folgenden Diagramm sehen Sie dieses Muster:
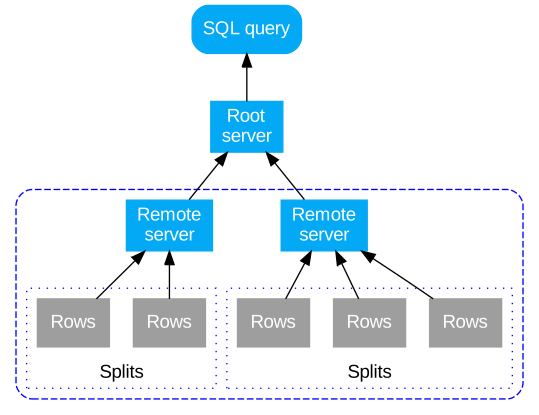
Spanner kompiliert eine SQL-Abfrage in einen Ausführungsplan. Um die Anzahl der Hops zu den abgefragten Daten zu minimieren, wählt Spanner einen anfänglichen Root-Server aus und sendet den Plan an diesen Server. Der Root-Server führt die folgenden Aktionen aus:
- Initiierung der Remote-Ausführung von Teilplänen (falls erforderlich)
- Warten auf die Ergebnisse der Remote-Ausführungen
- Verwaltung aller verbleibenden lokalen Ausführungsschritte, zum Beispiel das Aggregieren von Ergebnissen
- Gibt die Abfrageergebnisse zurück.
Ein Remote-Server, der einen Teilplan erhält, fungiert als Root-Server für seinen Teilplan und folgt demselben Modell wie der oberste Root-Server. Dieses Ausführungsmodell führt zu einer Struktur von Remote-Ausführungen.
Wichtige Leistungsmesswerte
Die Abfrageplan-Visualisierung von Spanner Studio zeigt zusammenfassende Messwerte für die Abfrageausführung an. Zusammenfassende Messwerte stellen die Gesamtheit der Messwerte aller einzelnen Operatoren dar, die während der Abfrage ausgeführt wurden. In der folgenden Tabelle werden die wichtigsten Leistungsmesswerte beschrieben:
| Messwert | Beschreibung |
|---|---|
| Insgesamt verstrichene Zeit | Die gesamte Echtzeit, die für die Ausführung der Abfrage benötigt wurde. |
| CPU-Zeit | Die gesamte CPU-Zeit, die auf allen Servern, die an der Ausführung der Abfrage beteiligt sind, verbraucht wurde. Da einige Teile der Abfrageausführung parallel ablaufen können, kann die CPU-Zeit größer als die gesamte verstrichene Zeit sein. |
Abfragepläne mit Stichproben
Mit Spanner-Abfrageplanstichproben können Sie sich Beispiele für historische Abfragepläne ansehen und die Leistung einer Abfrage im Zeitverlauf vergleichen. Stichproben-Abfragepläne sind nicht für alle Abfragen verfügbar. Spanner erfasst möglicherweise nur Abfragen, die eine erhebliche CPU-Auslastung verursachen. Spanner speichert Abfrageplanproben 30 Tage lang. Beispiele für Abfragepläne auf der Seite Query Insights derGoogle Cloud -Console finden Sie unter Beispiele für Abfragepläne ansehen.
Die Struktur eines Beispielabfrageplans ist mit der eines regulären Abfrageausführungsplans identisch. Weitere Informationen zum Verständnis visueller Pläne und zu ihrer Verwendung zum Debuggen von Abfragen finden Sie unter Einführung in die Abfrageplan-Visualisierung.
Häufige Anwendungsfälle für Abfragepläne mit Stichproben
Gängige Anwendungsfälle für Stichproben-Abfragepläne:
- Beobachten von Änderungen am Abfrageplan aufgrund von Schemaänderungen (z. B. Hinzufügen oder Entfernen eines Index).
- Änderungen am Abfrageplan aufgrund eines Updates der Optimierungsversion
- Änderungen des Abfrageplans aufgrund neuer Optimierungsstatistiken beobachten.
Spanner erfasst diese Statistiken automatisch alle drei Tage. Sie können sie aber auch manuell mit dem Befehl
ANALYZEaktualisieren.
Wenn die Abfrageleistung im Laufe der Zeit erheblich variiert oder Sie die Leistung verbessern möchten, finden Sie unter Best Practices für SQL Informationen zum Erstellen optimierter Abfrageanweisungen, mit denen Spanner effiziente Ausführungspläne finden kann.
Gängige Muster
Die folgenden Beispiele veranschaulichen gängige Muster in Spanner-Ausführungsplänen.
Aggregatabfragen
Eine Aggregationsabfrage implementiert die GROUP BY-Logik.
Mit der folgenden Abfrage wird beispielsweise die Anzahl der Songs pro Sänger berechnet:
SELECT s.SingerId, COUNT(*) AS SongCount
FROM Songs AS s
WHERE s.SingerId < 100
GROUP BY s.SingerId;
Das sind die Ergebnisse:
+----------+-----------+
| SingerId | SongCount |
+----------+-----------+
|        3 |         1 |
|        2 |         8 |
+----------+-----------+
Dies ist das Konzept des Ausführungsplans:
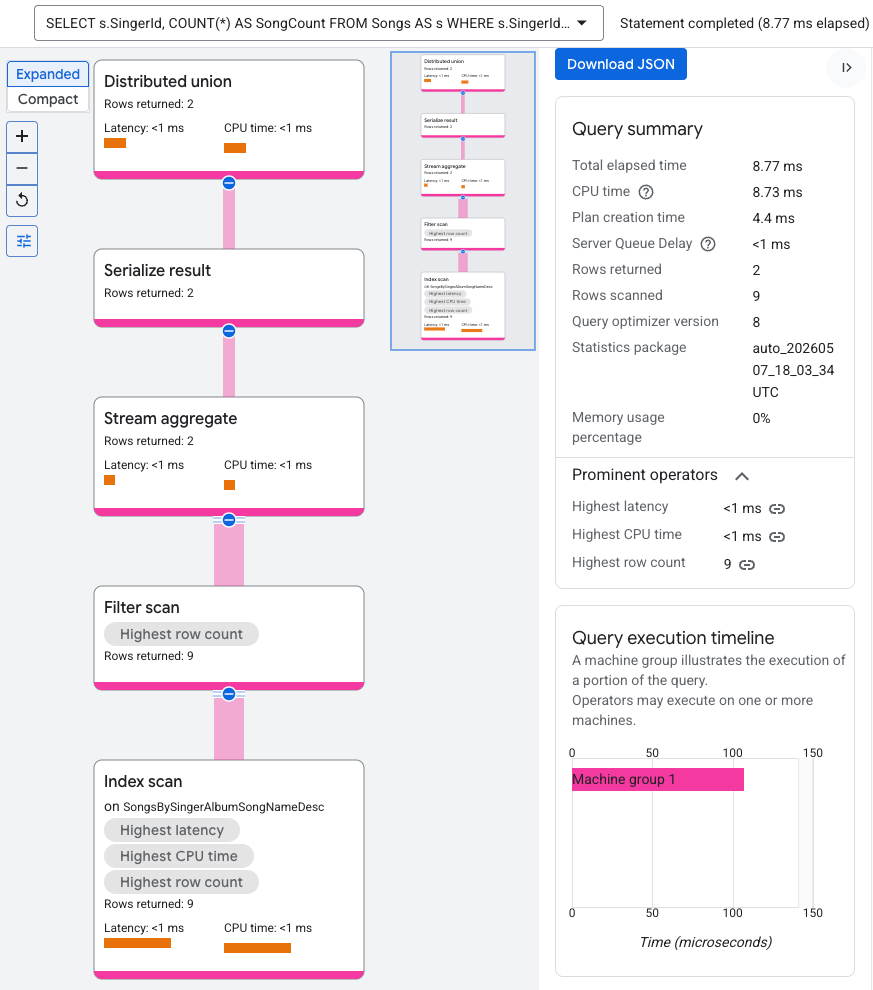
Spanner sendet den Ausführungsplan an einen Root-Server, der die Abfrageausführung koordiniert und Teilpläne remote verteilt.
Dieser Ausführungsplan beginnt mit dem Operator distributed union, der Teilpläne an Remote-Server verteilt, deren Splits SingerId < 100 erfüllen. Nachdem der Scan der einzelnen Splits abgeschlossen ist, aggregiert der Operator stream aggregate die Zeilen, um die Anzahl für jede SingerId zu erhalten. Der Operator serialize result serialisiert dann das Ergebnis. Schließlich kombiniert der distributed union alle Ergebnisse und gibt die Abfrageergebnisse zurück.
Weitere Informationen zu Aggregaten finden Sie unter Aggregatoperatoren.
Zusammengelegte Join-Abfragen
In verschachtelten Tabellen speichert Spanner zusammengehörige Zeilen physisch zusammen. Ein zusammengelegter Join ist eine Verbindung zwischen verschränkten Tabellen. Zusammengelegte Joins können die Leistung im Vergleich zu Joins verbessern, für die Indizes oder Back-Joins erforderlich sind.
Betrachten Sie beispielsweise die folgende Abfrage:
SELECT al.AlbumTitle, so.SongName
FROM Albums AS al, Songs AS so
WHERE al.SingerId = so.SingerId AND
      al.AlbumId = so.AlbumId;
Bei dieser Abfrage wird davon ausgegangen, dass Songs in Albums verschachtelt ist.
Das sind die Ergebnisse:
+-----------------------+--------------------------+
| AlbumTitle            | SongName                 |
+-----------------------+--------------------------+
| Nothing To Do With Me | Not About The Guitar     |
| Green                 | The Second Time          |
| Green                 | Starting Again           |
| Green                 | Nothing Is The Same      |
| Green                 | Let's Get Back Together  |
| Green                 | I Knew You Were Magic    |
| Green                 | Blue                     |
| Green                 | 42                       |
| Terrified             | Fight Story              |
+-----------------------+--------------------------+
Dies ist der Ausführungsplan:

Dieser Ausführungsplan beginnt mit dem Operator distributed union, der Teilpläne an Remote-Server verteilt, die Splits der Tabelle Albums enthalten. Da Songs in Albums verschachtelt ist, führt jeder Remote-Server den gesamten Teilplan lokal aus, ohne einen Join über verschiedene Server hinweg auszuführen.
Die Teilpläne enthalten einen cross apply-Operator. Jeder cross apply-Operator führt einen table scan für die Tabelle Albums aus, um SingerId, AlbumId und AlbumTitle abzurufen. Der Operator cross apply ordnet dann die Ausgabe aus dem Tabellenscan der Ausgabe eines Indexscans des Indexes SongsBySingerAlbumSongNameDesc zu.
Dieser Index unterliegt einem Filter, der erfordert, dass die SingerId im Index mit der SingerId aus der Ausgabe des Tabellenscans übereinstimmt. Jeder cross apply-Operator sendet seine Ergebnisse an einen serialize result-Operator, der die Daten von AlbumTitle und SongName serialisiert und die Ergebnisse an die lokalen verteilten Unions zurückgibt. Die „Distributed Union“ aggregiert die Ergebnisse der „Local Distributed Unions“ und gibt sie als Abfrageergebnis aus.
Index- und Back-Join-Abfragen
Im vorherigen Beispiel wird ein Join für zwei Tabellen verwendet, wobei eine Tabelle in der anderen verschachtelt ist. Wenn zwei Tabellen oder eine Tabelle und ein Index nicht verschachtelt sind, sind die Ausführungspläne komplexer und weniger effizient.
Betrachten Sie einen Index, der mit dem folgenden Befehl erstellt wurde:
CREATE INDEX SongsBySongName ON Songs(SongName);
Wählen Sie eine der folgenden Datenbankdialektoptionen aus, um diesen Index in einer Abfrage zu verwenden:
GoogleSQL
SELECT s.SongName, s.Duration
FROM Songs@{force_index=SongsBySongName} AS s
WHERE STARTS_WITH(s.SongName, "B");
PostgreSQL
SELECT s.SongName, s.Duration
FROM Songs /*@ force_index=SongsBySongName */ AS s
WHERE STARTS_WITH(s.SongName, "B");
Das sind die Ergebnisse:
+----------+----------+
| SongName | Duration |
+----------+----------+
| Blue     |      238 |
+----------+----------+
Dies ist der Ausführungsplan:
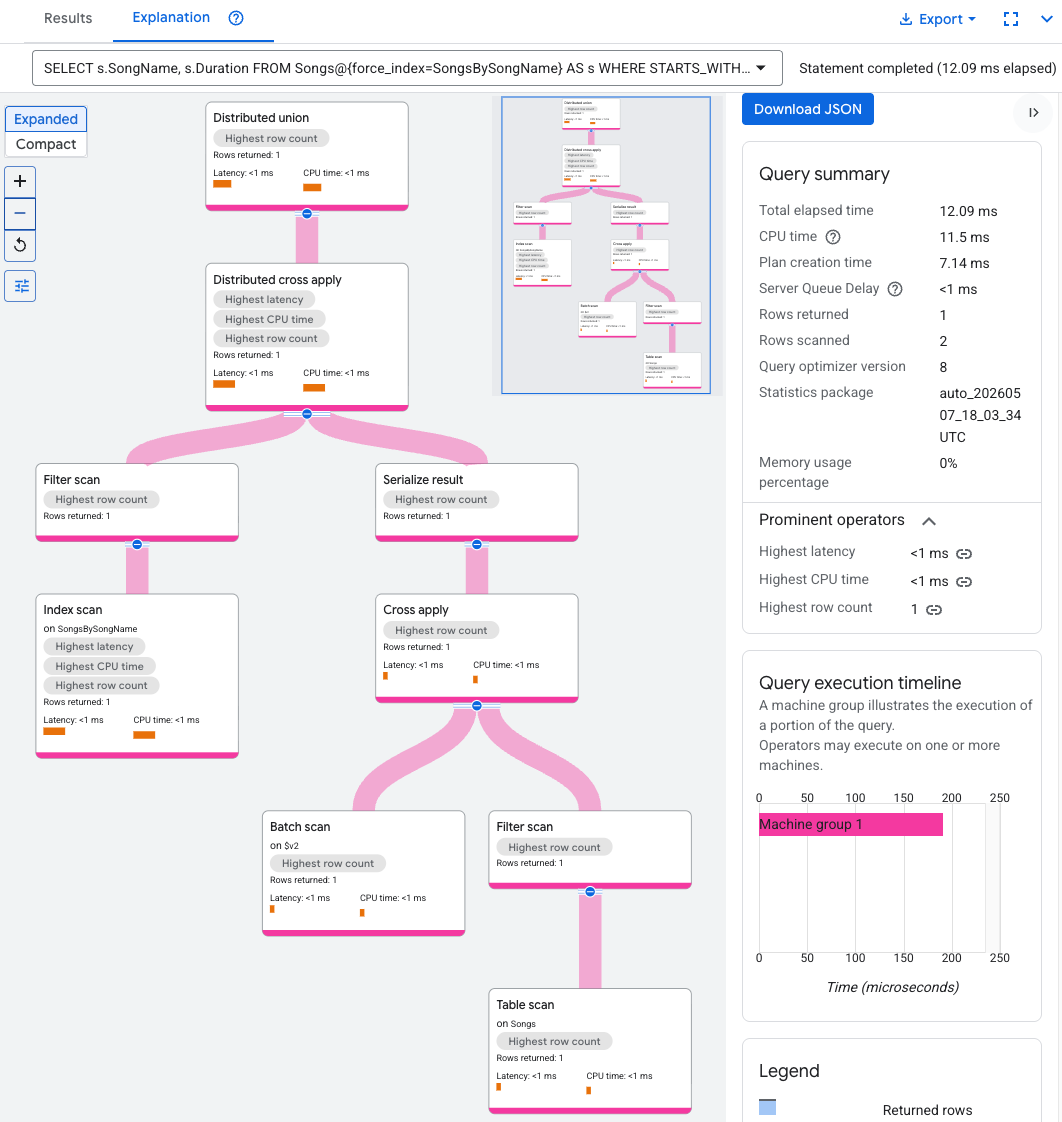
Der resultierende Ausführungsplan ist komplex, da der Index SongsBySongName die Spalte Duration nicht enthält. Um den Wert Duration abzurufen, führt Spanner einen Back-Join der indexierten Ergebnisse mit der Tabelle Songs durch. Dies ist ein Join, aber er ist nicht am selben Ort, da die Tabelle Songs und der globale Index SongsBySongName nicht verschachtelt sind. Wenn Daten nicht am selben Ort gespeichert sind, führt Spanner Optimierungen durch, um die Ausführung zu beschleunigen. Diese Optimierungen machen den Ausführungsplan komplexer als im vorherigen Beispiel für einen am selben Ort befindlichen Join.
Der oberste Operator ist ein distributed cross apply. Die Eingabeseite dieses Operators empfängt Batches von Zeilen aus dem Index SongsBySongName, die das Prädikat STARTS_WITH(s.SongName, "B") erfüllen. Der Operator distributed cross apply ordnet diese Batches dann Remote-Servern zu, die Splits mit den Duration-Daten enthalten. Zum Abrufen der Spalte Duration führen die Remote-Server einen Tabellenscan durch. Bei diesem Scan wird die Filterbedingung Condition:($Songs_key_TrackId' = $batched_Songs_key_TrackId) verwendet, die TrackId aus der Tabelle Songs mit den Spalten TrackId der Zeilen verknüpft, die aus dem Index SongsBySongName zusammengefasst wurden.
Spanner fasst die Ergebnisse zur endgültigen Abfrageantwort zusammen.
Die Eingabeseite des distributed cross apply-Operators enthält wiederum ein distributed union- oder local distributed union-Paar, um Zeilen aus dem Index auszuwerten, die das STARTS_WITH-Prädikat erfüllen.
Unten sehen Sie eine leicht abgewandelte Abfrage, bei der die Spalte s.Duration nicht ausgewählt ist:
GoogleSQL
SELECT s.SongName
FROM Songs@{force_index=SongsBySongName} AS s
WHERE STARTS_WITH(s.SongName, "B");
PostgreSQL
SELECT s.SongName
FROM Songs /*@ force_index=SongsBySongName */ AS s
WHERE STARTS_WITH(s.SongName, "B");
Der folgende Ausführungsplan zeigt, dass diese Abfrage den Index vollständig verwendet:

Für den Ausführungsplan ist kein Back-Join erforderlich, da der Index alle von der Abfrage angeforderten Spalten enthält.
Sequenzieller Scan im Vergleich zu verstreuten Suchvorgängen
Das Lesen eines zusammenhängenden Bereichs von Zeilen ist deutlich schneller als das Lesen derselben Anzahl von verstreuten Zeilen.
Die folgende Abfrage summiert beispielsweise die Dauer von Songs einer bestimmten Gruppe von Sängern. Diese Abfrage führt Suchvorgänge für jede angegebene Sänger-ID aus. Die Anzahl der Suchvorgänge, die die Abfrage ausgeführt hat, finden Sie in der Statistik Anzahl der Suchvorgänge.
SELECT SUM(Duration)
FROM Songs
WHERE SingerId IN (1, 3, 9, 10, 15);
Wenn Sie die Abfrage jedoch so strukturieren, dass eine zusammenhängende Sequenz von Sänger-IDs gelesen wird, können Sie die Leistung verbessern, indem Sie einen sequenziellen Lesevorgang der Tabelle Songs ausführen. Die Tabelle Songs enthält SingerId als Teil ihres Primärschlüssels.
SELECT SUM(Duration)
FROM Songs
WHERE SingerId BETWEEN 1 AND 5;
Dieser Unterschied ist relevant, wenn Sie eine Join-Methode auswählen und Entscheidungen zum Schemadesign treffen, z. B. bei der Auswahl eines Primärschlüssels. Weitere Informationen zur Auswahl einer Join-Methode finden Sie unter Interaktion von Joins mit Scans.
Verteilte Vereinigungen freigeben
Jede Tabelle oder jeder Index in einer Abfrage muss einen entsprechenden verteilten Operator haben.
Dieser Operator ist entweder distributed union oder ein distributed apply. Wenn zwei Tabellen oder Indexe im selben übergeordneten Element verschachtelt sind, verwendet der Abfrageoptimierer möglicherweise einen einzelnen distributed union-Operator für beide Tabellen oder Indexe.