


Nesta página, apresentamos uma visão geral dos componentes de alto nível envolvidos em uma solicitação do Spanner e como cada componente pode afetar a latência.
Solicitações da API Spanner
Os componentes de alto nível usados para fazer uma solicitação de API Spanner incluem:
Bibliotecas de cliente do Spanner, que fornecem uma camada de abstração sobre o gRPC e processam detalhes de comunicação do servidor, como gerenciamento de sessões, transações e novas tentativas.
O Google Front End (GFE), que é um serviço de infraestrutura comum a todos os serviços do Google Cloud , incluindo o Spanner. O GFE verifica se todas as conexões de Transport Layer Security (TLS) foram interrompidas e aplica proteções contra ataques de negação de serviço. Para saber mais sobre o GFE, consulte Serviço do Google Front End.
O front-end da API Spanner (AFE), que realiza várias verificações na solicitação de API (incluindo verificações de autenticação, autorização e cota) e mantém sessões e estados de transação.
O banco de dados do Spanner, que executa leituras e gravações no banco de dados.
Quando você faz uma chamada de procedimento remoto para o Spanner, as bibliotecas de cliente do Spanner preparam a solicitação de API. Em seguida, a solicitação de API passa pelo GFE e pelo AFE do Spanner antes de chegar ao banco de dados do Spanner.
Ao medir e comparar as latências de solicitação entre diferentes componentes e o banco de dados, é possível determinar qual componente está causando o problema. Essas latências incluem latências de ponta a ponta do cliente, GFE, solicitação da API Spanner e latências de consulta.

As seções a seguir explicam cada tipo de latência mostrada no diagrama anterior.
Conectividade direta
O tráfego de aplicativos que atende a determinados critérios pode ser roteado diretamente para o Spanner, ignorando o Google Front End (GFE) e otimizando o desempenho. A conectividade direta pode ser ativada para aplicativos que atendem aos seguintes critérios:
- Em execução no Compute Engine ou no Google Kubernetes Engine.
- Use o endpoint global.
- Em uma rede configurada com rotas e regras de firewall que permitem que o tráfego de saída
alcance
34.126.0.0/18e2001:4860:8040::/42. - Usa as versões da biblioteca de cliente:
- Java: 6.111.0 ou mais recente.
- Go: 1.88.0 ou mais recente.
- As credenciais usadas para os aplicativos têm a permissão
spanner.databases.get.
Esse recurso pode ser ativado definindo a
variável de ambiente GOOGLE_SPANNER_ENABLE_DIRECT_ACCESS como true
ou pela configuração da biblioteca de cliente (
setEnableDirectAccess(true)
em Java, ClientConfig.EnableDirectAccess
em Go ou propriedade de conexão enableDirectAccess=true no
driver JDBC).
Para verificar se a conectividade direta do Spanner está sendo usada, monitore os rótulos de uso nas métricas do lado do cliente.
Latência de ponta a ponta
A latência de ponta a ponta é o período (em milissegundos) entre o primeiro byte da solicitação de API Spanner que o cliente envia ao banco de dados (pelo GFE e pelo front-end da API Spanner) e o último byte de resposta que o cliente recebe do banco de dados.

A métrica
spanner.googleapis.com/client/operation_latencies
fornece o tempo entre o primeiro byte da solicitação de API
enviada e o último byte da resposta recebida. Isso inclui novas tentativas realizadas
pela biblioteca de cliente.
Para mais informações, consulte Ver e gerenciar métricas do lado do cliente.
Latência do GFE
A latência do Google Front End (GFE) é o período (em milissegundos) entre o momento em que a rede do Google recebe uma chamada de procedimento remoto do cliente e o momento em que o GFE recebe o primeiro byte da resposta. Essa latência não inclui nenhum handshake de TCP ou TLS.

Cada resposta do Spanner (REST ou gRPC) inclui um cabeçalho que contém o tempo total entre o GFE e o back-end (o serviço do Spanner) para a solicitação e a resposta. Isso ajuda a diferenciar melhor a origem da latência entre o cliente e o GFE.
A métrica spanner.googleapis.com/client/gfe_latencies
captura e expõe a latência do GFE para solicitações do Spanner.
O cliente lê a latência do GFE nos cabeçalhos de resposta. Se uma solicitação falhar ou
expirar antes que o cliente as receba (por exemplo, com um
erro DEADLINE_EXCEEDED), o cliente não registrará a latência do GFE e
incrementará a métrica
spanner.googleapis.com/client/gfe_connectivity_error_count. Ao resolver problemas de tempos limite, verifique essa métrica e a métrica
spanner.googleapis.com/client/attempt_latencies,
além da latência do GFE. Se a contagem de erros de conectividade do GFE
aumentar, as solicitações vão falhar antes que o cliente receba cabeçalhos de resposta,
mesmo que a latência do GFE pareça normal. Nesse caso, a latência pode vir de qualquer lugar entre o cliente e o back-end do Spanner.
Para mais informações, consulte Ver e gerenciar métricas do lado do cliente.
Latência de solicitação da API Spanner
A latência da solicitação de API Spanner é o período (em segundos) desde o momento em que o AFE do Spanner recebe o primeiro byte de uma solicitação até o momento em que o front-end da API Spanner envia o último byte de uma resposta. A latência inclui o tempo necessário para processar solicitações de API no back-end do Spanner e na camada de API. No entanto, essa latência não inclui a sobrecarga de rede ou de proxy reverso entre clientes e servidores do Spanner.
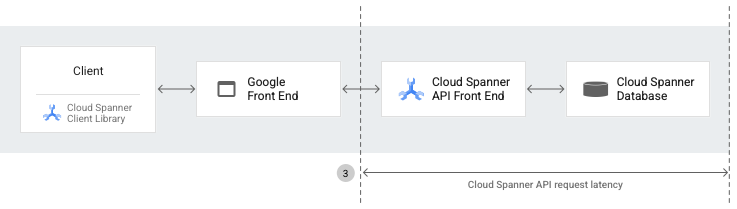
A métrica spanner.googleapis.com/api/request_latencies captura
e expõe a latência do AFE do Spanner para solicitações
do Spanner. Para mais informações, consulte
Métricas do Spanner.
Latência da consulta
A latência de consulta é o tempo (em milissegundos) que leva para executar consultas SQL no banco de dados do Spanner.

A latência de consulta está disponível para a API executeSql.
Se o parâmetro
QueryMode
estiver definido como WITH_STATS ou WITH_PLAN_AND_STATS,
as
ResultSetStats
do Spanner
vão estar disponíveis nas respostas. ResultSetStats inclui o tempo decorrido
para executar consultas no banco de dados do Spanner.
Para capturar e visualizar a latência de consulta, consulte Capturar latência de consulta com o OpenTelemetry.
A seguir
- Saiba como identificar pontos de latência nos componentes do Spanner.