


Auf dieser Seite werden Techniken zur Optimierung der Spanner-Abfrageleistung beschrieben. Bevor Sie mit der Optimierung Ihrer Abfragen beginnen, sollten Sie sich die folgenden Seiten ansehen, auf denen grundlegende Konzepte und Tools für die Abfrageoptimierung erläutert werden:
- Best Practices für SQL
- Übersicht über die Visualisierung von Abfrageplänen
- Abfragestatistiken
- Operatoren für die Abfrageausführung
Die Abfragen und Ausführungspläne auf dieser Seite basieren auf dem folgenden Datenbankschema:
CREATE TABLE Singers (
  SingerId   INT64 NOT NULL,
  FirstName  STRING(1024),
  LastName   STRING(1024),
  SingerInfo BYTES(MAX),
  BirthDate  DATE
) PRIMARY KEY(SingerId);

CREATE INDEX SingersByFirstLastName ON Singers(FirstName, LastName);

CREATE TABLE Albums (
  SingerId        INT64 NOT NULL,
  AlbumId         INT64 NOT NULL,
  AlbumTitle      STRING(MAX),
  MarketingBudget INT64
) PRIMARY KEY(SingerId, AlbumId),
  INTERLEAVE IN PARENT Singers ON DELETE CASCADE;

CREATE INDEX AlbumsByAlbumTitle ON Albums(AlbumTitle);

CREATE INDEX AlbumsByAlbumTitle2 ON Albums(AlbumTitle) STORING (MarketingBudget);

CREATE TABLE Songs (
  SingerId  INT64 NOT NULL,
  AlbumId   INT64 NOT NULL,
  TrackId   INT64 NOT NULL,
  SongName  STRING(MAX),
  Duration  INT64,
  SongGenre STRING(25)
) PRIMARY KEY(SingerId, AlbumId, TrackId),
  INTERLEAVE IN PARENT Albums ON DELETE CASCADE;

CREATE INDEX SongsBySingerAlbumSongNameDesc ON Songs(SingerId, AlbumId, SongName DESC), INTERLEAVE IN Albums;

CREATE INDEX SongsBySongName ON Songs(SongName);

CREATE TABLE Concerts (
  VenueId      INT64 NOT NULL,
  SingerId     INT64 NOT NULL,
  ConcertDate  DATE NOT NULL,
  BeginTime    TIMESTAMP,
  EndTime      TIMESTAMP,
  TicketPrices ARRAY<INT64>
) PRIMARY KEY(VenueId, SingerId, ConcertDate);
Sie können die folgenden DML-Anweisungen (Data Manipulation Language, Datenbearbeitungssprache) verwenden, um diesen Tabellen Daten hinzuzufügen:
INSERT INTO Singers (SingerId, FirstName, LastName, BirthDate)
VALUES (1, "Marc", "Richards", "1970-09-03"),
       (2, "Catalina", "Smith", "1990-08-17"),
       (3, "Alice", "Trentor", "1991-10-02"),
       (4, "Lea", "Martin", "1991-11-09"),
       (5, "David", "Lomond", "1977-01-29");

INSERT INTO Albums (SingerId, AlbumId, AlbumTitle)
VALUES (1, 1, "Total Junk"),
       (1, 2, "Go, Go, Go"),
       (2, 1, "Green"),
       (2, 2, "Forever Hold Your Peace"),
       (2, 3, "Terrified"),
       (3, 1, "Nothing To Do With Me"),
       (4, 1, "Play");

INSERT INTO Songs (SingerId, AlbumId, TrackId, SongName, Duration, SongGenre)
VALUES (2, 1, 1, "Let's Get Back Together", 182, "COUNTRY"),
       (2, 1, 2, "Starting Again", 156, "ROCK"),
       (2, 1, 3, "I Knew You Were Magic", 294, "BLUES"),
       (2, 1, 4, "42", 185, "CLASSICAL"),
       (2, 1, 5, "Blue", 238, "BLUES"),
       (2, 1, 6, "Nothing Is The Same", 303, "BLUES"),
       (2, 1, 7, "The Second Time", 255, "ROCK"),
       (2, 3, 1, "Fight Story", 194, "ROCK"),
       (3, 1, 1, "Not About The Guitar", 278, "BLUES");
Benchmark-Empfehlungen
Die zuverlässigsten Leistungsstatistiken erhalten Sie, wenn Sie einen Lasttest mit verschiedenen, zufälligen Abfrageparameterwerten von einer Google Cloud -VM-Instanz ausführen, die sich in derselben Region wie die Zielinstanz befindet.
Verlassen Sie sich nicht auf Spanner Studio oder den QueryMode.PROFILE-Modus, um Abfragen zu benchmarken, da diese Tools keine tatsächlichen Produktionsnetzwerk- und Clientumgebungen replizieren. Wenn bei einem Lasttest jedoch ein Leistungsproblem festgestellt wird, sind Abfragepläne (ob in Query Insights erfasst oder on demand in Spanner Studio ausgeführt) nützliche Tools, um dieses spezifische Problem zu untersuchen.
Abfrageausführungspläne verstehen
Im Visualizer für Abfragepläne wird ein Abfrageausführungsplan als Baumstruktur von Operatoren dargestellt. Jeder Operator liest Zeilen aus seinen untergeordneten Operatoren, verarbeitet sie und übergibt die Ergebnisse an seinen übergeordneten Operator.
Bei den meisten Operatoren im visuellen Plan ist die gemeldete Latenz additiv (sie spiegelt nur die Zeit wider, die für diesen Operator aufgewendet wurde). Bei den Operatoren Distributed union und Distributed apply ist die gemeldete Latenz jedoch kumulativ: Sie umfasst sowohl die Zeit, die im verteilten Operator selbst verbracht wurde, als auch die Zeit, die in seinen untergeordneten Operatoren verbracht wurde. Weitere Informationen zu diesen Operatoren finden Sie unter Verteilte Union und Verteilte Anwendung.
Im folgenden verteilten UNION-Plan meldet die Karte Distributed union beispielsweise eine Gesamtlatenz von 8, 46 ms, während der untergeordnete Operator Stream aggregate 3, 51 ms und Table scan 1 ms meldet. Da die Latenz von Distributed union kumulativ ist, fügt der Operator Distributed union selbst nur etwa 5 ms Latenz hinzu, nicht 8 ms:

Im nächsten Beispiel wird auf der Karte Distributed union eine Latenz von 13, 69 ms gemeldet, während die untergeordneten Operatoren (Stream aggregate mit < 1 ms, Cross apply mit 1, 14 ms, Table scan auf Albums mit < 1 ms, Filter scan mit 1 ms und Table scan auf Singers mit 10, 85 ms) etwa 13 ms ausmachen. Der Operator Distributed union selbst fügt also weniger als 1 ms Latenz hinzu, nicht 13 ms:

Sie können die kumulativen Latenzwerte auch im Bereich „Operatorzusammenfassung“ aufrufen.
Mehrere Indexe kombinieren
Wenn eine Abfrage mithilfe von OR- oder AND-Bedingungen nach mehreren indexierten Spalten filtert, kann Spanner manchmal mehrere sekundäre Indexe kombinieren, um das Scannen der gesamten Basistabelle zu vermeiden. In den Beispielen in diesem Abschnitt wird die Tabelle Albums aus dem vorherigen Beispielschema um eine Spalte ReleaseDate und einen sekundären Index AlbumsByReleaseDate erweitert:
CREATE TABLE Albums (
  SingerId        INT64 NOT NULL,
  AlbumId         INT64 NOT NULL,
  AlbumTitle      STRING(MAX),
  ReleaseDate     DATE,
  MarketingBudget INT64
) PRIMARY KEY(SingerId, AlbumId),
  INTERLEAVE IN PARENT Singers ON DELETE CASCADE;

CREATE INDEX AlbumsByAlbumTitle ON Albums(AlbumTitle);

CREATE INDEX AlbumsByReleaseDate ON Albums(ReleaseDate);
Betrachten Sie die folgende Abfrage, die eine OR-Bedingung verwendet, um nach Prädikaten aus zwei separaten sekundären Indexen (AlbumsByAlbumTitle und AlbumsByReleaseDate) zu filtern:
SELECT a.AlbumId, a.AlbumTitle, a.ReleaseDate
FROM Albums AS a
WHERE a.AlbumTitle = 'Play' OR a.ReleaseDate = '2023-09-07';
Wenn eine Abfrage eine OR-Bedingung für Prädikate aus zwei separaten Indexen enthält, kann Spanner eine kostenbasierte Optimierung verwenden, um beide Indexe zu lesen und die Ergebnisse zu kombinieren (eine Indexvereinigung). Sie können diese Optimierung auch erzwingen, indem Sie der Abfrage den Tabellenhinweis INDEX_STRATEGY=FORCE_INDEX_UNION hinzufügen:
SELECT a.AlbumId, a.AlbumTitle, a.ReleaseDate
FROM Albums@{INDEX_STRATEGY=FORCE_INDEX_UNION} AS a
WHERE a.AlbumTitle = 'Play' OR a.ReleaseDate = '2023-09-07';
Weitere Informationen zu Tabellenhinweisen finden Sie unter Tabellenhinweise.
Das folgende Ausführungsplandiagramm zeigt, wie Spanner diese OR-Bedingung (Disjunktion) auswertet, indem jeder Zweig separat gescannt und die Ergebnisse mit den Operatoren Union all und Hash aggregate kombiniert werden:

Betrachten wir als Nächstes eine Abfrage, die eine AND-Bedingung verwendet, um nach beiden indexierten Spalten zu filtern:
SELECT a.AlbumId, a.ReleaseDate, a.AlbumTitle
FROM Albums AS a
WHERE a.AlbumTitle = 'Aardvark' AND a.ReleaseDate = '2023-09-07';
Bei einer AND-Bedingung wählt Spanner standardmäßig einen einzelnen Index aus und verknüpft ihn dann bei Bedarf mit der Basistabelle, um die verbleibende Bedingung in der AND-Klausel auszuwerten. Um festzustellen, ob dieser Back-Join der Basistabelle ein Leistungsengpass ist, prüfen Sie den Abfrageausführungsplan im Visualizer: Wenn der Operator Index scan viele Zeilen zurückgibt, die anschließend nach dem Join mit dem Operator Table scan für die Basistabelle herausgefiltert werden (was zu einer hohen Latenz oder CPU-Zeit im Zweig Table scan im Verhältnis zur endgültigen Anzahl der zurückgegebenen Zeilen führt), ist der Back-Join ein Engpass.
Wenn der Back-Join der Basistabelle der Engpass für die Abfrage ist, wird empfohlen, die zusätzliche Spalte in der AND-Bedingung der STORING-Klausel des sekundären Index hinzuzufügen, damit Spanner beide Bedingungen direkt aus dem Index auswerten kann, ohne die Basistabelle zu lesen:
CREATE INDEX AlbumsByAlbumTitleStoringReleaseDate
  ON Albums(AlbumTitle)
  STORING (ReleaseDate);
Wenn eine Änderung des Index nicht möglich ist, können Sie die Abfrage so umschreiben, dass mit INTERSECT DISTINCT eine Schnittmenge beider Indexe erstellt wird. Anschließend können Sie die übereinstimmenden Primärschlüssel wieder mit der Basistabelle Albums verknüpfen:
SELECT union_a.AlbumId, a.ReleaseDate, a.AlbumTitle FROM
  (SELECT a1.SingerId, a1.AlbumId
  FROM Albums @{force_index=AlbumsByReleaseDate} AS a1
  WHERE a1.ReleaseDate = '2023-09-07'
  INTERSECT DISTINCT
  SELECT a2.SingerId, a2.AlbumId
  FROM Albums @{force_index=AlbumsByAlbumTitle} AS a2
  WHERE a2.AlbumTitle = 'Aardvark') AS union_a
JOIN Albums AS a
  ON a.SingerId = union_a.SingerId AND a.AlbumId = union_a.AlbumId;
Das folgende Ausführungsplandiagramm zeigt die umgeschriebene Abfrage. Beachten Sie, dass der Plan zwei Index scan-Operatoren (on AlbumsByAlbumTitle und on AlbumsByReleaseDate) verwendet, um die sich überschneidenden Schlüssel zu finden, bevor der Table scan für die Basistabelle Albums ausgeführt wird:

Wenn das Filtern über mehrere Spalten hinweg ein häufiges Muster in Ihrer Arbeitslast ist, sollten Sie die mehrspaltige Volltextsuche anstelle von sekundären Indexen verwenden. Weitere Informationen finden Sie unter Suche in mehreren Spalten durchführen.
Joins optimieren
Wenn Spanner eine Abfrage ausführt, die mehrere Tabellen verknüpft, wählt der Abfrageoptimierer sowohl die Join-Reihenfolge (die Reihenfolge, in der Tabellen verknüpft werden) als auch die Join-Methode (den Algorithmus, der zum Kombinieren von Zeilen aus zwei Eingaben verwendet wird, z. B. ein Apply-Join, Hash-Join oder Merge-Join) aus. Wenn eine Abfrage mit einem Join langsamer als erwartet ist, können Sie mit einem Abfragehinweis Spanner anweisen, eine andere Join-Reihenfolge oder Join-Methode zu verwenden. Dadurch wird der Ausführungsplan geändert, nicht jedoch die zurückgegebenen Ergebnisse. Beispiel:
GoogleSQL
Reihenfolge für erzwungenen Join:
SELECT *
FROM Singers AS s JOIN@{FORCE_JOIN_ORDER=TRUE} Albums AS a
ON s.SingerId = a.SingerId
WHERE s.LastName LIKE '%x%' AND a.AlbumTitle LIKE '%love%';
Beitrittsart ändern:
SELECT *
FROM Singers AS s JOIN@{JOIN_METHOD=HASH_JOIN} Albums AS a
ON s.SingerId = a.SingerId;
PostgreSQL
Reihenfolge für erzwungenen Join:
SELECT *
FROM Singers AS s JOIN/*@ FORCE_JOIN_ORDER=TRUE */ Albums AS a
ON s.SingerId = a.SingerId
WHERE s.LastName LIKE '%x%' AND a.AlbumTitle LIKE '%love%';
Beitrittsart ändern:
SELECT *
FROM Singers AS s JOIN/*@ JOIN_METHOD=HASH_JOIN */ Albums AS a
ON s.SingerId = a.SingerId;
In den folgenden Abschnitten finden Sie Hintergrundinformationen, die Ihnen helfen können, zu bestimmen, welche Join-Reihenfolgen und Join-Methoden die Abfrageleistung verbessern können.
Beitrittsmethode und Scans
Spanner unterstützt mehrere Join-Methoden. Die Wahl der Join-Methode wirkt sich direkt darauf aus, wie Spanner die zugrunde liegenden Tabellen oder Indexe scannt:
- Apply Join (in einigen Systemen als Lookup Join oder Nested Loop Join bezeichnet): Führt die rechte Seite („Zuordnung“) einmal für jede Zeile auf der linken Seite („Eingabe“) aus. Da bei jeder Suche auf der rechten Seite Werte aus der aktuellen Zeile auf der linken Seite verwendet werden, können die Join-Spalten von links als Suchschlüssel auf der rechten Seite verwendet werden. Ein verteilter Apply-Join funktioniert ähnlich wie ein lokaler Apply-Join, fasst jedoch Zeilen zusammen, um die Kommunikation über Splits in einem verteilten Join effizienter zu gestalten.
- Hash-Join: Liest Zeilen aus einer Eingabe, um eine speicherinterne Hash-Tabelle für die Join-Schlüssel zu erstellen, und scannt dann die andere Eingabe, um die Hash-Tabelle auf Übereinstimmungen zu prüfen.
- Merge Join: Liest beide Eingaben in sortierter Reihenfolge nach den Join-Schlüsseln und führt übereinstimmende Zeilen in einem einzigen Durchgang zusammen.
Betrachten Sie beispielsweise die folgende Abfrage, die Singers und Albums verknüpft:
SELECT s.*, a.AlbumTitle
FROM Singers AS s
JOIN Albums AS a ON s.SingerId = a.SingerId
WHERE s.SingerId = 2 AND a.AlbumId = 1;
Bei einem Apply-Join fungiert s.SingerId = a.SingerId als Suchbedingung auf der rechten Seite des Joins, sodass die Abfrage nur eine Zeile aus der Tabelle Albums lesen muss.
Im Gegensatz dazu werden bei einem Hash-Join oder Merge-Join die linken und rechten Eingaben unabhängig voneinander gelesen, sodass die Join-Bedingung keinen Suchschlüssel von einer Seite zur anderen bereitstellt. Im schlimmsten Fall führt ein Hash- oder Merge-Join einen vollständigen Tabellenscan für jede Eingabe durch.
In interaktiven und transaktionalen Abfragen verwenden die meisten Joins Indexe. Daher ist die verteilte Anwendung der am häufigsten verwendete Join-Typ in Spanner. Manchmal ist jedoch ein Hash- oder Merge-Join die bessere Wahl, da das Lesen eines zusammenhängenden Bereichs von Zeilen deutlich schneller ist als die gleiche Anzahl von verstreuten Einzeilensuchen. Der Kompromiss besteht darin, ob es schneller ist, weniger Zeilen zu suchen (mit einem Apply-Join) oder einen größeren zusammenhängenden Bereich von Zeilen zu scannen (mit einem Hash- oder Merge-Join). Weitere Informationen zu diesem Kompromiss finden Sie unter Sequenzielle Lesevorgänge im Vergleich zu verstreuten Suchvorgängen.
Bei Abfragen, die Tausende von Zeilen lesen, ist es in der Regel sicherer, einen verteilten Apply-Join zu verwenden, wenn ein Index für den Join-Schlüssel verfügbar ist. Das liegt daran, dass die Kosten für den Apply-Join proportional zur Anzahl der verknüpften Zeilen sind, während die Kosten bei einem Hash- oder Merge-Join proportional zur Gesamtgröße der Tabelle sein können. Bei größeren Abfragen (z. B. Abfragen, die Millionen von Zeilen verarbeiten) kann die Verwendung eines Hash- oder Merge-Joins die Leistung erheblich verbessern.
Weitere Informationen zu Join-Operatoren und -Hinweisen finden Sie in den folgenden Ressourcen:
Sammelbestellung beitreten
Wie in anderen relationalen Datenbankverwaltungssystemen (RDBMS) sollten Sie Joins so anordnen, dass die Größe der Zwischenergebnisse so gering wie möglich ist. Das bedeutet, dass Daten so früh wie möglich herausgefiltert und große Übereinstimmungen so spät wie möglich zurückgestellt werden.
Wenn Sie den Hinweis FORCE_JOIN_ORDER=TRUE angeben, führt Spanner die Joins in genau der Reihenfolge aus, in der sie im Abfragetext angezeigt werden. Verschieben Sie Joins mit sehr selektiven Filtern an den Anfang der Abfrage und Joins mit großen Übereinstimmungen an das Ende der Abfrage.
Aggregationen optimieren
Mit den folgenden Techniken können Sie die Anzahl der Zeilen reduzieren, die bei Aggregationsabfragen gescannt und sortiert werden.
Eine Zeile pro Schlüsselpräfix abrufen
Ein gängiges Aggregationsmuster ist das Abrufen einer Zeile pro Schlüsselpräfix (z. B. die Zeile mit der höchsten Versionsnummer oder dem höchsten Zeitstempel). In GoogleSQL ist die effizienteste Methode dafür die Verwendung von ANY_VALUE mit HAVING MAX. Dadurch wird die Zeile mit dem Höchstwert gefunden und die angeforderte Spalte in einem einzigen Aggregationsdurchlauf zurückgegeben, ohne dass ein Self-Join oder eine vollständige Sortierung erforderlich ist. Die folgende Abfrage gruppiert beispielsweise die Tabelle Concerts nach ConcertDate und gibt für jedes Datum die BeginTime des Konzerts mit der neuesten EndTime zurück:
SELECT ConcertDate, ANY_VALUE(BeginTime HAVING MAX(EndTime))
FROM Concerts
GROUP BY ConcertDate;
Vorhandensein von Zeilen prüfen
Wenn Sie prüfen möchten, ob eine Tabelle Zeilen enthält oder ob Zeilen eine bestimmte Bedingung erfüllen, verwenden Sie LIMIT anstelle von COUNT. Beispiel:
SELECT 1 FROM Albums LIMIT 1;
Parallelität erhöhen
Spanner unterteilt Tabellen und Indexe in zusammenhängende Primärschlüsselbereiche, die als Splits bezeichnet werden und parallel auf mehreren Servern verarbeitet werden können. In der Regel wählt Spanner die Abfrageparallelität aus, um Latenz und Effizienz in Einklang zu bringen. Wenn eine Abfrage beispielsweise eine LIMIT-Klausel enthält, wird möglicherweise weniger Parallelität verwendet, um zu vermeiden, dass Arbeit verschwendet wird, die durch das Limit verworfen wird. Die Anzahl der von der Abfrage gescannten Aufteilungen begrenzt den maximalen Parallelitätsgrad.
Bei Abfragen mit Limits oder großen Scans können Sie den Anweisungshinweis USE_ADDITIONAL_PARALLELISM=TRUE festlegen, um Spanner anzuweisen, primär die Latenz zu optimieren:
GoogleSQL
@{USE_ADDITIONAL_PARALLELISM=TRUE}
SELECT *
FROM Singers
LIMIT 10;
PostgreSQL
/*@ USE_ADDITIONAL_PARALLELISM=TRUE */
SELECT *
FROM Singers
LIMIT 10;
Dieser Hinweis kann die CPU bei einem bestimmten Split auslasten. Wenn die Abfrage lange dauert, senden Sie sie mit mittlerer Anfragepriorität, um die Latenz für andere Abfragen mit hoher Priorität nicht zu erhöhen.
Limits optimieren
Wenn eine Abfrage eine LIMIT-Klausel enthält, aber viel mehr Zeilen als der Grenzwert scannt, prüfen Sie die folgenden möglichen Ursachen:
Fehlender Index
Wenn eine Abfrage einen Filter enthält, der nicht mithilfe eines Index erfüllt werden kann, wird im Abfrageplan die Basistabelle oder ein Index gescannt, der nicht die erforderliche Sortierreihenfolge bietet. Die Abfrage sortiert dann die übereinstimmenden Daten vollständig, bevor die LIMIT-Klausel ausgewertet wird.
Um dieses Problem zu beheben, können Sie einen sekundären Index hinzufügen, der die Filterspalten abdeckt. Wenn der Index als NULL_FILTERED definiert ist (was bedeutet, dass Zeilen ausgeschlossen werden, in denen eine indexierte Spalte NULL ist), muss das Abfrageprädikat IS NOT NULL enthalten, damit der Optimierer den Index verwenden kann. Weitere Informationen zum Erstellen von sekundären Indexen finden Sie unter Sekundäre Indexe.
Vollständige Sortierung
Wenn ein Index für die gefilterte Spalte vorhanden ist, der Index aber nicht die von der ORDER BY-Klausel erforderliche Sortierreihenfolge bereitstellt, muss Spanner alle übereinstimmenden Zeilen lesen und an einen Sort-Operator im Abfrageausführungsplan übergeben, bevor die LIMIT angewendet wird.
Wenn Sie eine vollständige Sortierung vermeiden möchten, geben Sie die Spalten in der CREATE INDEX-Anweisung in der folgenden Reihenfolge an:
- Zuerst alle Spalten, die in der Abfrage eine Gleichheitsbedingung (
=) oder eineIN-Bedingung haben - Dann dieselben Spalten wie in der
ORDER BY-Klausel der Abfrage, in derselben Reihenfolge und mit derselben Sortierrichtung (ASCoderDESC)
Angenommen, Sie haben eine Tabelle Users (nicht im vorherigen Beispielschema dargestellt) und möchten die folgende Abfrage optimieren:
SELECT * FROM Users
WHERE Name='Alex'
ORDER BY LastLogin DESC
LIMIT 10;
Erstellen Sie einen Index für (Name, LastLogin DESC), damit Spanner die ersten 10 Zeilen direkt in der Indexreihenfolge ohne Sortierung lesen kann:
CREATE INDEX UsersByNameLastLogin ON Users(Name, LastLogin DESC);
Nach Schlüsselsuffix sortieren
Auch wenn ein Index die Spalte ORDER BY als Suffix des Indexschlüssels enthält, kann eine Abfrage zusätzliche Zeilen scannen, wenn ein IN-, OR- oder Bereichsprädikat für eine der Präfixspalten des Index vorhanden ist.
Betrachten Sie beispielsweise die folgende Abfrage, die den Index (Name, LastLogin DESC) aus dem vorherigen Beispiel für die vollständige Sortierung verwendet, der nicht Teil des Beispielschemas ist:
SELECT *
FROM Users
WHERE Name IN ('Alex','Amal')
ORDER BY LastLogin DESC
LIMIT 10;
Da Name mit mehreren Werten übereinstimmt, werden die übereinstimmenden Zeilen nicht in einem einzigen global sortierten Bereich nach LastLogin DESC gespeichert. Sie können die Abfrage mit UNNEST und einem Join so umstrukturieren, dass Spanner die obersten Zeilen für jeden Name-Wert separat abruft und dann kombiniert:
SELECT *
FROM UNNEST(['Alex','Amal']) AS Name
JOIN Users AS u ON u.Name = Name
ORDER BY LastLogin DESC
LIMIT 10;
Diese Neuschreibung führt zu effizienteren Scans, da die minimale Anzahl von Zeilen aus jedem gebundenen Präfixschlüssel ('Alex' und 'Amal') gelesen wird, gefolgt von einer kleinen Sortierung der kombinierten Ergebnisse, um das endgültige LIMIT zu erzeugen.
Ein häufiger Sonderfall dieses Musters ist ein Shard-Präfix, bei dem eine ShardId-Spalte als führende Schlüsselspalte hinzugefügt wird, um Schreibvorgänge auf Splits zu verteilen.
Die folgende Abfrage scannt beispielsweise 32 Shards (0 bis 31):
SELECT *
FROM Users
WHERE ShardId BETWEEN 0 AND 31
ORDER BY LastLogin DESC
LIMIT 10;
Wenn Sie diese Abfrage optimieren möchten, listen Sie die Shard-IDs (0 bis 31) explizit auf und verknüpfen Sie sie mit der Tabelle Users. Verwenden Sie dazu GENERATE_ARRAY in GoogleSQL oder generate_series in PostgreSQL:
GoogleSQL
SELECT *
FROM GENERATE_ARRAY(0, 31) AS id
JOIN Users AS u ON u.ShardId = id
ORDER BY LastLogin DESC
LIMIT 10;
PostgreSQL
SELECT *
FROM generate_series(0, 31) AS id
JOIN Users AS u ON u.ShardId = id
ORDER BY LastLogin DESC
LIMIT 10;
Weitere Informationen zu diesen Funktionen zum Generieren von Arrays und Reihen finden Sie unter GENERATE_ARRAY für GoogleSQL und generate_series für PostgreSQL.
Scanleistung nachvollziehen
In den folgenden Abschnitten werden die häufigsten Ursachen für langsame Tabellen- oder Indexscans und deren Behebung beschrieben.
Gelöschte Zeilen
Standardmäßig speichert Spanner gelöschte oder überschriebene Zeilen eine Stunde lang, um historische Lesevorgänge und die Wiederherstellung zu einem bestimmten Zeitpunkt zu unterstützen. Sie können diese Aufbewahrungsdauer auf bis zu sieben Tage erhöhen. Nachdem eine alte Zeilenversion die Aufbewahrungsdauer überschritten hat, kann sie während der Hintergrundspeicherkomprimierung entfernt werden. Dies kann bis zu sieben weitere Tage dauern. Bis eine alte Zeilenversion komprimiert ist, müssen Abfragen, die den Schlüsselbereich scannen, möglicherweise die gelöschten oder überschriebenen Zeilenversionen lesen und herausfiltern. Weitere Informationen zur Datenaufbewahrung finden Sie unter Wiederherstellung zu einem bestimmten Zeitpunkt (PITR).
Sie können prüfen, ob bei einer Abfrage gelöschte Zeilen gescannt wurden. Sehen Sie sich dazu im Detailbereich des Visualizers für Abfragepläne in der Detailansicht des Operators Scannen den Messwert Gescannte gelöschte Zeilen an.
Um langsame Scans aufgrund einer großen Anzahl kürzlich gelöschter Zeilen zu vermeiden, können Sie eine manuelle Datenkomprimierung auslösen. Weitere Informationen finden Sie unter Manuelle Datenkomprimierung.
Große Zeilen
Bei kleinen Zeilen (bis zu einigen hundert Byte) hängen die Kosten eines Scans hauptsächlich von der Anzahl der gescannten Zeilen ab. Mit zunehmender Zeilengröße wird die Bytegröße der Zeilen immer wichtiger. Im zeilenorientierten Speicher wirkt sich die Gesamtgröße der Zeile auf die Scanleistung aus, nicht nur die Größe der von der Abfrage projizierten Spalten.
Für scanintensive analytische Abfragen über große Tabellen sollten Sie die spaltenbasierte Engine verwenden. Weitere Informationen finden Sie unter Spaltenbasierte Engine überwachen.
Wenn eine Tabelle sowohl große als auch kleinere Spalten enthält, die häufig abgefragt werden, sollten Sie für Abfragen für kleinere Zeilensätze die folgenden Optionen in Betracht ziehen:
- Trennen Sie die größeren Spalten in eine nicht standardmäßige Lokalisierungsgruppe (in der bestimmte Spalten separat vom Rest der Tabelle auf dem Laufwerk gespeichert werden) oder eine separate untergeordnete Tabelle, damit bei Scans der kleineren Spalten nicht die Daten der großen Spalten gelesen werden. Weitere Informationen finden Sie unter Standortgruppen erstellen und verwalten.
- Für eine zusätzliche Optimierung der Lesezeit duplizieren Sie die kleineren Spalten in einen sekundären Index mit demselben Primärschlüssel wie die Basistabelle. Verwenden Sie dazu die
STORING-Klausel, um die kleineren Spalten einzuschließen.
Angenommen, in einer Documents-Tabelle (nicht Teil des vorherigen Beispielschemas) wird ein kleiner Metadata-String zusammen mit einem großen Content-JSON-Objekt gespeichert. Sie können einen sekundären Index erstellen, in dem nur Metadata gespeichert wird, sodass Abfragen, die Content nicht benötigen, den kleineren Index anstelle der Basistabelle scannen können:
CREATE TABLE Documents (
  Id INT64,
  Metadata STRING(MAX),
  Content JSON
) PRIMARY KEY (Id);

CREATE INDEX DocumentMetadata ON Documents(Id) STORING (Metadata);
Große verschachtelte Daten
Wenn Tabellen verschachtelt sind, speichert Spanner jede übergeordnete Zeile zusammen mit den verschachtelten untergeordneten Zeilen in der Schlüsselreihenfolge. Wenn eine übergeordnete Tabelle viele verschachtelte untergeordnete Zeilen hat oder eine untergeordnete Tabelle deutlich weniger Zeilen als ihre übergeordneten oder gleichgeordneten Tabellen hat, sind Bereichsscans über die kleinere Tabelle dünner besetzt und weniger effizient, da der Scan die verschachtelten Zeilen aus den anderen Tabellen überspringen muss.
Betrachten Sie beispielsweise das folgende Schema (nicht Teil des vorherigen Beispielschemas), in dem sowohl Transaction als auch AuthorizedPerson in Account verschachtelt sind:
CREATE TABLE Account (
  AccountId INT64,
  -- Additional columns omitted
) PRIMARY KEY (AccountId);

CREATE TABLE Transaction (
  AccountId INT64,
  TransactionId STRING(MAX),
  -- Additional columns omitted
) PRIMARY KEY (AccountId, TransactionId),
INTERLEAVE IN PARENT Account;

CREATE TABLE AuthorizedPerson (
  AccountId INT64,
  SignerId INT64,
  Name STRING(MAX),
  -- Additional columns omitted
) PRIMARY KEY (AccountId, SignerId),
INTERLEAVE IN PARENT Account;
Wenn jede Account-Zeile Tausende von Transaction-Zeilen und nur wenige AuthorizedPerson-Zeilen hat, sind die Kosten pro Zeile für einen Bereichsscan für Account oder AuthorizedPerson höher als für einen Bereichsscan für Transaction (obwohl die Gesamtkosten immer noch niedriger sind). Das liegt daran, dass bei einem Transaction-Scan viele zusammenhängende Transaction-Zeilen gleichzeitig gelesen werden, während ein Scan für Account oder AuthorizedPerson weniger benachbarte Zeilen derselben Tabelle enthält und die verschachtelten Transaction-Zeilen überspringen muss.
Wenn Sie Bereichsscans für die dünnbesetzte Tabelle (Account oder AuthorizedPerson) optimieren möchten, erstellen Sie einen nicht verschachtelten sekundären Index, der die für Ihre Abfrage erforderlichen Spalten dupliziert, ähnlich wie bei großen Zeilen:
CREATE INDEX AuthorizedPersonByAccount
  ON AuthorizedPerson(AccountId, SignerId)
  STORING (Name);
Batchorientierte Ausführung verwenden
Spanner kann Abfragescans und Abfrageoperatoren entweder mit einer zeilenorientierten Methode (jeweils eine Zeile verarbeiten) oder einer batchorientierten Methode (jeweils Blöcke von Zeilen verarbeiten) ausführen. In den folgenden Abschnitten wird erläutert, wie Sie batchorientierte Scans und die batchorientierte Operatorausführung prüfen und konfigurieren.
Batchorientierte Scans
Bei bestimmten Spanner-Abfragen kann es von Vorteil sein, beim Scannen von Daten eine batchorientierte Verarbeitungsmethode anstelle der gängigeren zeilenorientierten Verarbeitungsmethode zu verwenden. Die Verarbeitung von Scans in Batches ist eine effizientere Methode, um große Datenmengen auf einmal zu verarbeiten. Dadurch können Abfragen eine geringere CPU-Auslastung und Latenz erreichen.
Der Spanner-Scanvorgang beginnt immer mit der zeilenorientierten Methode. Während dieser Zeit erfasst Spanner mehrere Laufzeitmesswerte. Anschließend wendet Spanner eine Reihe von Heuristiken basierend auf dem Ergebnis dieser Messwerte an, um die optimale Scanmethode zu ermitteln. Gegebenenfalls wechselt Spanner zu einer batchorientierten Verarbeitungsmethode, um den Scandurchsatz und die Leistung zu verbessern.
Gängige Anwendungsfälle
Abfragen mit den folgenden Merkmalen profitieren im Allgemeinen von einer batchorientierten Verarbeitung:
- Große Scans über selten aktualisierte Daten
- Scans mit Prädikaten für Spalten mit fester Breite
- Scans mit einer großen Anzahl von Suchvorgängen (bei einem Suchvorgang wird ein Index zum Abrufen von Datensätzen verwendet)
Anwendungsfälle ohne Leistungssteigerung
Nicht alle Abfragen profitieren von einer batchorientierten Verarbeitung. Die folgenden Abfragetypen funktionieren besser mit zeilenorientierter Scanverarbeitung:
- Punktabfragen: Abfragen, die nur eine Zeile abrufen.
- Kleine Scanabfragen: Tabellenscans, bei denen nur wenige Zeilen gescannt werden, es sei denn, sie haben eine große Anzahl von Suchvorgängen.
- Abfragen mit einer
LIMIT-Klausel: Abfragen, die den Scanvorgang beenden, nachdem eine feste Anzahl von Zeilen zurückgegeben wurde. - Abfragen, die Daten mit hoher Fluktuation lesen: Abfragen, bei denen mehr als etwa 10% der gelesenen Daten häufig aktualisiert werden.
- Abfragen mit Zeilen, die große Werte enthalten: Abfragen für Zeilen, die Werte enthalten, die größer als 32.000 Byte (vor der Komprimierung) in einer einzelnen Spalte sind.
Von einer Abfrage verwendete Scanmethode prüfen
So prüfen Sie, ob Ihre Abfrage die batchorientierte Verarbeitung, die zeilenorientierte Verarbeitung oder den automatischen Wechsel zwischen den beiden Scanmethoden verwendet:
Rufen Sie in der Google Cloud Console die Spanner-Seite Instanzen auf.
Klicken Sie auf den Namen der Instanz mit der Abfrage, die Sie untersuchen möchten.
Klicken Sie in der Tabelle Datenbanken auf die Datenbank mit der Abfrage, die Sie untersuchen möchten.
Klicken Sie im Spanner-Navigationsmenü auf Spanner Studio.
Klicken Sie auf Neuer SQL-Editor-Tab oder Neuer Tab.
Geben Sie Ihre Abfrage in den Abfrageeditor ein.
Klicken Sie auf Ausführen.
Spanner führt die Abfrage aus und zeigt die Ergebnisse an.
Klicken Sie im Bereich des Abfrageeditors auf den Tab Erklärung.
Spanner zeigt die Visualisierung des Abfrageausführungsplans an. Jede Karte im Diagramm stellt einen Iterator dar. Weitere Informationen zu Ausführungsplänen finden Sie unter Abfrageausführungspläne.
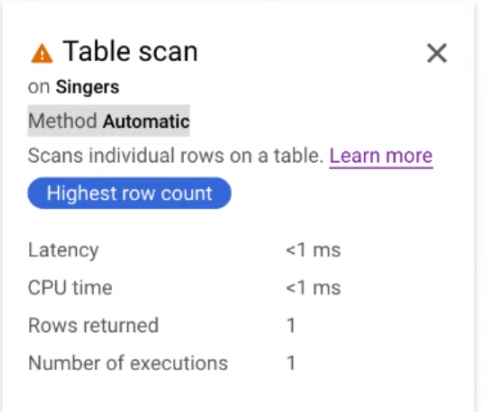
Klicken Sie auf die Iterator-Karte Tabellenscan, um einen Informationsbereich zu öffnen.
Im Informationsbereich werden kontextbezogene Informationen zum ausgewählten Scan angezeigt, einschließlich der Scanmethode (Methode). Automatisch gibt an, dass Cloud Spanner die Scanmethode bestimmt. Andere mögliche Werte sind Batch für die Batch-orientierte Verarbeitung und Zeile für die zeilenorientierte Verarbeitung, wie in der folgenden Abbildung dargestellt:
Von einer Abfrage verwendete Scanmethode erzwingen
Um die Abfrageleistung zu optimieren, wählt Spanner die optimale Scanmethode für Ihre Abfrage aus. Google empfiehlt, diese Standard-Scanmethode zu verwenden. Es kann jedoch Szenarien geben, in denen Sie einen bestimmten Typ von Scanmethode erzwingen möchten.
Batchorientiertes Scannen erzwingen
Sie können das batchorientierte Scannen auf Tabellen- und Anweisungsebene erzwingen.
Wenn Sie die batchorientierte Scanmethode auf Tabellenebene erzwingen möchten, verwenden Sie in Ihrer Abfrage einen Tabellenhinweis:
GoogleSQL
SELECT *
FROM (Singers@{SCAN_METHOD=BATCH} AS s
  JOIN Albums AS a ON s.SingerId = a.SingerId);
PostgreSQL
SELECT *
FROM (Singers/*@ scan_method=batch */ AS s
  JOIN Albums AS a ON s.SingerId = a.SingerId);
Wenn Sie die batchorientierte Scanmethode auf Anweisungsebene erzwingen möchten, verwenden Sie einen Anweisungshinweis in Ihrer Abfrage:
GoogleSQL
@{SCAN_METHOD=BATCH}
SELECT *
FROM Singers;
PostgreSQL
/*@ scan_method=batch */
SELECT *
FROM Singers;
Wenn Sie einen Hinweis auf Anweisungsebene verwenden, gilt er für die gesamte Abfrage. Es ist besser, den Hinweis auf Tabellenebene festzulegen, da dies eine detailliertere Kontrolle ermöglicht.
Zeilenorientiertes Scannen erzwingen
Google empfiehlt zwar nicht, die von Spanner festgelegte automatische Scanmethode zu deaktivieren, Sie können sie jedoch deaktivieren und die zeilenorientierte Scanmethode zur Fehlerbehebung verwenden, z. B. zur Diagnose von Latenz.
Wenn Sie die automatische Auswahl der Scanmethode deaktivieren und die Zeilenverarbeitung auf Tabellenebene erzwingen möchten, verwenden Sie in Ihrer Abfrage einen Tabellenhinweis:
GoogleSQL
SELECT *
FROM (Singers@{SCAN_METHOD=ROW} AS s
  JOIN Albums AS a ON s.SingerId = a.SingerId);
PostgreSQL
SELECT *
FROM (Singers/*@ scan_method=row */ AS s
  JOIN Albums AS a ON s.SingerId = a.SingerId);
Wenn Sie die automatische Scanmethode deaktivieren und die Zeilenverarbeitung auf Anweisungsebene erzwingen möchten, verwenden Sie einen Anweisungshinweis in Ihrer Abfrage:
GoogleSQL
@{SCAN_METHOD=ROW}
SELECT *
FROM Singers;
PostgreSQL
/*@ scan_method=row */
SELECT *
FROM Singers;
Ausführungsmethode
Zusätzlich zu batchorientierten Scans können Sie die Abfrageausführung auch optimieren, indem Sie die Ausführungsmethode auf Anweisungsebene erzwingen. Dies funktioniert nur für einige Operatoren und ist unabhängig von der Scanmethode, die nur vom Scanoperator verwendet wird. Weitere Informationen zu batchorientierten Scans finden Sie im Abschnitt Batchorientierte Scans in diesem Dokument.
Standardmäßig werden die meisten Operatoren mit der zeilenorientierten Methode ausgeführt, bei der Daten zeilenweise verarbeitet werden. Vektorisierte Operatoren werden im batchorientierten Verfahren ausgeführt, um den Ausführungsdurchsatz und die Leistung zu verbessern. Diese Operatoren verarbeiten Daten blockweise. Wenn ein Operator viele Zeilen verarbeiten muss, ist die batchorientierte Ausführungsmethode in der Regel effizienter.
Ausführungsmethode im Vergleich zur Scanmethode
Die Methode zur Abfrageausführung ist unabhängig von der Methode zum Scannen von Abfragen. Sie können eine, beide oder keine dieser Methoden in Ihrem Abfragehinweis festlegen.
Die Abfrageausführungsmethode bezieht sich auf die Art und Weise, wie Abfrageoperatoren Zwischenergebnisse verarbeiten und wie die Operatoren miteinander interagieren. Die Scanmethode bezieht sich dagegen auf die Art und Weise, wie der Scanoperator mit der Spanner-Speicherebene interagiert.
Ausführungsmethode für die Abfrage erzwingen
Um die Abfrageleistung zu optimieren, wählt Spanner anhand verschiedener Heuristiken die optimale Ausführungsmethode für Ihre Abfrage aus. Google empfiehlt, diese Standardausführungsmethode zu verwenden. Es kann jedoch Szenarien geben, in denen Sie einen bestimmten Typ von Ausführungsmethode erzwingen möchten.
Sie können die Ausführungsmethode auf Anweisungsebene erzwingen. Der Abfragehinweis EXECUTION_METHOD ist eine Empfehlung und keine Anweisung. Letztendlich entscheidet das Abfrageoptimierungstool, welche Methode für jeden einzelnen Operator verwendet wird.
Wenn Sie die batchorientierte Ausführungsmethode auf Anweisungsebene erzwingen möchten, verwenden Sie in Ihrer Abfrage einen Anweisungshinweis:
GoogleSQL
@{EXECUTION_METHOD=BATCH}
SELECT *
FROM Singers;
PostgreSQL
/*@ EXECUTION_METHOD=BATCH */
SELECT *
FROM Singers;
Google empfiehlt zwar nicht, die von Spanner festgelegte automatische Ausführungsmethode zu deaktivieren, Sie können sie jedoch deaktivieren und die zeilenorientierte Ausführungsmethode zur Fehlerbehebung verwenden, z. B. zur Diagnose von Latenz.
Wenn Sie die automatische Ausführungsmethode deaktivieren und die zeilenorientierte Ausführungsmethode auf Anweisungsebene erzwingen möchten, verwenden Sie einen Anweisungshinweis in Ihrer Abfrage:
GoogleSQL
@{EXECUTION_METHOD=ROW}
SELECT *
FROM Singers;
PostgreSQL
/*@ EXECUTION_METHOD=ROW */
SELECT *
FROM Singers;
Prüfen, welche Ausführungsmethode aktiviert ist
Nicht alle Spanner-Operatoren unterstützen sowohl die batchorientierte als auch die zeilenorientierte Ausführungsmethode. Für jeden Operator wird im Visualizer für den Abfrageausführungsplan die Ausführungsmethode auf der Iterator-Karte angezeigt. Wenn die Ausführungsmethode batchorientiert ist, wird Batch angezeigt. Wenn es zeilenorientiert ist, wird Zeile angezeigt. Weitere Informationen zum Visualizer finden Sie unter Abfrageausführungspläne.
Wenn die Operatoren in Ihrer Abfrage mit unterschiedlichen Ausführungsmethoden ausgeführt werden, werden die Ausführungsmethodenadapter DataBlockToRowAdapter und RowToDataBlockAdapter zwischen den Operatoren angezeigt, um die Änderung der Ausführungsmethode zu verdeutlichen. Weitere Informationen zu diesen Operatoren finden Sie unter DataBlockToRowAdapter und RowToDataBlockAdapter.