


Nesta página, descrevemos técnicas para ajustar o desempenho de consultas do Spanner. Antes de começar a ajustar suas consultas, leia as páginas a seguir, que explicam os conceitos e as ferramentas fundamentais usados no ajuste de consultas:
- Práticas recomendadas de SQL
- Visão geral do visualizador do plano de consulta
- Estatísticas de consulta
- Operadores de execução de consulta
As consultas e os planos de execução dessa página se baseiam no esquema de banco de dados abaixo:
CREATE TABLE Singers (
  SingerId   INT64 NOT NULL,
  FirstName  STRING(1024),
  LastName   STRING(1024),
  SingerInfo BYTES(MAX),
  BirthDate  DATE
) PRIMARY KEY(SingerId);

CREATE INDEX SingersByFirstLastName ON Singers(FirstName, LastName);

CREATE TABLE Albums (
  SingerId        INT64 NOT NULL,
  AlbumId         INT64 NOT NULL,
  AlbumTitle      STRING(MAX),
  MarketingBudget INT64
) PRIMARY KEY(SingerId, AlbumId),
  INTERLEAVE IN PARENT Singers ON DELETE CASCADE;

CREATE INDEX AlbumsByAlbumTitle ON Albums(AlbumTitle);

CREATE INDEX AlbumsByAlbumTitle2 ON Albums(AlbumTitle) STORING (MarketingBudget);

CREATE TABLE Songs (
  SingerId  INT64 NOT NULL,
  AlbumId   INT64 NOT NULL,
  TrackId   INT64 NOT NULL,
  SongName  STRING(MAX),
  Duration  INT64,
  SongGenre STRING(25)
) PRIMARY KEY(SingerId, AlbumId, TrackId),
  INTERLEAVE IN PARENT Albums ON DELETE CASCADE;

CREATE INDEX SongsBySingerAlbumSongNameDesc ON Songs(SingerId, AlbumId, SongName DESC), INTERLEAVE IN Albums;

CREATE INDEX SongsBySongName ON Songs(SongName);

CREATE TABLE Concerts (
  VenueId      INT64 NOT NULL,
  SingerId     INT64 NOT NULL,
  ConcertDate  DATE NOT NULL,
  BeginTime    TIMESTAMP,
  EndTime      TIMESTAMP,
  TicketPrices ARRAY<INT64>
) PRIMARY KEY(VenueId, SingerId, ConcertDate);
É possível usar as seguintes instruções da linguagem de manipulação de dados (DML) para adicionar dados a estas tabelas:
INSERT INTO Singers (SingerId, FirstName, LastName, BirthDate)
VALUES (1, "Marc", "Richards", "1970-09-03"),
       (2, "Catalina", "Smith", "1990-08-17"),
       (3, "Alice", "Trentor", "1991-10-02"),
       (4, "Lea", "Martin", "1991-11-09"),
       (5, "David", "Lomond", "1977-01-29");

INSERT INTO Albums (SingerId, AlbumId, AlbumTitle)
VALUES (1, 1, "Total Junk"),
       (1, 2, "Go, Go, Go"),
       (2, 1, "Green"),
       (2, 2, "Forever Hold Your Peace"),
       (2, 3, "Terrified"),
       (3, 1, "Nothing To Do With Me"),
       (4, 1, "Play");

INSERT INTO Songs (SingerId, AlbumId, TrackId, SongName, Duration, SongGenre)
VALUES (2, 1, 1, "Let's Get Back Together", 182, "COUNTRY"),
       (2, 1, 2, "Starting Again", 156, "ROCK"),
       (2, 1, 3, "I Knew You Were Magic", 294, "BLUES"),
       (2, 1, 4, "42", 185, "CLASSICAL"),
       (2, 1, 5, "Blue", 238, "BLUES"),
       (2, 1, 6, "Nothing Is The Same", 303, "BLUES"),
       (2, 1, 7, "The Second Time", 255, "ROCK"),
       (2, 3, 1, "Fight Story", 194, "ROCK"),
       (3, 1, 1, "Not About The Guitar", 278, "BLUES");
Recomendações de comparativo de mercado
As estatísticas de desempenho mais confiáveis vêm da execução de um teste de carga que usa valores de parâmetro de consulta diferentes e aleatórios de uma instância de máquina virtual (VM) do Google Cloud que reside na mesma região que a instância de destino.
Evite usar o Spanner Studio ou o modo QueryMode.PROFILE para
fazer comparativos de mercado de consultas, porque essas ferramentas não replicam os ambientes reais de rede
e cliente de produção. No entanto, depois que um teste de carga identifica um problema de desempenho, os planos de consulta (sejam amostrados no Query Insights ou executados sob demanda no Spanner Studio) são ferramentas úteis para investigar esse problema específico.
Entender os planos de execução de consulta
No visualizador do plano de consulta, um plano de execução de consulta é mostrado como uma árvore de operadores, em que cada operador lê linhas dos operadores filhos, as processa e transmite os resultados para o operador pai.
Para a maioria dos operadores no plano visual, a latência informada é aditiva (reflete apenas o tempo gasto nesse operador). No entanto, para os operadores Distributed union e Distributed apply, a latência informada é cumulativa: ela inclui o tempo gasto no próprio operador distribuído e o tempo gasto nos operadores filhos. Para mais informações sobre esses operadores, consulte União distribuída e Aplicação distribuída.
Por exemplo, no plano de união distribuída a seguir, o card Distributed union
informa uma latência total de 8,46 ms, enquanto o operador filho Stream aggregate
informa 3,51 ms e Table scan informa 1 ms. Como a
latência de Distributed union é cumulativa, o próprio operador Distributed union
adiciona apenas cerca de 5 ms de latência, em vez de 8 ms:

No próximo exemplo, o card Distributed union informa 13,69 ms de
latência, enquanto os operadores filhos (Stream aggregate em <1 ms,
Cross apply em 1,14 ms, Table scan em Albums em <1 ms,
Filter scan em 1 ms e Table scan em Singers em 10,85 ms)
representam aproximadamente 13 ms. Como resultado, o próprio operador Distributed union
adiciona menos de 1 ms de latência, em vez de 13 ms:

Também é possível ver os valores de latência cumulativa no painel de resumo do operador.
Combinar vários índices
Quando uma consulta filtra várias colunas indexadas usando condições OR ou AND,
o Spanner às vezes pode combinar vários índices secundários para evitar
a verificação de toda a tabela base. Os exemplos nesta seção estendem a tabela Albums
do esquema de exemplo anterior adicionando uma coluna ReleaseDate e um
índice secundário AlbumsByReleaseDate:
CREATE TABLE Albums (
  SingerId        INT64 NOT NULL,
  AlbumId         INT64 NOT NULL,
  AlbumTitle      STRING(MAX),
  ReleaseDate     DATE,
  MarketingBudget INT64
) PRIMARY KEY(SingerId, AlbumId),
  INTERLEAVE IN PARENT Singers ON DELETE CASCADE;

CREATE INDEX AlbumsByAlbumTitle ON Albums(AlbumTitle);

CREATE INDEX AlbumsByReleaseDate ON Albums(ReleaseDate);
Considere a consulta a seguir, que usa uma condição OR para filtrar
predicados de dois índices secundários separados (AlbumsByAlbumTitle e
AlbumsByReleaseDate):
SELECT a.AlbumId, a.AlbumTitle, a.ReleaseDate
FROM Albums AS a
WHERE a.AlbumTitle = 'Play' OR a.ReleaseDate = '2023-09-07';
Quando uma consulta tem uma condição OR em predicados de dois índices separados,
o Spanner pode usar a otimização baseada em custo para ler os dois índices
e combinar os resultados (uma união de índices). Também é possível forçar essa otimização
adicionando a dica de tabela INDEX_STRATEGY=FORCE_INDEX_UNION à consulta:
SELECT a.AlbumId, a.AlbumTitle, a.ReleaseDate
FROM Albums@{INDEX_STRATEGY=FORCE_INDEX_UNION} AS a
WHERE a.AlbumTitle = 'Play' OR a.ReleaseDate = '2023-09-07';
Para mais informações sobre dicas de tabela, consulte Dicas de tabela.
O diagrama do plano de execução a seguir mostra como o Spanner avalia
essa condição OR (disjunção) verificando cada ramificação separadamente e
combinando os resultados usando os operadores Union all e Hash aggregate:

Em seguida, considere uma consulta que usa uma condição AND para filtrar as duas colunas
indexadas:
SELECT a.AlbumId, a.ReleaseDate, a.AlbumTitle
FROM Albums AS a
WHERE a.AlbumTitle = 'Aardvark' AND a.ReleaseDate = '2023-09-07';
Com uma condição AND, o Spanner escolhe um único índice por padrão
e, se necessário, volta para a tabela base para avaliar a condição restante
na cláusula AND. Para determinar se essa nova mesclagem da tabela base é
um gargalo de desempenho, inspecione o plano de execução da consulta no visualizador: se
o operador Index scan retornar muitas linhas que são filtradas
depois da mesclagem com o operador Table scan na tabela base (resultando em
alta latência ou tempo de CPU na ramificação Table scan em relação ao número final
de linhas retornadas), a nova mesclagem é um gargalo.
Se a mesclagem reversa da tabela base for o gargalo da consulta, a solução recomendada
é adicionar a coluna extra na condição AND à cláusula STORING
do índice secundário para que o Spanner possa avaliar as duas
condições diretamente do índice sem ler a tabela base:
CREATE INDEX AlbumsByAlbumTitleStoringReleaseDate
  ON Albums(AlbumTitle)
  STORING (ReleaseDate);
Se não for possível modificar o índice, uma alternativa é reescrever a consulta para
fazer uma interseção dos dois índices usando INTERSECT DISTINCT e, em seguida,
unir as chaves primárias correspondentes de volta à tabela base Albums:
SELECT union_a.AlbumId, a.ReleaseDate, a.AlbumTitle FROM
  (SELECT a1.SingerId, a1.AlbumId
  FROM Albums @{force_index=AlbumsByReleaseDate} AS a1
  WHERE a1.ReleaseDate = '2023-09-07'
  INTERSECT DISTINCT
  SELECT a2.SingerId, a2.AlbumId
  FROM Albums @{force_index=AlbumsByAlbumTitle} AS a2
  WHERE a2.AlbumTitle = 'Aardvark') AS union_a
JOIN Albums AS a
  ON a.SingerId = union_a.SingerId AND a.AlbumId = union_a.AlbumId;
O diagrama do plano de execução a seguir mostra a consulta reescrita. Observe como o
plano usa dois operadores Index scan (on AlbumsByAlbumTitle e
on AlbumsByReleaseDate) para encontrar as chaves de interseção antes de executar o
Table scan na tabela base Albums:

Se a filtragem em várias colunas for um padrão frequente na sua carga de trabalho, use a pesquisa de texto completo em várias colunas em vez de índices secundários. Para mais informações, consulte Realizar uma pesquisa em várias colunas.
Otimizar mesclagens
Quando o Spanner executa uma consulta que mescla várias tabelas, o otimizador de consultas escolhe a ordem de mesclagem (a sequência em que as tabelas são mescladas) e o método de mesclagem (o algoritmo usado para combinar linhas de duas entradas, como uma mesclagem de aplicação, de hash ou de mesclagem). Se uma consulta com uma mesclagem for mais lenta do que o esperado, use uma dica de consulta para instruir o Spanner a usar uma ordem ou um método de mesclagem diferente. Isso muda o plano de execução, mas não os resultados retornados. Exemplo:
GoogleSQL
Forçar ordem de mesclagem:
SELECT *
FROM Singers AS s JOIN@{FORCE_JOIN_ORDER=TRUE} Albums AS a
ON s.SingerId = a.SingerId
WHERE s.LastName LIKE '%x%' AND a.AlbumTitle LIKE '%love%';
Mudar o método de ingresso:
SELECT *
FROM Singers AS s JOIN@{JOIN_METHOD=HASH_JOIN} Albums AS a
ON s.SingerId = a.SingerId;
PostgreSQL
Forçar ordem de mesclagem:
SELECT *
FROM Singers AS s JOIN/*@ FORCE_JOIN_ORDER=TRUE */ Albums AS a
ON s.SingerId = a.SingerId
WHERE s.LastName LIKE '%x%' AND a.AlbumTitle LIKE '%love%';
Mudar o método de ingresso:
SELECT *
FROM Singers AS s JOIN/*@ JOIN_METHOD=HASH_JOIN */ Albums AS a
ON s.SingerId = a.SingerId;
As seções a seguir fornecem informações que podem ajudar a determinar quais ordens e métodos de mesclagem podem ajudar a melhorar o desempenho da consulta.
Método de mesclagem e verificações
O Spanner é compatível com vários métodos de mesclagem, e sua escolha afeta diretamente como o Spanner verifica as tabelas ou os índices subjacentes:
- Aplicar mesclagem (conhecida em alguns sistemas como mesclagem de pesquisa ou mesclagem de loop aninhado): executa o lado direito ("mapa") uma vez para cada linha do lado esquerdo ("entrada"). Como cada pesquisa à direita usa valores da linha atual à esquerda, as colunas de mesclagem da esquerda podem ser usadas como uma chave de busca à direita. Uma junção de aplicação distribuída funciona de maneira semelhante a uma junção de aplicação local, mas agrupa linhas para uma comunicação mais eficiente entre divisões em uma junção distribuída.
- Hash join: lê linhas de uma entrada para criar uma tabela de hash na memória nas chaves de mesclagem e, em seguida, verifica a outra entrada para sondar a tabela de hash em busca de correspondências.
- Mesclar junção: lê as duas entradas em ordem de classificação nas chaves de junção e mescla as linhas correspondentes em uma única passagem.
Por exemplo, considere a seguinte consulta que mescla Singers e Albums:
SELECT s.*, a.AlbumTitle
FROM Singers AS s
JOIN Albums AS a ON s.SingerId = a.SingerId
WHERE s.SingerId = 2 AND a.AlbumId = 1;
Com uma junção de aplicação, s.SingerId = a.SingerId atua como uma condição de busca no
lado direito da junção, de modo que a consulta só precisa ler uma linha da tabela
Albums.
Por outro lado, em uma mesclagem ou junção de hash, as entradas esquerda e direita são lidas independentemente uma da outra. Portanto, a condição de junção não fornece uma chave de busca de um lado para o outro. No pior dos casos, uma mesclagem de hash ou de junção realiza uma verificação de tabela completa de cada entrada.
Em consultas interativas e transacionais, a maioria das mesclagens usa índices. Portanto, a aplicação distribuída é o tipo de mesclagem mais comum no Spanner. No entanto, às vezes, uma mesclagem de hash ou de mesclagem é uma opção melhor porque ler um intervalo contíguo de linhas é significativamente mais rápido do que realizar o mesmo número de buscas de linha única dispersas. A compensação é se é mais rápido buscar menos linhas (usando uma mesclagem de aplicação) ou verificar um intervalo contíguo maior de linhas (usando uma mesclagem de hash ou mesclagem). Para mais informações sobre essa compensação, consulte Leituras sequenciais versus buscas dispersas.
Para consultas que leem milhares de linhas, se um índice estiver disponível na chave de mesclagem, geralmente é mais seguro usar uma mesclagem de aplicação distribuída. Isso ocorre porque o custo de mesclagem de aplicação é proporcional ao número de linhas mescladas, enquanto que, com uma mesclagem de hash ou mesclagem, o custo pode ser proporcional ao tamanho total da tabela. Para consultas maiores (como aquelas que processam milhões de linhas), o uso de uma mesclagem de hash ou mesclagem pode oferecer uma melhoria significativa de desempenho.
Para mais informações sobre operadores e dicas de mesclagem, consulte os seguintes recursos:
- Aplicar mesclagem
- Aplicação distribuída
- Hash join
- Mesclar participação
- Referência de métodos de mesclagem
Ordem de mesclagem
Como em outros sistemas de gerenciamento de bancos de dados relacional (RDBMSs), ordene as junções para manter o tamanho do resultado intermediário o menor possível. Isso significa filtrar os dados o mais cedo possível e adiar as correspondências grandes o máximo possível.
Se você fornecer a dica FORCE_JOIN_ORDER=TRUE, o Spanner vai executar
as mesclagens na ordem exata em que aparecem no texto da consulta. Mova as mesclagens com filtros muito seletivos para o início da consulta e as mesclagens com grandes correspondências para o final.
Otimizar agregações
As técnicas a seguir podem ajudar a reduzir o número de linhas verificadas e classificadas durante as consultas de agregação.
Recuperar uma linha por prefixo de chave
Um padrão de agregação comum é recuperar uma linha por prefixo de chave (por exemplo, a linha com o maior número de versão ou carimbo de data/hora). No
GoogleSQL, a maneira mais eficiente de fazer isso é usar ANY_VALUE
com HAVING MAX, que encontra a linha com o valor máximo e retorna a
coluna solicitada em uma única passagem de agregação sem exigir uma mesclagem automática ou
classificação completa. Por exemplo, a consulta a seguir agrupa a tabela Concerts por ConcertDate e retorna o BeginTime do show com o EndTime mais recente para cada data:
SELECT ConcertDate, ANY_VALUE(BeginTime HAVING MAX(EndTime))
FROM Concerts
GROUP BY ConcertDate;
Verificar a existência da linha
Para verificar se uma tabela tem linhas ou linhas que correspondem a uma condição específica,
use LIMIT em vez de COUNT. Exemplo:
SELECT 1 FROM Albums LIMIT 1;
Aumentar o paralelismo
O Spanner divide tabelas e índices em intervalos de chave primária contíguos chamados de divisões, que podem ser processados em paralelo em vários servidores. Normalmente, o Spanner escolhe o paralelismo de consulta para equilibrar
latência e eficiência. Por exemplo, se uma consulta tiver uma cláusula LIMIT, ela poderá
usar menos paralelismo para evitar o desperdício de trabalho que o limite descarta. O número
de divisões verificadas pela consulta limita o grau máximo de paralelismo.
Para consultas com limites ou verificações grandes, defina a dica de instrução USE_ADDITIONAL_PARALLELISM=TRUE para instruir o Spanner a otimizar principalmente para latência:
GoogleSQL
@{USE_ADDITIONAL_PARALLELISM=TRUE}
SELECT *
FROM Singers
LIMIT 10;
PostgreSQL
/*@ USE_ADDITIONAL_PARALLELISM=TRUE */
SELECT *
FROM Singers
LIMIT 10;
Essa dica pode saturar a CPU em uma determinada divisão. Se a consulta for de longa duração, envie-a com prioridade de solicitação média para evitar o aumento da latência de outras consultas de alta prioridade.
Otimizar limites
Se uma consulta tiver uma cláusula LIMIT, mas verificar muito mais linhas do que o valor
limite, verifique as seguintes causas possíveis:
Índice ausente
Se uma consulta tiver um filtro que não pode ser atendido usando um índice, o plano de consulta vai verificar a tabela base ou um índice que não fornece a ordem de classificação necessária. Em seguida, a consulta classifica totalmente os dados correspondentes antes de avaliar a cláusula LIMIT.
Para resolver esse problema, adicione um índice secundário que cubra as colunas de filtro. Se o índice for definido como NULL_FILTERED (o que significa que ele
exclui linhas em que uma coluna indexada é NULL), verifique se o predicado da consulta
inclui IS NOT NULL para que o otimizador possa usar o índice. Para mais
informações sobre como criar índices secundários, consulte
Índices secundários.
Classificação completa
Se houver um índice na coluna filtrada, mas ele não fornecer a ordem de classificação exigida pela cláusula ORDER BY, o Spanner precisará ler todas as linhas correspondentes e transmiti-las a um operador Sort no plano de execução da consulta antes de aplicar o LIMIT.
Para evitar uma classificação completa, especifique as colunas na instrução CREATE INDEX na
seguinte ordem:
- Primeiro, todas as colunas que têm uma condição de igualdade (
=) ouINna consulta. - Em seguida, as mesmas colunas da cláusula
ORDER BYda consulta, na mesma ordem e com a mesma direção de classificação (ASCouDESC)
Por exemplo, suponha que você tenha uma tabela Users (não mostrada no esquema de exemplo anterior) e queira otimizar a seguinte consulta:
SELECT * FROM Users
WHERE Name='Alex'
ORDER BY LastLogin DESC
LIMIT 10;
Crie um índice em (Name, LastLogin DESC) para que o Spanner possa ler
as 10 primeiras linhas diretamente na ordem do índice sem classificação:
CREATE INDEX UsersByNameLastLogin ON Users(Name, LastLogin DESC);
Ordenar por sufixo de chave
Mesmo quando um índice inclui a coluna ORDER BY como um sufixo da chave de índice,
uma consulta ainda pode verificar linhas extras se houver um predicado IN, OR ou de intervalo
em uma das colunas de prefixo do índice.
Por exemplo, considere a consulta a seguir, que usa o índice (Name, LastLogin DESC)
do exemplo de classificação completa anterior, que não faz parte do esquema
de exemplo:
SELECT *
FROM Users
WHERE Name IN ('Alex','Amal')
ORDER BY LastLogin DESC
LIMIT 10;
Como Name corresponde a vários valores, as linhas correspondentes não são armazenadas em um
único intervalo classificado globalmente por LastLogin DESC. É possível reestruturar a consulta
usando UNNEST e uma mesclagem para que o Spanner recupere as primeiras linhas de
cada valor de Name separadamente e as combine:
SELECT *
FROM UNNEST(['Alex','Amal']) AS Name
JOIN Users AS u ON u.Name = Name
ORDER BY LastLogin DESC
LIMIT 10;
Essa reescrita resulta em verificações mais eficientes, lendo o número mínimo de linhas de cada chave de prefixo vinculada ('Alex' e 'Amal'), seguido por uma pequena classificação dos resultados combinados para produzir o LIMIT final.
Um caso especial comum desse padrão é um prefixo de fragmento, em que uma coluna ShardId
é adicionada como a coluna de chave principal para distribuir gravações entre divisões.
Por exemplo, a consulta a seguir verifica 32 fragmentos (0 a 31):
SELECT *
FROM Users
WHERE ShardId BETWEEN 0 AND 31
ORDER BY LastLogin DESC
LIMIT 10;
Para otimizar essa consulta, enumere explicitamente os IDs de fragmento (0 a 31)
e mescle-os com a tabela Users usando GENERATE_ARRAY no
GoogleSQL ou generate_series no PostgreSQL:
GoogleSQL
SELECT *
FROM GENERATE_ARRAY(0, 31) AS id
JOIN Users AS u ON u.ShardId = id
ORDER BY LastLogin DESC
LIMIT 10;
PostgreSQL
SELECT *
FROM generate_series(0, 31) AS id
JOIN Users AS u ON u.ShardId = id
ORDER BY LastLogin DESC
LIMIT 10;
Para mais informações sobre essas funções de geração de matrizes e séries, consulte
GENERATE_ARRAY para GoogleSQL e
generate_series para PostgreSQL.
Entender o desempenho da verificação
As seções a seguir descrevem as causas mais comuns de verificações lentas de tabelas ou índices e como mitigá-las.
Linhas excluídas
Por padrão, o Spanner retém linhas excluídas ou substituídas por uma hora para oferecer suporte a leituras históricas e recuperação pontual, e é possível aumentar esse período de armazenamento para até sete dias. Depois que uma versão de linha antiga passa pelo período de armazenamento, ela se torna qualificada para remoção durante a compactação de armazenamento em segundo plano, o que pode levar até sete dias. Até que uma versão de linha antiga seja compactada, as consultas que verificam o intervalo de chaves podem precisar ler as versões de linha excluídas ou substituídas e filtrá-las. Para mais informações sobre retenção de dados, consulte Recuperação pontual (PITR).
Para verificar se uma consulta verificou linhas excluídas, inspecione a métrica Linhas excluídas verificadas na visualização de detalhes do operador Verificar no painel de detalhes do visualizador do plano de consulta.
Para reduzir as verificações lentas causadas por um grande número de linhas excluídas recentemente, acione uma compactação de dados manual. Para mais informações, consulte Compactação manual de dados.
Linhas grandes
Para linhas pequenas (até algumas centenas de bytes), o custo de uma verificação depende principalmente do número de linhas verificadas. À medida que o tamanho da linha aumenta, o tamanho em bytes das linhas se torna mais significativo. No armazenamento orientado por linhas, o tamanho total da linha afeta o desempenho da verificação, não apenas o tamanho das colunas projetadas pela consulta.
Para consultas analíticas com muitas verificações em tabelas grandes, use o mecanismo colunar. Para mais informações, consulte Monitorar o mecanismo colunar.
Para consultas em conjuntos mais estreitos de linhas, se uma tabela tiver colunas grandes e colunas menores que são consultadas com frequência, considere as seguintes opções:
- Separe as colunas maiores em um grupo de localidade não padrão (que armazena as colunas especificadas separadamente no disco do restante da tabela) ou em uma tabela filha separada para que as verificações das colunas menores não leiam os dados da coluna grande. Para mais informações, consulte Criar e gerenciar grupos de localidade.
- Para otimizar ainda mais o tempo de leitura, duplique as colunas menores em um índice secundário com a mesma chave primária da tabela base, usando a cláusula
STORINGpara incluir as colunas menores.
Por exemplo, suponha que uma tabela Documents (que não faz parte do esquema de exemplo anterior) armazene uma string Metadata pequena ao lado de um objeto JSON Content grande. É possível criar um índice secundário que armazene apenas Metadata para que as consultas
que não precisam de Content possam verificar o índice menor em vez da tabela base:
CREATE TABLE Documents (
  Id INT64,
  Metadata STRING(MAX),
  Content JSON
) PRIMARY KEY (Id);

CREATE INDEX DocumentMetadata ON Documents(Id) STORING (Metadata);
Dados intercalados grandes
Quando as tabelas são intercaladas, o Spanner armazena fisicamente cada linha pai com as linhas filhas intercaladas em ordem de chave. Se uma tabela pai tiver muitas linhas filhas intercaladas ou se uma tabela filha tiver significativamente menos linhas do que as tabelas pai ou irmã, as verificações de intervalo na tabela menor serão mais esparsas e menos eficientes, porque a verificação precisará pular as linhas intercaladas das outras tabelas.
Por exemplo, considere o esquema a seguir (que não faz parte do esquema de exemplo anterior), em que Transaction e AuthorizedPerson estão intercalados em Account:
CREATE TABLE Account (
  AccountId INT64,
  -- Additional columns omitted
) PRIMARY KEY (AccountId);

CREATE TABLE Transaction (
  AccountId INT64,
  TransactionId STRING(MAX),
  -- Additional columns omitted
) PRIMARY KEY (AccountId, TransactionId),
INTERLEAVE IN PARENT Account;

CREATE TABLE AuthorizedPerson (
  AccountId INT64,
  SignerId INT64,
  Name STRING(MAX),
  -- Additional columns omitted
) PRIMARY KEY (AccountId, SignerId),
INTERLEAVE IN PARENT Account;
Se cada linha Account tiver milhares de linhas Transaction e apenas algumas
linhas AuthorizedPerson, uma verificação de intervalo em Account ou AuthorizedPerson terá um
custo por linha maior do que uma verificação de intervalo em Transaction (mesmo que o custo total
ainda seja menor). Isso acontece porque uma verificação de Transaction lê muitas
linhas contíguas de Transaction de uma só vez, enquanto uma verificação em Account ou
AuthorizedPerson tem menos linhas adjacentes da mesma tabela e precisa pular
as linhas intercaladas de Transaction.
Para otimizar as verificações de intervalo na tabela mais esparsa (Account ou AuthorizedPerson),
crie um índice secundário não intercalado que duplique as colunas necessárias para
sua consulta, semelhante à abordagem para linhas grandes:
CREATE INDEX AuthorizedPersonByAccount
  ON AuthorizedPerson(AccountId, SignerId)
  STORING (Name);
Usar a execução orientada a lotes
O Spanner pode executar verificações e operadores de consulta usando um método orientado a linhas (processando uma linha por vez) ou um método orientado a lotes (processando blocos de linhas por vez). As seções a seguir explicam como inspecionar e configurar verificações orientadas a lote e a execução de operadores orientados a lote.
Verificações em lote
Algumas consultas do Spanner podem se beneficiar do uso de um método de processamento orientado a lotes ao verificar dados, em vez do método de processamento orientado a linhas, que é mais comum. O processamento de verificações em lotes é uma maneira mais eficiente de processar grandes volumes de dados de uma só vez, além de permitir que as consultas alcancem menor utilização de CPU e latência.
A operação de verificação do Spanner sempre começa a execução no método orientado a linhas. Durante esse período, o Spanner coleta várias métricas de ambiente de execução. Em seguida, o Spanner aplica um conjunto de heurísticas com base no resultado dessas métricas para determinar o método de verificação ideal. Quando apropriado, o Spanner muda para um método de processamento orientado por lote para ajudar a melhorar a capacidade de processamento e o desempenho da verificação.
Casos de uso comuns
As consultas com as seguintes características geralmente se beneficiam do processamento orientado em lote:
- Verificações grandes em dados atualizados com pouca frequência
- Verificações com predicados em colunas de largura fixa
- Verificações com grandes contagens de busca (uma busca usa um índice para recuperar registros)
Casos de uso sem ganhos de desempenho
Nem todas as consultas se beneficiam do processamento orientado em lote. Os seguintes tipos de consulta têm melhor desempenho com o processamento de verificação orientado por linha:
- Consultas de pesquisa de pontos: consultas que buscam apenas uma linha.
- Consultas de verificação pequenas: verificações de tabela que verificam apenas algumas linhas, a menos que tenham grandes contagens de busca.
- Consultas com uma cláusula
LIMIT: consultas que interrompem a verificação depois de retornar um número fixo de linhas. - Consultas que leem dados de alta rotatividade: consultas em que mais de aproximadamente 10% dos dados lidos são atualizados com frequência.
- Consultas com linhas que contêm valores grandes: consultas em linhas que contêm valores maiores que 32.000 bytes (pré-compactação) em uma única coluna.
Verificar o método de verificação usado por uma consulta
Para verificar se a consulta usa processamento orientado em lote, processamento orientado por linha ou alterna automaticamente entre os dois métodos de verificação, siga estas etapas:
No console do Google Cloud , acesse a página Instâncias do Spanner.
Clique no nome da instância com a consulta que você quer investigar.
Na tabela Bancos de dados, clique no banco de dados com a consulta que você quer investigar.
No menu de navegação do Spanner, clique em Spanner Studio.
Clique em Nova guia do editor de SQL ou Nova guia.
No editor de consultas, digite sua consulta.
Clique em Executar.
O Spanner executa a consulta e mostra os resultados.
No painel do editor de consultas, clique na guia Explicação.
O Spanner mostra o visualizador do plano de execução da consulta. Cada card no gráfico representa um iterador. Para mais informações sobre planos de execução, consulte Planos de execução de consulta.
Clique no card do iterador Verificação de tabela para abrir um painel de informações.
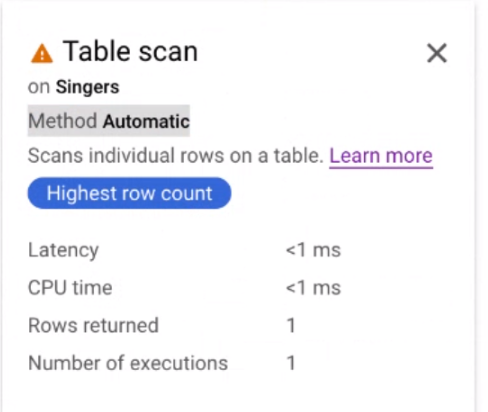
O painel de informações mostra dados contextuais sobre a verificação selecionada, incluindo o método de verificação (Método). Automático indica que o Spanner determina o método de verificação. Outros valores possíveis incluem Batch para processamento orientado a lotes e Row para processamento orientado a linhas, como mostrado na imagem a seguir:
Aplicar o método de verificação usado por uma consulta
Para otimizar o desempenho da consulta, o Spanner escolhe o método de verificação ideal para sua consulta. O Google recomenda que você use esse método de verificação padrão. No entanto, pode haver cenários em que você queira aplicar um tipo específico de método de verificação.
Aplicar a verificação em lote
É possível aplicar a verificação orientada por lote no nível da tabela e da instrução.
Para aplicar o método de verificação orientado por lote no nível da tabela, use uma dica de tabela na consulta:
GoogleSQL
SELECT *
FROM (Singers@{SCAN_METHOD=BATCH} AS s
  JOIN Albums AS a ON s.SingerId = a.SingerId);
PostgreSQL
SELECT *
FROM (Singers/*@ scan_method=batch */ AS s
  JOIN Albums AS a ON s.SingerId = a.SingerId);
Para aplicar o método de verificação orientado por lote no nível da instrução, use uma dica de instrução na consulta:
GoogleSQL
@{SCAN_METHOD=BATCH}
SELECT *
FROM Singers;
PostgreSQL
/*@ scan_method=batch */
SELECT *
FROM Singers;
Quando você usa uma dica no nível da instrução, ela é aplicada a toda a consulta. Definir a dica no nível da tabela é preferível e oferece um controle mais granular.
Forçar verificação orientada por linha
Embora o Google não recomende desativar o método de verificação automática definido pelo Spanner, é possível desativá-lo e usar o método de verificação orientado a linhas para fins de solução de problemas, como o diagnóstico de latência.
Para desativar a seleção automática do método de verificação e aplicar o processamento de linhas no nível da tabela, use uma dica de tabela na consulta:
GoogleSQL
SELECT *
FROM (Singers@{SCAN_METHOD=ROW} AS s
  JOIN Albums AS a ON s.SingerId = a.SingerId);
PostgreSQL
SELECT *
FROM (Singers/*@ scan_method=row */ AS s
  JOIN Albums AS a ON s.SingerId = a.SingerId);
Para desativar o método de verificação automática e aplicar o processamento de linhas no nível da instrução, use uma dica de instrução na consulta:
GoogleSQL
@{SCAN_METHOD=ROW}
SELECT *
FROM Singers;
PostgreSQL
/*@ scan_method=row */
SELECT *
FROM Singers;
Método de execução
Além das verificações orientadas por lote, também é possível otimizar a execução de consultas aplicando o método de execução no nível da instrução. Isso só funciona para alguns operadores e é independente do método de verificação, que é usado apenas pelo operador de verificação. Para mais informações sobre verificações orientadas a lote, consulte a seção Verificações orientadas a lote deste documento.
Por padrão, a maioria dos operadores é executada no método orientado por linha, que processa dados uma linha por vez. Os operadores vetorizados são executados no método orientado a lotes para ajudar a melhorar a capacidade de processamento e o desempenho da execução. Esses operadores processam dados um bloco por vez. Quando um operador precisa processar muitas linhas, o método de execução orientado por lote geralmente é mais eficiente.
Método de execução x método de verificação
O método de execução de consulta é independente do método de verificação de consulta. É possível definir um, ambos ou nenhum desses métodos na dica de consulta.
O método de execução de consulta se refere à maneira como os operadores de consulta processam resultados intermediários e como os operadores interagem entre si, enquanto o método de verificação se refere à maneira como o operador de verificação interage com a camada de armazenamento do Spanner.
Aplicar o método de execução usado pela consulta
Para otimizar o desempenho da consulta, o Spanner escolhe o método de execução ideal para sua consulta com base em várias heurísticas. O Google recomenda que você use esse método de execução padrão. No entanto, pode haver cenários em que você queira aplicar um tipo específico de método de execução.
É possível aplicar o método de execução no nível da instrução. A dica de consulta EXECUTION_METHOD é um aviso, não uma diretiva. Por fim,
o otimizador de consultas decide qual método usar para cada operador individual.
Para aplicar o método de execução orientado a lotes no nível da instrução, use uma dica de instrução na consulta:
GoogleSQL
@{EXECUTION_METHOD=BATCH}
SELECT *
FROM Singers;
PostgreSQL
/*@ EXECUTION_METHOD=BATCH */
SELECT *
FROM Singers;
Embora o Google não recomende desativar o método de execução automática definido pelo Spanner, é possível desativá-lo e usar o método de execução orientado a linhas para fins de solução de problemas, como diagnóstico de latência.
Para desativar o método de execução automática e aplicar o método de execução orientado por linha no nível da instrução, use uma dica de instrução na consulta:
GoogleSQL
@{EXECUTION_METHOD=ROW}
SELECT *
FROM Singers;
PostgreSQL
/*@ EXECUTION_METHOD=ROW */
SELECT *
FROM Singers;
Verificar qual método de execução está ativado
Nem todos os operadores do Spanner são compatíveis com os métodos de execução orientados a lote e a linha. Para cada operador, o visualizador do plano de execução de consulta mostra o método de execução no card do iterador. Se o método de execução for orientado a lote, ele vai mostrar Lote. Se for orientado por linha, ele mostrará Linha. Para mais informações sobre o visualizador, consulte Planos de execução de consultas.
Se os operadores na consulta forem executados usando métodos de execução diferentes, os adaptadores de método de execução DataBlockToRowAdapter e RowToDataBlockAdapter vão aparecer entre os operadores para mostrar a mudança no método de execução. Para mais
informações sobre esses operadores, consulte
DataBlockToRowAdapter e
RowToDataBlockAdapter.