


Auf dieser Seite wird beschrieben, wie Sie mit dem Query Insights-Dashboard Leistungsprobleme in Spanner erkennen und analysieren.
Query Insights – Übersicht
Mit Query Insights können Sie Leistungsprobleme bei Abfragen und DML-Anweisungen (INSERT, UPDATE und DELETE) für eine Spanner-Datenbank erkennen und diagnostizieren. Es unterstützt ein intuitives Monitoring und liefert Diagnoseinformationen, die Ihnen helfen, über die Erkennung hinaus die Ursache von Leistungsproblemen zu identifizieren.
Mit Query Insights können Sie die Leistung von Spanner-Abfragen verbessern. Dabei werden Sie durch die folgenden Schritte geführt:
- Prüfen Sie, ob ineffiziente Abfragen eine hohe CPU-Auslastung verursachen.
- Potenziell problematische Abfrage oder potenziell problematisches Tag identifizieren
- Abfrage oder Anfrage-Tag analysieren, um Probleme zu ermitteln
Query Insights ist in Konfigurationen für eine und mehrere Regionen verfügbar.
Preise
Für Query Insights fallen keine zusätzlichen Kosten an.
Datenaufbewahrung
Query Insights speichert Daten maximal 30 Tage lang.
Für das Diagramm Gesamte CPU-Auslastung (pro Abfrage oder Anfrage-Tag) ruft Spanner Daten aus den SPANNER_SYS.QUERY_STATS_TOP_*-Tabellen ab. Diese Tabellen haben eine maximale Aufbewahrungsdauer von 30 Tagen. Weitere Informationen finden Sie unter Datenaufbewahrung.
Erforderliche Rollen
Sie benötigen unterschiedliche IAM-Rollen und -Berechtigungen, je nachdem, ob Sie ein IAM-Nutzer oder ein Nutzer mit detaillierter Zugriffssteuerung sind.
IAM-Nutzer (Identity and Access Management)
Bitten Sie Ihren Administrator, Ihnen die folgenden IAM-Rollen für die Instanz zuzuweisen, um die Berechtigungen zu erhalten, die Sie zum Aufrufen der Seite „Query Insights“ benötigen:
- Cloud Spanner-Betrachter (
roles/spanner.viewer) - Cloud Spanner-Datenbank-Leser (
roles/spanner.databaseReader)
Die folgenden Berechtigungen in der Rolle Cloud Spanner-Datenbankleser (
roles/spanner.databaseReader) sind erforderlich, um die Seite „Query Insights“ aufzurufen:
spanner.databases.beginReadOnlyTransactionspanner.databases.selectspanner.sessions.create
Nutzer mit detaillierter Zugriffssteuerung
Wenn Sie die detaillierte Zugriffssteuerung verwenden, prüfen Sie Folgendes:
- Cloud Spanner-Betrachter (
roles/spanner.viewer) - Sie haben detaillierte Zugriffssteuerungsberechtigungen und Ihnen wurde die Systemrolle
spanner_sys_readeroder eine ihrer Mitgliedsrollen zugewiesen. - Wählen Sie auf der Datenbankübersichtsseite die Rolle
spanner_sys_readeroder eine Mitgliedsrolle als Ihre aktuelle Systemrolle aus.
Weitere Informationen finden Sie unter Detaillierte Zugriffssteuerung und Systemrollen für die detaillierte Zugriffssteuerung.
Das Query Insights-Dashboard
Im Query Insights-Dashboard wird die Abfragelast basierend auf der Datenbank und dem Zeitraum angezeigt, die Sie auswählen. Die Abfragelast ist ein Maß für die gesamte CPU-Auslastung aller Abfragen in der Instanz im ausgewählten Zeitraum. Das Dashboard bietet eine Reihe von Filtern, mit denen Sie die Abfragelast anzeigen können.
So rufen Sie das Query Insights-Dashboard für eine Datenbank auf:
- Wählen Sie im linken Navigationsbereich Query Insights aus. Das Dashboard „Query Insights“ wird geöffnet.
- Wählen Sie eine Datenbank aus der Liste Datenbanken aus. Das Dashboard zeigt die Informationen zur Abfragelast für die Datenbank an.
Zu den Bereichen des Dashboards gehören:
- Datenbankliste: Filtert die Abfragelast für eine bestimmte Datenbank oder für alle Datenbanken.
- Zeitraumfilter: Filtert die Abfragelast nach Zeiträumen, z. B. Stunden, Tage oder einen benutzerdefinierten Bereich.
- Diagramm „Gesamte CPU-Auslastung (alle Abfragen)“: Zeigt die aggregierte durchschnittliche CPU-Auslastung (in CPU-Sekunden pro Minute) aller Abfragen an.
- Diagramm „Gesamte CPU-Auslastung“ (pro Abfrage oder Anfrage-Tag): Zeigt die durchschnittliche CPU-Auslastung (in CPU-Sekunden pro Minute) für jede Abfrage oder jedes Anfrage-Tag an.
- Tabelle mit den Top-N-Abfragen und ‑Tags: Zeigt die Liste der Top-Abfragen und ‑Anfrage-Tags an, sortiert nach CPU-Auslastung. Weitere Informationen finden Sie unter Potenziell problematische Abfrage oder potenziell problematisches Tag identifizieren.

Dashboard-Leistung
Verwenden Sie Abfrageparameter oder taggen Sie Ihre Abfragen, um die Leistung von Query Insights zu optimieren. Wenn Sie Ihre Abfragen nicht parametrisieren oder taggen, werden möglicherweise zu viele Ergebnisse zurückgegeben. Dies kann dazu führen, dass die Tabelle mit den TopN-Abfragen und -Tags nicht richtig geladen wird.
Prüfen, ob ineffiziente Abfragen für die hohe CPU-Auslastung verantwortlich sind
Die gesamte CPU-Auslastung ist ein Maß für die durchschnittliche CPU-Nutzung (in CPU-Sekunden pro Minute), die von den ausgeführten Abfragen in der ausgewählten Datenbank im Zeitverlauf ausgeführt wird.
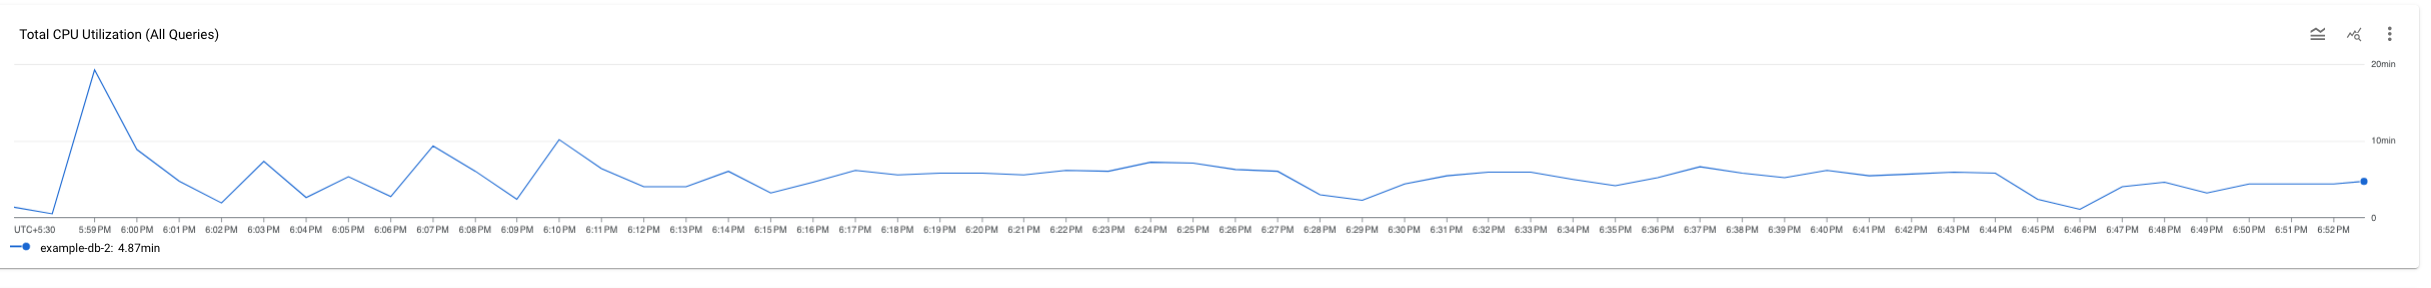
Sehen Sie sich die Grafik an, um diese Fragen zu untersuchen:
Welche Datenbank hat die Auslastung? Wählen Sie in der Liste „Datenbanken“ verschiedene Datenbanken aus, um die Datenbanken mit den höchsten Lasten zu finden. Wenn Sie herausfinden möchten, welche Datenbank die höchste Last hat, können Sie sich auch das Diagramm CPU-Auslastung – Gesamt für Datenbanken in der Google Cloud Console ansehen.
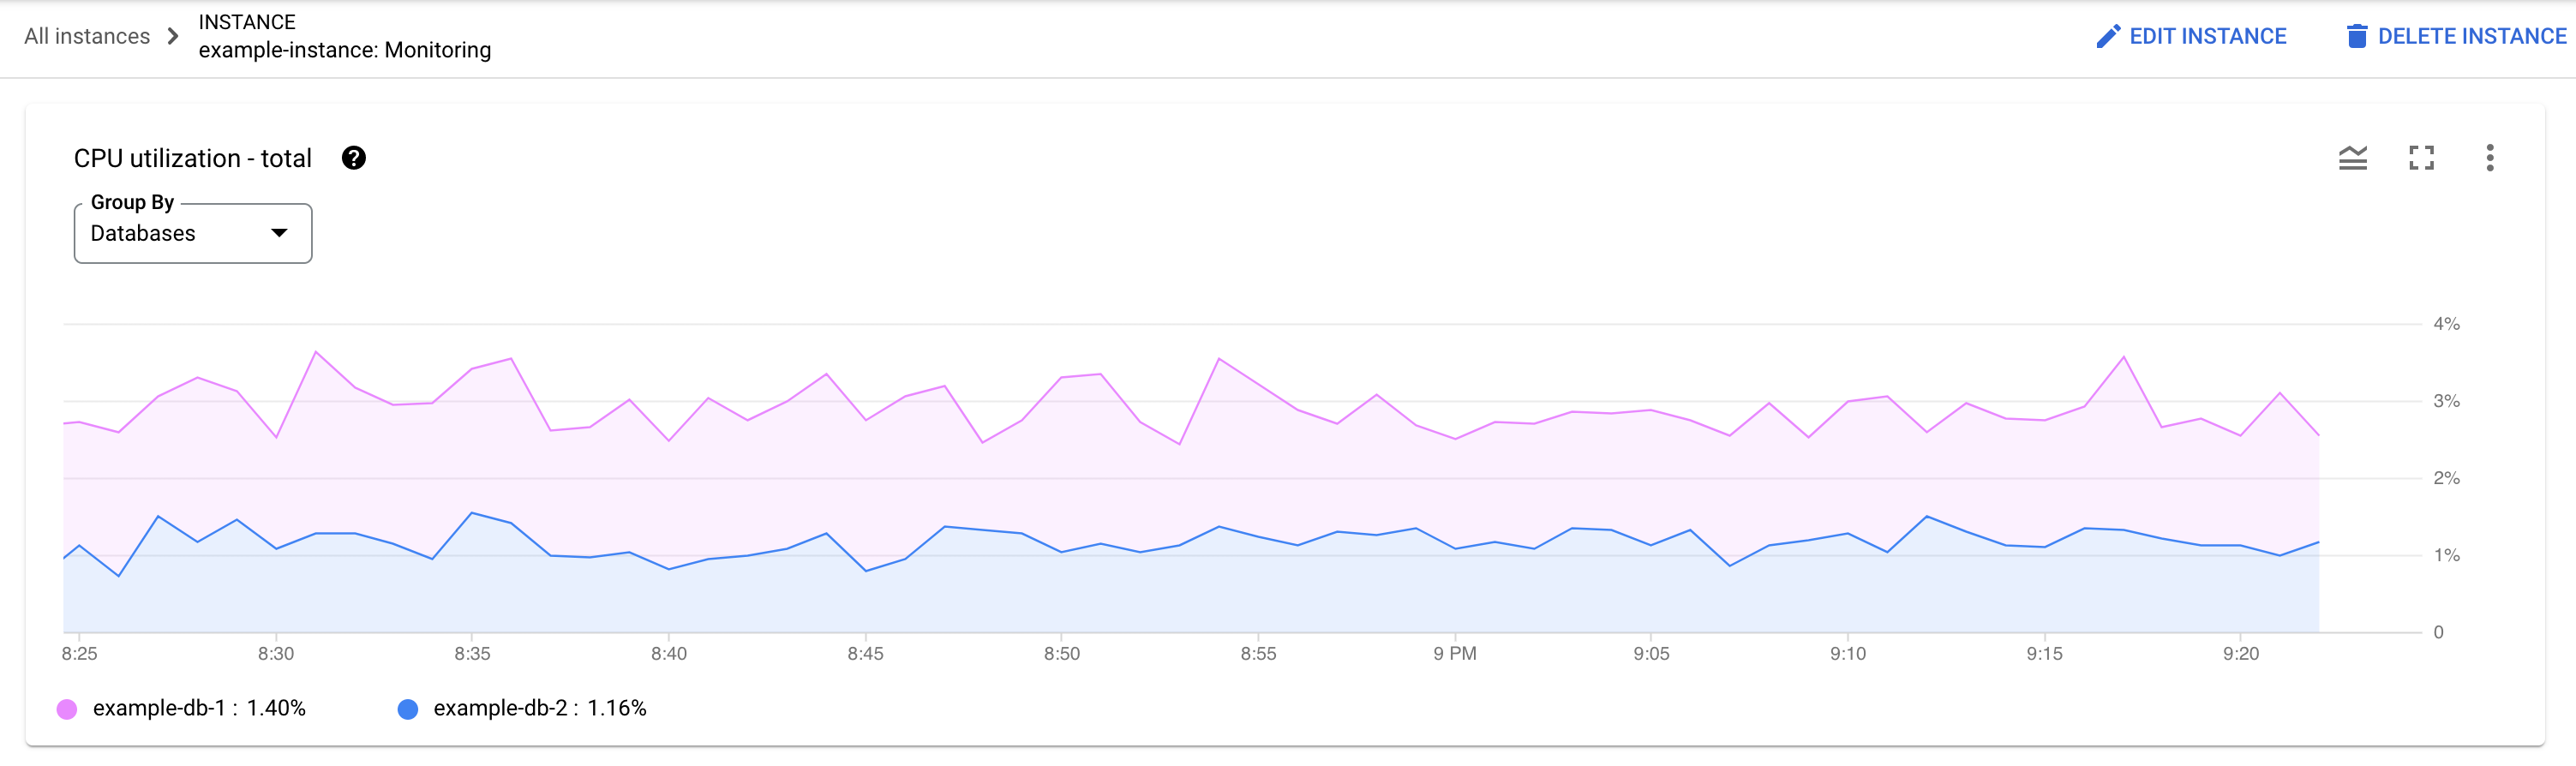
Ist die CPU-Auslastung hoch? Ist eine Spitze oder ein Anstieg im Zeitverlauf zu sehen? Wenn keine hohe CPU-Auslastung angezeigt wird, liegt das Problem nicht bei Ihren Abfragen.
Wie lange war die CPU-Auslastung hoch? Ist sie vor Kurzem sprunghaft angestiegen oder ist sie schon seit einiger Zeit konstant hoch? Verwenden Sie die Bereichsauswahl, um verschiedene Zeiträume auszuwählen, um herauszufinden, wie lange das Problem besteht. Vergrößern Sie die Ansicht, um ein Zeitfenster zu sehen, in dem Spitzen bei der Abfragelast beobachtet werden. Zoomen Sie heraus, um bis zu einer Woche der Zeitachse anzuzeigen.
Wenn Sie in der Grafik einen Anstieg oder eine Erhöhung der CPU-Auslastung der gesamten Instanz sehen, liegt das wahrscheinlich an einer oder mehreren teuren Abfragen. Als Nächstes können Sie die Fehlerbehebung vertiefen, indem Sie eine potenziell problematische Abfrage oder ein Anfrage-Tag identifizieren.
Potenziell problematische Abfrage oder potenziell problematisches Anfrage-Tag identifizieren
Sehen Sie sich den Abschnitt mit den Top-N-Abfragen an, um eine potenziell problematische Abfrage oder ein potenziell problematisches Anfrage-Tag zu identifizieren:

Hier sehen wir, dass die Abfrage mit dem Fingerabdruck 3216067328234137024 eine hohe CPU-Auslastung hat und problematisch sein kann.
Die Tabelle Top-N-Abfragen bietet einen Überblick über die Abfragen, die im ausgewählten Zeitraum die meiste CPU-Leistung verbrauchen, sortiert von der höchsten zur niedrigsten. Die Anzahl der TopN-Abfragen ist auf 100 beschränkt.
Für die Diagramme werden die Daten aus der Tabelle mit den Top-N-Abfragestatistiken abgerufen, die drei verschiedene Detaillierungsgrade hat: 1 Minute, 10 Minuten und 1 Stunde. Der Wert für jeden Datenpunkt in den Diagrammen stellt den Durchschnittswert über ein Intervall von einer Minute dar.
Wir empfehlen, Tags zu SQL-Abfragen hinzuzufügen. Mit der Tag-Kennzeichnung von Abfragen können Sie Probleme auf übergeordneten Konstrukten finden, z. B. mit der Geschäftslogik oder einem Mikrodienst.

Die Tabelle enthält die folgenden Attribute:
- Fingerabdruck: Hash des Anfrage-Tags oder, falls das Tag nicht vorhanden ist, ein Hash des Abfragetextes.
Abfrage- oder Anfrage-Tag: Wenn die Abfrage ein Tag enthält, wird das Anfrage-Tag angezeigt. Statistiken für mehrere Abfragen mit demselben Tag-String werden in einer einzigen Zeile gruppiert, wobei der
REQUEST_TAG-Wert mit dem Tag-String übereinstimmt. Weitere Informationen zur Verwendung von Anfrage-Tags finden Sie unter Fehlerbehebung bei Anfrage- und Transaktions-Tags.Wenn die Abfrage kein zugehöriges Tag hat, wird die SQL-Abfrage auf etwa 64 KB gekürzt angezeigt. Bei Batch-DML werden die SQL-Anweisungen in einer einzelnen Zeile zusammengefasst und mit einem Semikolon als Trennzeichen verkettet. Aufeinanderfolgende identische SQL-Texte werden vor dem Kürzen dedupliziert.
Abfragetyp: Gibt an, ob eine Abfrage vom Typ
PARTITIONED_QUERYoderQUERYist. EinePARTITIONED_QUERYist eine Abfrage mit einempartitionToken, das von der PartitionQuery API abgerufen wird. Alle anderen Abfragen und DML-Anweisungen werden mit dem AbfragetypQUERYgekennzeichnet.CPU-Auslastung: CPU-Ressourcenverbrauch durch eine Abfrage als Prozentsatz der gesamten CPU-Ressourcen, die von allen Abfragen verwendet werden, die in diesem Zeitraum in den Datenbanken ausgeführt werden. Dies wird in einem horizontalen Balken mit einem Bereich von 0 bis 100 angezeigt.
Empfehlung: Spanner analysiert Ihre Abfragen, um festzustellen, ob sie von verbesserten Indexen profitieren können. In diesem Fall werden neue oder geänderte Indexe empfohlen, mit denen sich die Abfrageleistung verbessern lässt. Weitere Informationen finden Sie unter Spanner-Indexberater verwenden.
CPU (%): CPU-Ressourcenverbrauch durch eine Abfrage als Prozentsatz der gesamten CPU-Ressourcen, die von allen Abfragen verwendet werden, die in diesem Zeitraum in den Datenbanken ausgeführt werden.
Ausführungsanzahl: Die durchschnittliche Rate der Abfrageausführungen in Ausführungen pro Minute, die Spanner während des Intervalls erkannt hat.
Durchschnittliche Latenz (ms): Durchschnittliche Dauer in Mikrosekunden für jede Abfrageausführung in der Datenbank. Dieser Durchschnittswert schließt die Codierungs- und Übertragungszeit für die Ergebnismenge sowie den Overhead aus.
Durchschnittlich gescannte Zeilen: Durchschnittliche Anzahl der Zeilen, die von der Abfrage gescannt wurden, ohne gelöschte Werte.
Durchschnittliche zurückgegebene Zeilen: Durchschnittliche Anzahl der Zeilen, die von der Abfrage zurückgegeben wurden.
Zurückgegebene Byte: Anzahl der von der Abfrage zurückgegebenen Datenbyte, ohne den Overhead für die Übertragungscodierung.
Mögliche Abweichungen zwischen den Diagrammen
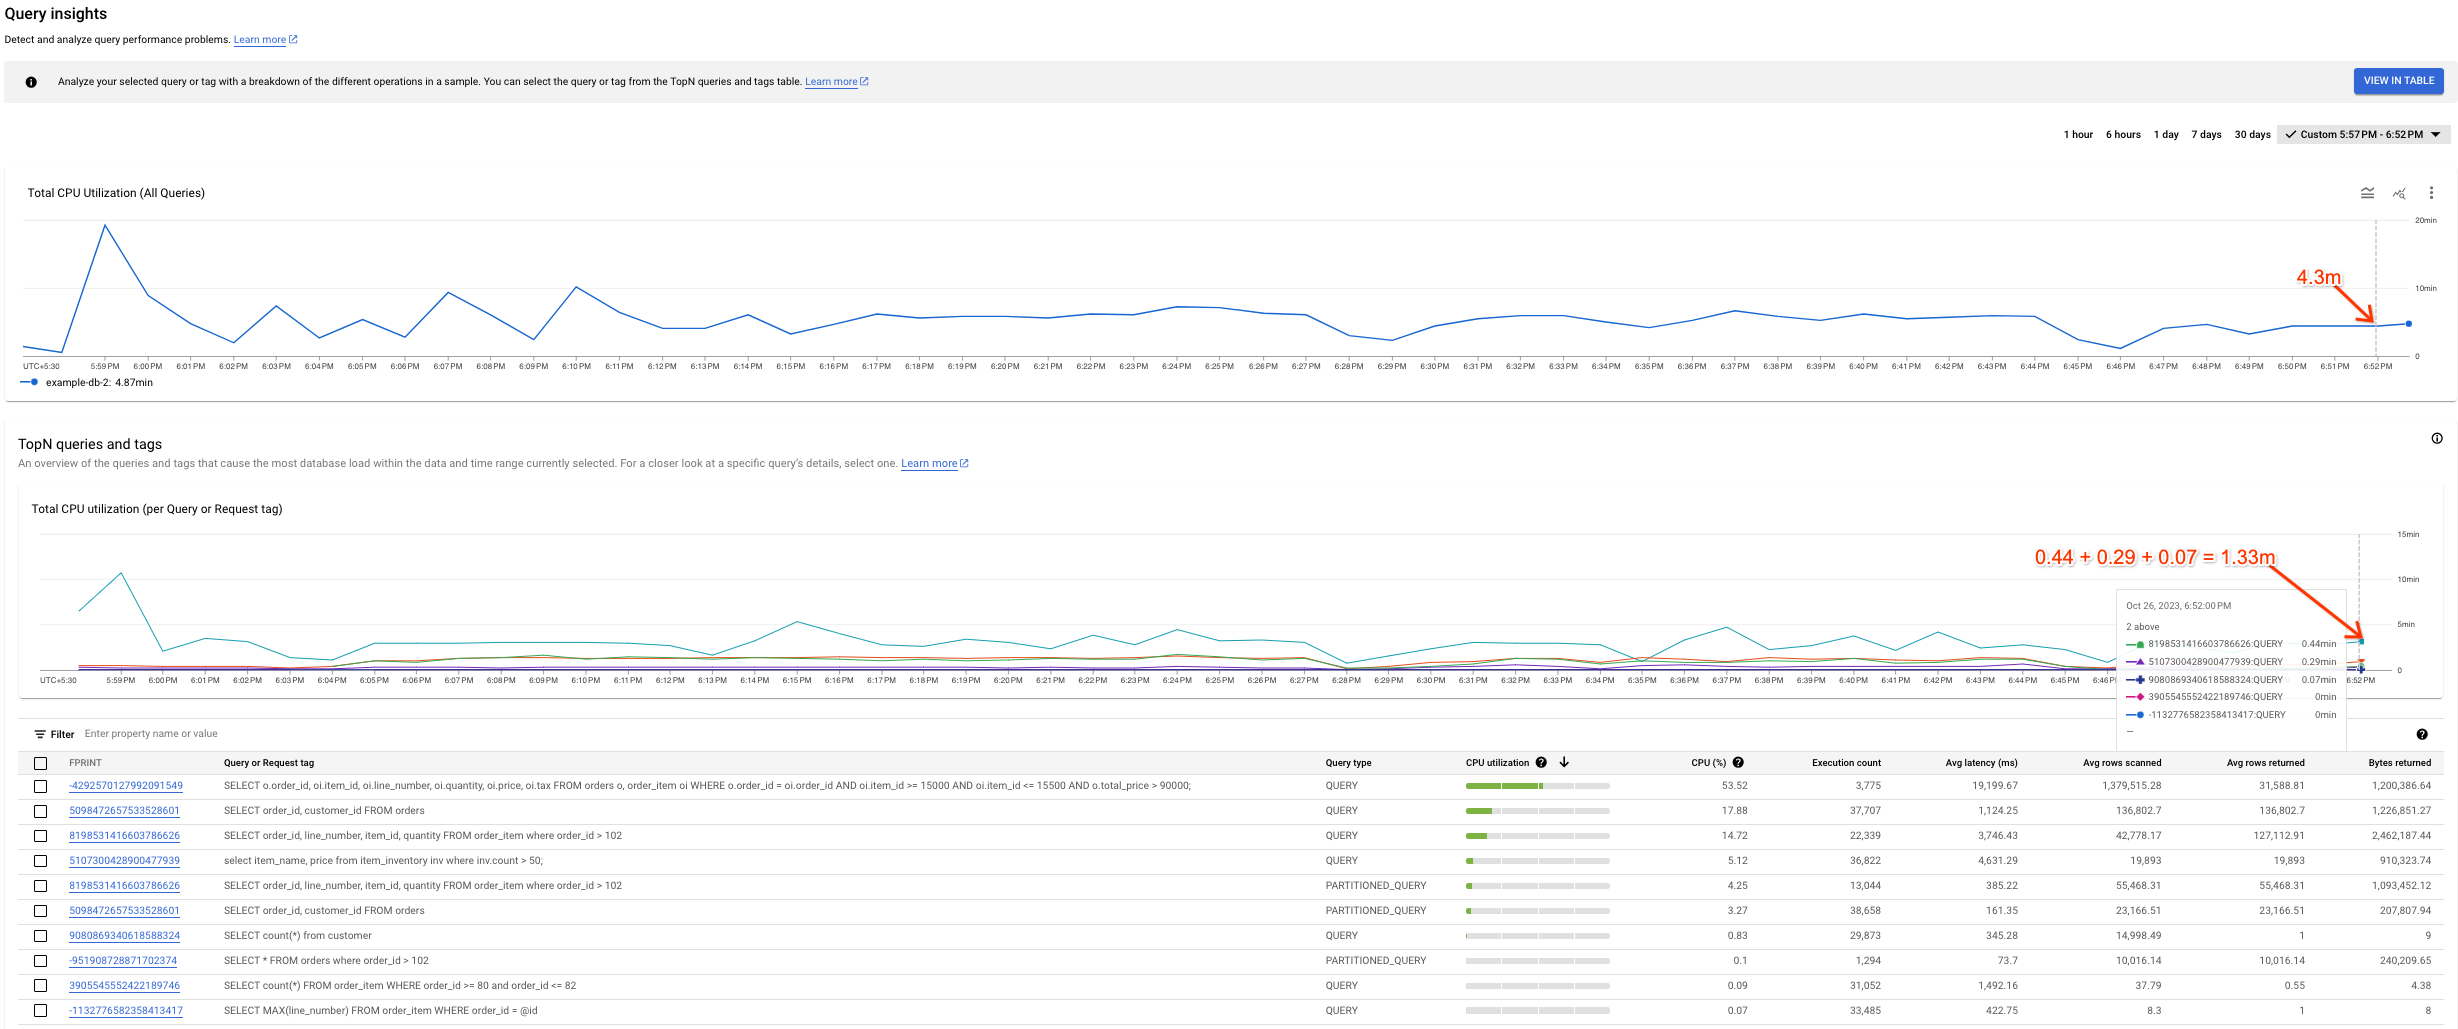
Möglicherweise stellen Sie Abweichungen zwischen dem Diagramm Gesamte CPU-Auslastung (alle Abfragen) und dem Diagramm Gesamte CPU-Auslastung (pro Abfrage oder Anfrage-Tag) fest. Es gibt zwei Dinge, die zu diesem Szenario führen könnten:
Unterschiedliche Datenquellen: Die Cloud Monitoring-Daten, die in das Diagramm „CPU-Gesamtauslastung (alle Abfragen)“ einfließen, sind in der Regel genauer, da sie jede Minute übertragen werden und eine Aufbewahrungsdauer von 45 Tagen haben. Andererseits werden die Systemtabellendaten, die in das Diagramm „Gesamte CPU-Auslastung (pro Abfrage oder Anfrage-Tag)“ einfließen, möglicherweise über 10 Minuten (oder 1 Stunde) gemittelt. In diesem Fall gehen möglicherweise Daten mit hoher Granularität verloren, die im Diagramm „Gesamte CPU-Auslastung (alle Abfragen)“ zu sehen sind.
Unterschiedliche Aggregationsfenster: Beide Diagramme haben unterschiedliche Aggregationsfenster. Wenn Sie beispielsweise ein Ereignis prüfen, das älter als 6 Stunden ist, fragen Sie die Tabelle
SPANNER_SYS.QUERY_STATS_TOTAL_10MINUTEab. In diesem Fall wird ein Ereignis, das um 10:01 Uhr auftritt, über 10 Minuten aggregiert und in der Systemtabelle mit dem Zeitstempel 10:10 Uhr angezeigt.
Der folgende Screenshot zeigt ein Beispiel für eine solche Abweichung.
Bestimmte Abfrage oder bestimmtes Anfrage-Tag analysieren
Wenn Sie feststellen möchten, ob eine Abfrage oder ein Anfrage-Tag die Ursache des Problems ist, klicken Sie auf die Abfrage oder das Anfrage-Tag, die bzw. das die höchste Last zu verursachen scheint oder länger als die anderen dauert. Sie können mehrere Abfragen und Anfrage-Tags gleichzeitig auswählen.
Sie können den Mauszeiger auf das Diagramm für Abfragen auf der Zeitachse bewegen, um die CPU-Auslastung (in Sekunden) zu sehen.
Versuchen Sie, das Problem folgendermaßen einzugrenzen:
- Wie lange war die Last hoch? Ist sie nur jetzt hoch? Oder ist sie schon lange hoch? Ändern Sie die Zeiträume, um das Datum und die Uhrzeit zu ermitteln, zu der sich die Leistung der Abfrage verschlechterte.
- Gibt es Spitzen bei der CPU-Auslastung? Sie können das Zeitfenster ändern, um die bisherige CPU-Auslastung für die Abfrage zu untersuchen.
- Wie hoch ist der Ressourcenverbrauch? Wie hängt er mit anderen Abfragen zusammen? Sehen Sie sich die Tabelle an und vergleichen Sie die Daten anderer Abfragen mit der ausgewählten Abfrage. Gibt es einen großen Unterschied?
Um zu bestätigen, dass die ausgewählte Abfrage zur hohen CPU-Auslastung beiträgt, können Sie die Details der jeweiligen Abfrageform (oder des Anfrage-Tags) aufschlüsseln und auf der Seite „Abfragedetails“ weiter analysieren.
Detailseite der Abfrage aufrufen
Wenn Sie die Details einer bestimmten Abfrageform oder eines bestimmten Anfrage-Tags in grafischer Form aufrufen möchten, klicken Sie auf den Fingerabdruck, der mit der Abfrage oder dem Anfrage-Tag verknüpft ist. Die Seite „Abfragedetails“ wird geöffnet.

Auf der Seite „Abfragedetails“ werden die folgenden Informationen angezeigt:
- Abfragedetails (Text): SQL-Abfragetext, gekürzt auf etwa 64 KB. Statistiken für mehrere Abfragen mit demselben Tag-String werden in einer einzigen Zeile gruppiert, wobei das REQUEST_TAG mit diesem Tag-String übereinstimmt. In diesem Feld wird nur der Text einer dieser Anfragen angezeigt. Bei Batch-DML wird die Gruppe von SQL-Anweisungen in eine einzelne Zeile zusammengefasst und durch ein Semikolon getrennt. Aufeinanderfolgende identische SQL-Texte werden vor dem Kürzen dedupliziert.
- Die Werte der folgenden Felder:
- Ausführungsanzahl: Die durchschnittliche Rate der Abfrageausführungen in Ausführungen pro Minute, die Spanner während des Intervalls erkannt hat.
- Durchschn. CPU (ms): Durchschnittlicher CPU-Ressourcenverbrauch in Millisekunden durch eine Abfrage der CPU-Ressourcen der Instanz in einem Zeitintervall.
- Durchschn. Latenz (ms): Durchschnittliche Dauer in Millisekunden für jede Abfrageausführung in der Datenbank. In diesem Durchschnitt sind die Codierungs- und Übertragungszeit für die Ergebnismenge und der Overhead nicht enthalten.
- Durchschnittlich zurückgegebene Zeilen: Durchschnittliche Anzahl der Zeilen, die von der Abfrage zurückgegeben wurden.
- Durchschnittlich gescannte Zeilen: Durchschnittliche Anzahl der Zeilen, die von der Abfrage gescannt wurden, ohne gelöschte Werte.
- Durchschnittliche Byte: Anzahl der von der Abfrage zurückgegebenen Datenbyte, ohne den Overhead für die Übertragungscodierung.
- Diagramm mit Abfrageplanbeispielen: Jeder Punkt im Diagramm stellt einen Abfrageplan zu einem bestimmten Zeitpunkt und die zugehörige Abfragelatenz dar. Klicken Sie auf einen der Punkte im Diagramm, um den Abfrageplan aufzurufen und die Schritte während der Abfrageausführung zu visualisieren. Hinweis: Abfragepläne werden für Abfragen mit Partitionstokens, die von der PartitionQuery API abgerufen wurden, und für partitionierte DML-Abfragen nicht unterstützt.
Abfrageplan-Visualisierung: Zeigt den ausgewählten Abfrageplan an. Spanner bietet die folgenden Layoutoptionen:
- Baumansicht: In der Baumansicht wird der Abfrageplan als Diagramm dargestellt, in dem jeder Knoten oder jede Karte einen Iterator darstellt, der Zeilen aus seinen Eingaben verarbeitet und Zeilen für seinen übergeordneten Knoten erzeugt. Sie können auf jeden Iterator klicken, um weitere Informationen zu erhalten.
Sequenzielle Ansicht: In der sequenziellen Ansicht wird der Abfrageplan in einer hierarchischen Tabelle visualisiert, in der jede Zeile einen Operator darstellt. Sie können auf jede Zeile klicken, um weitere Informationen zu erhalten.
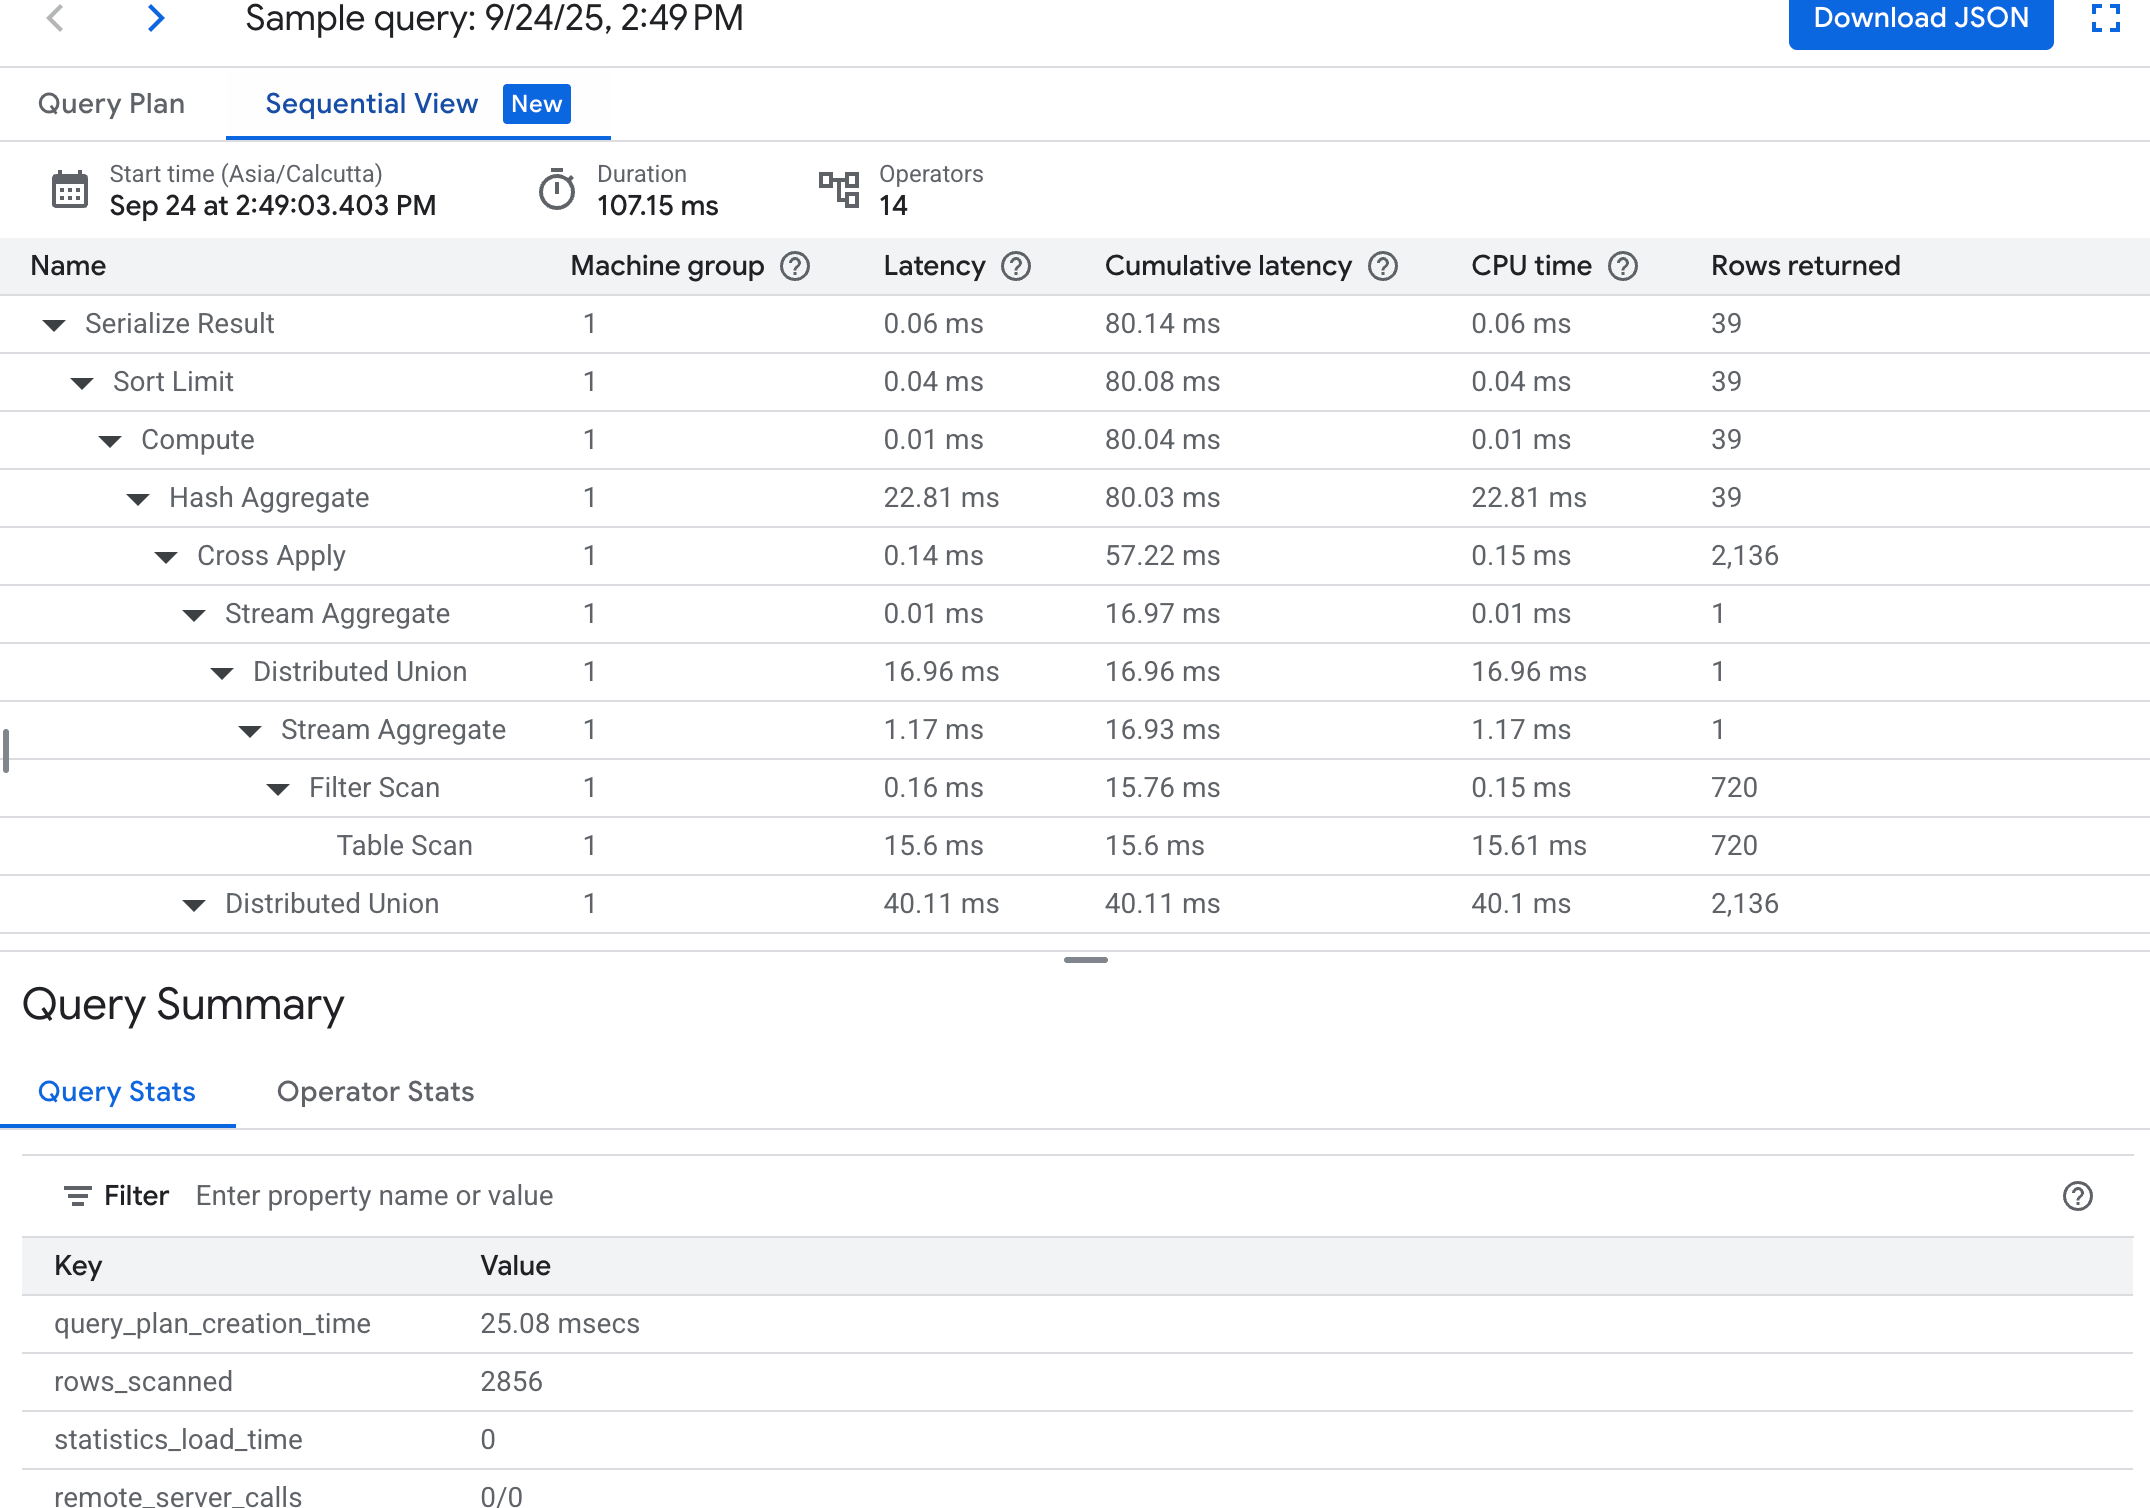
Die Tabelle enthält die folgenden Spalten:
- Name: Der Name des Operators.
- Maschinengruppe: Die Maschinengruppe, in der dieser Operator ausgeführt wurde.
- Latenz: Die Zeit, die während der Ausführung des aktuellen Vorgangs verstrichen ist. Dies kann mehr als die CPU-Zeit sein, beispielsweise wenn der Operator auf Remote-Aufrufe gewartet hat oder eine Verzögerung im Dateisystem vorlag.
- Kumulative Latenz: Die Zeit, die während der Ausführung des gesamten Unterbaums mit diesem Operator als Stamm verstrichen ist. Die Zeit für die Planerstellung und anderweitigen Aufwand ist nicht enthalten. Daher kann die kumulative Latenz kürzer als die Gesamtdauer der Abfrage sein.
- CPU-Zeit: CPU-Zeit für die gesamte Ausführung der Abfrage. exkl. Netzwerklatenz. Einige Teile der Abfrageausführung laufen möglicherweise parallel, sodass die CPU-Zeit länger als die gesamte verstrichene Zeit sein kann. Wenn eine Abfrage beispielsweise zehn parallele Vorgänge in 1 Millisekunde (ms) ausführt, beträgt die verstrichene Zeit 1 ms, die CPU-Zeit jedoch 10 ms.
- Zurückgegebene Zeilen: Die Anzahl der Zeilen, die vom Operator zurückgegeben wurden.
Grafik zur Abfragelatenz: Zeigt den Wert der Abfragelatenz für eine ausgewählte Abfrage über einen bestimmten Zeitraum an. Außerdem wird die durchschnittliche Latenz angezeigt.
Diagramm zur CPU-Auslastung: Zeigt die CPU-Auslastung durch eine Abfrage in Prozent über einen bestimmten Zeitraum an. Außerdem wird die durchschnittliche CPU-Auslastung angezeigt.
Diagramm „Ausführungsanzahl/Fehlgeschlagen“: Zeigt die durchschnittliche Rate der Abfrageausführungen (in Ausführungen pro Minute) über einen Zeitraum und die durchschnittliche Rate der fehlgeschlagenen Abfrageausführungen (in fehlgeschlagenen Ausführungen pro Minute) an.
Diagramm „Gescannte Zeilen“: Zeigt die Anzahl der Zeilen, die die Abfrage über einen bestimmten Zeitraum gescannt hat.
Diagramm „Zurückgegebene Zeilen“: Zeigt die Anzahl der Zeilen an, die die Abfrage über einen bestimmten Zeitraum zurückgegeben hat.
Zeitraumfilter: Filtert Abfragedetails nach Zeiträumen, z. B. Stunde, Tag oder einen benutzerdefinierten Bereich.
Für die Diagramme werden die Daten aus der Tabelle mit den Top-N-Abfragestatistiken abgerufen, die drei verschiedene Detaillierungsgrade hat: 1 Minute, 10 Minuten und 1 Stunde. Der Wert für jeden Datenpunkt in den Diagrammen stellt den Durchschnittswert über ein Intervall von einer Minute dar.
Im Audit-Log nach allen Ausführungen einer Abfrage suchen
Wenn Sie in Cloud-Audit-Logs nach allen Ausführungen eines bestimmten Abfrage-Fingerabdrucks suchen möchten, fragen Sie das Audit-Log ab und suchen Sie nach allen query_fingerprint, die mit dem Feld Fingerprint in der Tabelle mit den TopN-Abfragestatistiken übereinstimmen. Weitere Informationen finden Sie unter Logs abfragen und ansehen. Verwenden Sie diese Methode, um den Nutzer zu identifizieren, der die Abfrage initiiert hat.