


En esta página, se describe cómo usar el panel de Estadísticas de consultas para detectar y analizar problemas de rendimiento de Spanner.
Descripción general de las estadísticas de consultas
Las estadísticas de consultas te ayudan a detectar y diagnosticar problemas de rendimiento de las consultas y de las
declaraciones de DML (INSERT, UPDATE y DELETE)
en una base de datos de Spanner. Admite
la supervisión intuitiva y proporciona información de diagnóstico que te ayuda a ir
más allá de la detección para identificar la causa raíz de los problemas de rendimiento.
Estadísticas de consultas te ayuda a mejorar el rendimiento de las consultas de Spanner guiándote a través de los siguientes pasos:
- Determina si las consultas ineficientes causan un uso alto de CPU.
- Identifica una búsqueda o etiqueta que podría ser problemática.
- Analiza la búsqueda o la etiqueta de solicitud para identificar problemas.
Estadísticas de consultas está disponible en configuraciones regionales y multirregionales.
Precios
No hay costos adicionales para Estadísticas de consultas.
Retención de datos
Las Estadísticas de consultas retienen los datos durante un máximo de 30 días.
Para el gráfico Uso de CPU total (por etiqueta de consulta o solicitud), Spanner recupera datos de las tablas SPANNER_SYS.QUERY_STATS_TOP_*. Estas tablas tienen una retención máxima
de 30 días. Consulta Retención de datos
para obtener más información.
Roles obligatorios
Necesitas diferentes roles y permisos de IAM según si eres un usuario de IAM o un usuario de control de acceso detallado.
Usuario de Identity and Access Management (IAM)
Para obtener los permisos que necesitas para ver la página de Estadísticas de consultas, pídele a tu administrador que te otorgue los siguientes roles de IAM en la instancia:
- Visualizador de Cloud Spanner (
roles/spanner.viewer) - Lector de base de datos de Cloud Spanner (
roles/spanner.databaseReader)
Para ver la página de Estadísticas de consultas, se necesitan los siguientes permisos del rol Lector de bases de datos de Cloud Spanner(
roles/spanner.databaseReader):
spanner.databases.beginReadOnlyTransactionspanner.databases.selectspanner.sessions.create
Usuario con control de acceso detallado
Si eres un usuario con control de acceso detallado, verifica que cumplas con los siguientes requisitos:
- Tener el rol de visualizador de Cloud Spanner (
roles/spanner.viewer) - Tienen privilegios de control de acceso detallado y se les otorga el rol del sistema
spanner_sys_readero uno de sus roles de miembro. - Selecciona el rol
spanner_sys_readero un rol de miembro como tu rol actual del sistema en la página de resumen de la base de datos.
Para obtener más información, consulta Acerca del control de acceso detallado y Roles del sistema de control de acceso detallado.
El panel de Estadísticas de consultas
En el panel de Estadísticas de consultas, se muestra la carga de consultas según la base de datos y el período que selecciones. La carga de consultas es una medición del uso total de CPU para todas las consultas en la instancia del intervalo de tiempo seleccionado. En el panel, se proporciona una serie de filtros que te ayudan a ver la carga de consultas.
Para ver el panel de Estadísticas de consultas de una base de datos, haz lo siguiente:
- Selecciona Estadísticas de consultas en el panel de navegación izquierdo. Se abrirá el panel de Estadísticas de consultas.
- Selecciona una base de datos de la lista Bases de datos. En el panel, se muestra la información de carga de consultas de la base de datos.
Las áreas del panel incluyen:
- Lista de bases de datos: Filtra la carga de consultas en una base de datos específica o en todas las bases de datos.
- Filtro de intervalo de tiempo: Filtra la carga de consultas por intervalos de tiempo, como horas, días o un intervalo personalizado.
- Gráfico de uso total de CPU (todas las consultas): Muestra la tasa promedio agregada de uso de CPU (en segundos de CPU por minuto) de todas las consultas.
- Gráfico de uso total de CPU (por etiqueta de consulta o solicitud): Muestra la tasa promedio de uso de CPU (en segundos de CPU por minuto) por cada etiqueta de consulta o solicitud.
- Tabla de consultas y etiquetas de TopN: Muestra la lista de consultas y etiquetas de solicitud principales ordenadas por uso de CPU. Consulta Identifica una búsqueda o etiqueta que podría ser problemática.

Rendimiento del panel
Usa parámetros de consulta o etiqueta tus consultas para optimizar el rendimiento de las Estadísticas de consultas. Si no parametrizas ni etiquetas tus consultas, es posible que se devuelvan demasiados resultados, lo que podría causar que la tabla de consultas y etiquetas TopN no se cargue correctamente.
Confirma si las consultas ineficientes son responsables del uso elevado de CPU
El uso de CPU total es una medición de la tasa promedio de uso de CPU (en segundos de CPU por minuto) que realizan con el tiempo las consultas ejecutadas en la base de datos seleccionada.
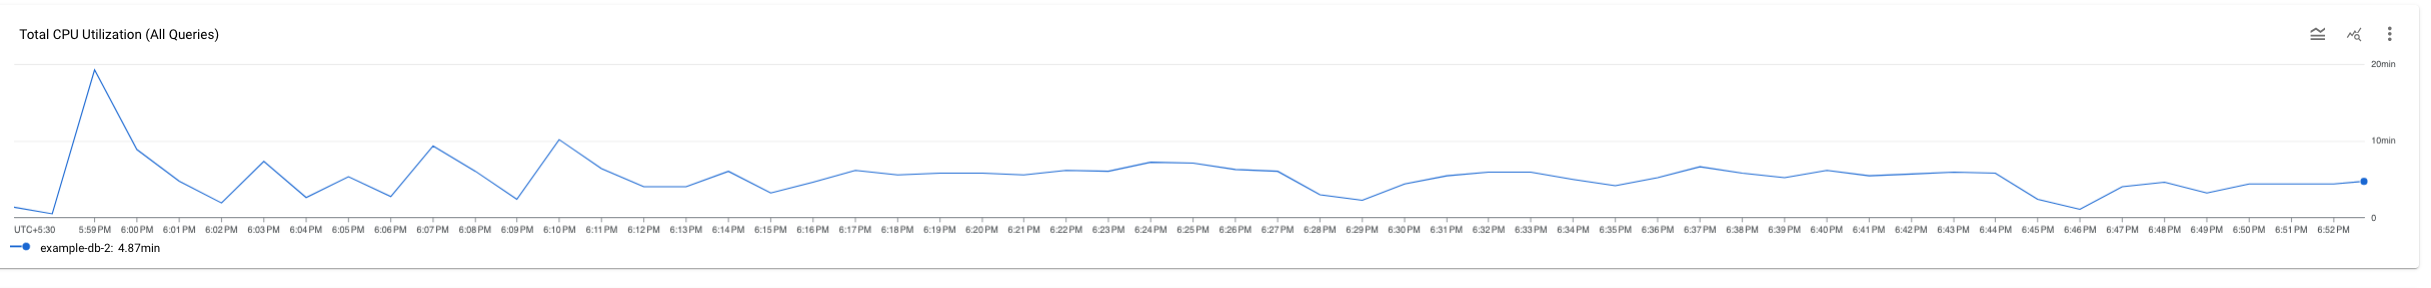
Revisa el gráfico para explorar estas preguntas:
¿Qué base de datos experimenta la carga? Selecciona bases de datos diferentes en la lista Bases de datos para encontrar las bases de datos con las cargas más altas. Para averiguar qué base de datos tiene la carga más alta, también puedes revisar el gráfico Uso de CPU: total de las bases de datos en la consola deGoogle Cloud .

¿El uso de CPU es alto? ¿El grafo aumenta o se incrementa con el tiempo? Si no ves un uso de CPU alto, el problema no está en tus consultas.
¿Cuánto tiempo ha estado alto el uso de CPU? ¿Aumentó recientemente o se ha mantenido alto durante algún tiempo? Usa el selector de intervalo de tiempo para seleccionar varios períodos y averiguar cuánto tiempo ha durado el problema. Acerca la vista para ver un período en el que se observan los aumentos repentinos de la carga de consultas. Aléjate para ver hasta una semana del cronograma.
Si ves un aumento repentino o una elevación en el gráfico correspondiente al uso general de la CPU de la instancia, lo más probable es que se deba a una o más consultas costosas. Luego, puedes profundizar en el proceso de depuración identificando una consulta o etiqueta de solicitud potencialmente problemática.
Identifica una búsqueda o etiqueta de solicitud que podría ser problemática
Para identificar una consulta o una etiqueta de solicitud que podría ser problemática, observa la sección Consultas de TopN:

Aquí vemos que la consulta con la huella digital 3216067328234137024 tiene un uso de CPU alto
y puede ser problemática.
La tabla Consultas de TopN proporciona una descripción general de las consultas que usan la mayor cantidad de CPU durante el período elegido, ordenadas de mayor a menor. La cantidad de consultas TopN se limita a 100.
Para los gráficos, recuperamos los datos de la tabla de estadísticas de consultas de TopN, que tiene tres niveles de detalle diferentes: 1 min, 10 min y 1 hora. El valor de cada dato de los gráficos representa el valor promedio en un intervalo de un minuto.
Te recomendamos que agregues etiquetas a tus consultas en SQL. El etiquetado de consultas te ayuda a encontrar problemas en construcciones de nivel superior, como la lógica empresarial o un microservicio.

En la tabla, se muestran las siguientes propiedades:
- Huella digital: Es el hash de la etiqueta de la solicitud o, si la etiqueta no está presente, un hash del texto de la consulta.
Etiqueta de consulta o solicitud: Si la consulta tiene una etiqueta asociada, se muestra la etiqueta de solicitud. Las estadísticas de varias consultas que tienen la misma cadena de etiqueta se agrupan en una sola fila con el valor
REQUEST_TAGque coincide con la cadena de etiqueta. Para obtener más información sobre el uso de etiquetas de solicitud, consulta Soluciona problemas con etiquetas de solicitud y de transacción.Si la consulta no tiene una etiqueta asociada, se muestra la consulta en SQL, truncada a aproximadamente 64 KB. Para el DML por lotes, las sentencias de SQL se compactan en una sola fila y se concatenan con un punto y coma como delimitador. Los textos de SQL idénticos consecutivos se desduplican antes de truncarse.
Tipo de consulta: Indica si una consulta es
PARTITIONED_QUERYoQUERY. UnPARTITIONED_QUERYes una consulta con unpartitionTokenque se obtiene de la API de PartitionQuery. Todas las demás consultas y sentencias DML se indican con el tipo de consultaQUERY.Uso de CPU: Es el consumo de recursos de CPU por una consulta, como un porcentaje de los recursos de CPU totales que usan todas las consultas que se ejecutan en las bases de datos en ese intervalo de tiempo, que se muestra en una barra horizontal con un rango de 0 a 100.
Recomendación: Spanner analiza tus consultas para determinar si pueden beneficiarse de índices mejorados. Si es así, recomienda índices nuevos o modificados que pueden mejorar el rendimiento de las consultas. Para obtener más información, consulta Usa el asesor de índices de Spanner.
CPU (%): Es el consumo de recursos de CPU por una consulta, como un porcentaje de los recursos de CPU totales que usan todas las consultas que se ejecutan en las bases de datos en ese intervalo de tiempo.
Recuento de ejecuciones: Es la tasa promedio de ejecuciones de consultas, en ejecuciones por minuto, que Spanner vio durante el intervalo.
Latencia promedio (ms): Es el tiempo promedio, en microsegundos, de cada ejecución de consulta en la base de datos. Este promedio excluye el tiempo de codificación y transmisión del conjunto de resultados, así como la sobrecarga.
Promedio de filas analizadas: Es la cantidad promedio de filas que analizó la consulta, sin incluir los valores borrados.
Promedio de filas devueltas: Es la cantidad promedio de filas que devolvió la consulta.
Bytes mostrados: Es la cantidad de bytes de datos que devolvió la consulta, sin incluir la sobrecarga de codificación de transmisión.
Posible variación entre los gráficos
Es posible que notes cierta variación entre el gráfico Uso total de CPU (todas las consultas) y el gráfico Uso total de CPU (por etiqueta de consulta o solicitud). Hay dos factores que podrían generar esta situación:
Diferentes fuentes de datos: Los datos de Cloud Monitoring, que alimentan el gráfico Uso total de CPU (todas las consultas), suelen ser más precisos porque se envían cada minuto y tienen un período de retención de 45 días. Por otro lado, los datos de la tabla del sistema, que alimentan el gráfico Uso de CPU total (por etiqueta de consulta o solicitud), podrían promediarse en 10 minutos (o 1 hora), en cuyo caso podríamos perder los datos de alta nivel de detalle que vemos en el gráfico Uso de CPU total (todas las consultas).
Diferentes ventanas de agregación: Ambos gráficos tienen diferentes ventanas de agregación. Por ejemplo, cuando inspeccionamos un evento de más de 6 horas, consultamos la tabla
SPANNER_SYS.QUERY_STATS_TOTAL_10MINUTE. En este caso, un evento que ocurre a las 10:01 se agregaría durante 10 minutos y estaría presente en la tabla del sistema correspondiente a la marca de tiempo de las 10:10.
En la siguiente captura de pantalla, se muestra un ejemplo de esa variación.

Analiza una etiqueta de consulta o solicitud específica
Para determinar si una consulta o una etiqueta de solicitud es la causa raíz del problema, haz clic en la consulta o la etiqueta de solicitud que parece tener la carga más alta o que tarda más que las demás. Puedes seleccionar varias consultas y etiquetas de solicitud a la vez.
Puedes mantener el puntero del mouse en el gráfico para las consultas en el cronograma para conocer su uso de CPU (en segundos).
Revisa la siguiente información para tratar de reducir el problema:
- ¿Cuánto tiempo ha estado alta la carga? ¿Es solo alta ahora? ¿Ha estado alta por mucho tiempo? Cambia los intervalos de tiempo para encontrar la fecha y la hora en que la consulta comenzó a tener un rendimiento deficiente.
- ¿Hubo aumentos repentinos en el uso de CPU? Puedes cambiar el período para estudiar el uso histórico de CPU de la consulta.
- ¿Cuál es el consumo de recursos? ¿Qué relación tiene con otras consultas? Observa la tabla y compara los datos de otras consultas con la seleccionada. ¿Hay una diferencia importante?
Para confirmar que la consulta seleccionada contribuye al uso elevado de CPU, puedes desglosar los detalles de la forma de consulta específica (o etiqueta de solicitud) y analizarla más a fondo en la página de detalles de la consulta.
Visualiza la página de detalles de la consulta
Para ver los detalles de una forma de consulta o una etiqueta de solicitud específicas en un formato gráfico, haz clic en la huella digital asociada con la consulta o la etiqueta de solicitud. Se abrirá la página de detalles de la consulta.

En la página de detalles de la consulta, se muestra la siguiente información:
- Texto de los detalles de la consulta: Es el texto de la consulta en SQL, truncado a aproximadamente 64 KB. Las estadísticas de varias consultas que tienen la misma cadena de etiqueta se agrupan en una sola fila con la REQUEST_TAG que coincide con esa cadena de etiqueta. En este campo, solo se muestra el texto de una de esas consultas. Para el DML por lotes, el conjunto de sentencias de SQL se reduce a una sola fila, concatenada con un delimitador de punto y coma. Los textos de SQL idénticos consecutivos se desduplican antes de truncarse.
- Los valores de los siguientes campos:
- Recuento de ejecuciones: Es la tasa promedio de ejecuciones de consultas, en ejecuciones por minuto, que Spanner vio durante el intervalo.
- CPU promedio (ms): Es el consumo promedio de recursos de CPU, en milisegundos, por una consulta de los recursos de CPU de la instancia en un intervalo de tiempo.
- Latencia promedio (ms): Es el tiempo promedio, en milisegundos, de cada ejecución de consulta dentro de la base de datos. Este promedio excluye el tiempo de codificación y transmisión para el conjunto de resultados y la sobrecarga.
- Promedio de filas devueltas: Es la cantidad promedio de filas que devolvió la consulta.
- Promedio de filas analizadas: Es la cantidad promedio de filas que analizó la consulta, sin incluir los valores borrados.
- Bytes promedio: Es la cantidad de bytes de datos que devolvió la consulta, sin incluir la sobrecarga de codificación de transmisión.
- Gráfico de muestras de planes de consultas: Cada punto del gráfico representa un plan de consulta de muestra en un momento específico y su latencia de consulta específica. Haz clic en uno de los puntos del gráfico para ver el plan de consulta y conocer los pasos que se realizaron durante la ejecución de la consulta. Nota: Los planes de consulta no son compatibles con las consultas que tienen partitionTokens obtenidos de la API de PartitionQuery ni con las consultas de DML particionado.
Visualizador del plan de consultas: Muestra el plan de consultas de muestra seleccionado. Spanner proporciona las siguientes opciones de diseño:
- Vista de árbol: La vista de árbol visualiza el plan de consulta como un gráfico en el que cada nodo o tarjeta representa un iterador que consume filas de sus entradas y produce filas para su elemento superior. Puedes hacer clic en cada iterador para obtener información ampliada.
Vista secuencial: La vista secuencial muestra el plan de consulta en una tabla jerárquica en la que cada fila representa un operador. Puedes hacer clic en cada fila para obtener información ampliada.
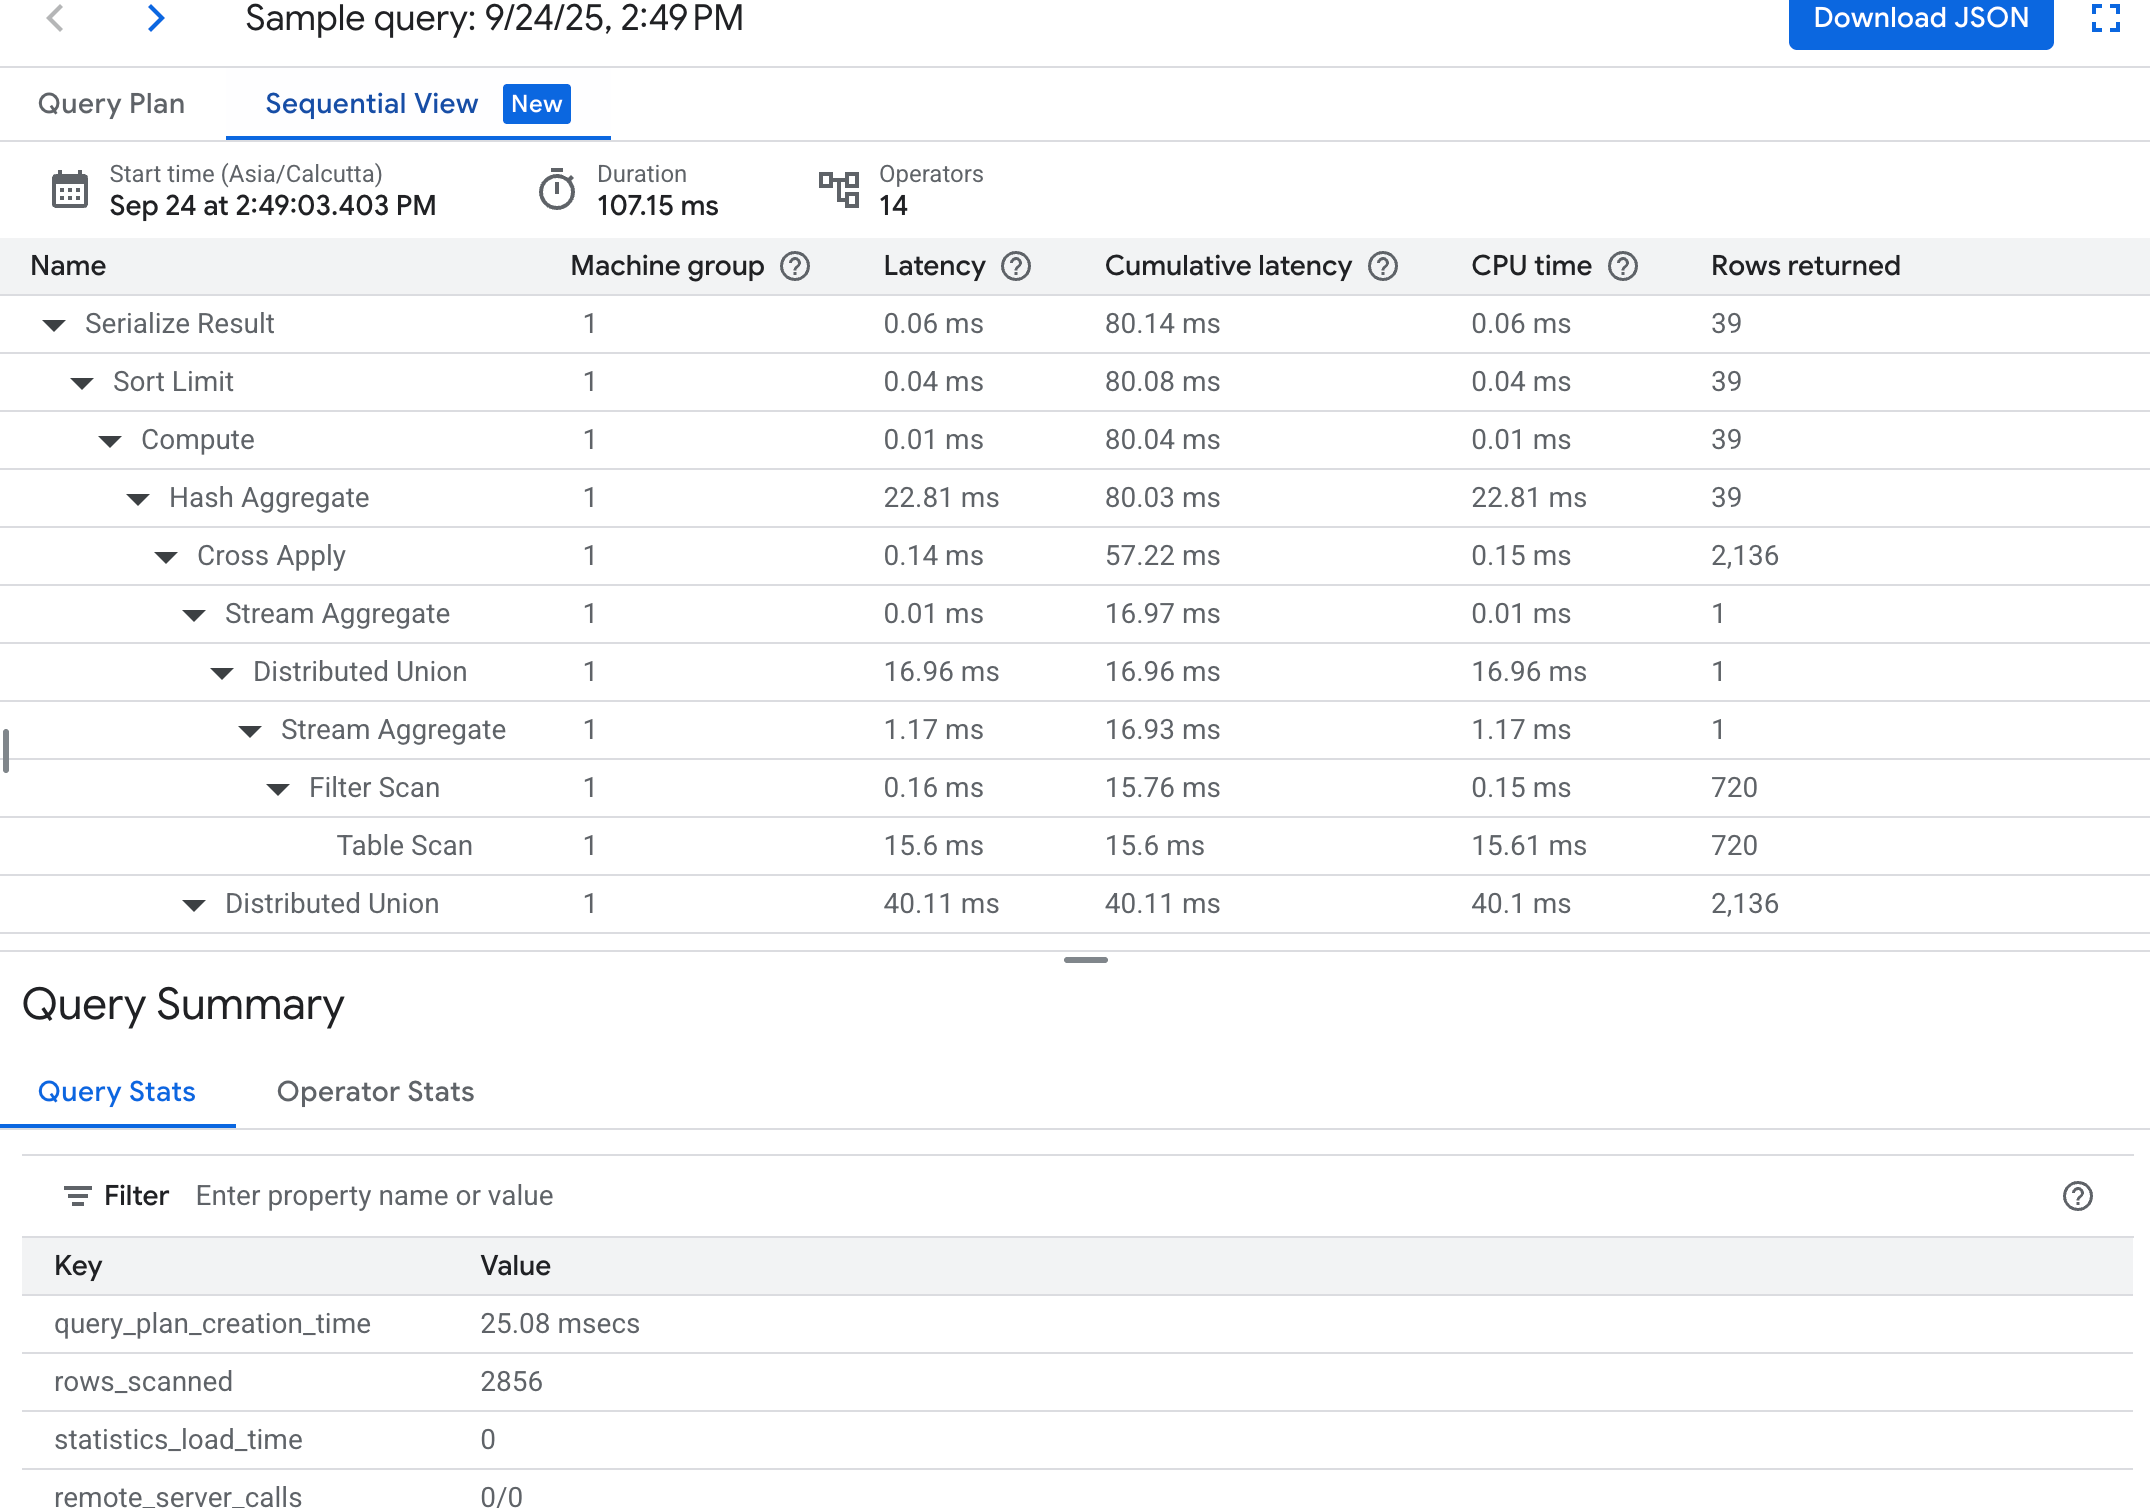
En la tabla, se muestran las siguientes columnas:
- Nombre: Es el nombre del operador.
- Grupo de máquinas: Es el grupo de máquinas en el que se ejecutó este operador.
- Latencia: Es la cantidad de tiempo transcurrido durante la ejecución de la operación actual. Este podría ser mayor que el tiempo de CPU (por ejemplo, si el operador esperó llamadas remotas o si hubo una demora en el sistema de archivos).
- Latencia acumulativa: Es la cantidad de tiempo transcurrido durante la ejecución de todo el subárbol asociado a este operador. Esto no incluye el tiempo de creación del plan ni otras sobrecargas, por lo que la latencia acumulativa puede ser menor que la duración total de la consulta.
- Tiempo de CPU: Es la cantidad total de tiempo de CPU dedicado a ejecutar la consulta. Se excluye la latencia de red. Algunas partes de la ejecución de la consulta pueden continuar en paralelo, por lo que es posible que el tiempo de CPU sea mayor que el tiempo total transcurrido. Por ejemplo, si una consulta ejecuta diez operaciones paralelas en 1 milisegundo (ms), el tiempo transcurrido es de 1 ms, pero el tiempo de CPU es de 10 ms.
- Filas devueltas: Es la cantidad de filas que devuelve el operador.
Gráfico Latencia de las consultas: Muestra el valor de la latencia de una consulta seleccionada durante un período. También muestra la latencia promedio.
Gráfico de uso de CPU: Muestra el uso de CPU de una consulta, en porcentaje, durante un período. También muestra el uso promedio de la CPU.
Gráfico de recuento de ejecuciones/ejecuciones con errores: Muestra la tasa promedio de ejecuciones de consultas (en ejecuciones por minuto) durante un período y la tasa promedio de ejecuciones de consultas con errores (en ejecuciones con errores por minuto).
Gráfico de filas analizadas: Muestra la cantidad de filas que analizó la consulta durante un período.
Gráfico de filas mostradas: Muestra la cantidad de filas que la consulta mostró durante un período.
Filtro de período: Filtra los detalles de la consulta por períodos, como hora, día o un período personalizado.
Para los gráficos, recuperamos los datos de la tabla de estadísticas de consultas de TopN, que tiene tres niveles de detalle diferentes: 1 min, 10 min y 1 hora. El valor de cada dato de los gráficos representa el valor promedio en un intervalo de un minuto.
Busca todas las ejecuciones de una consulta en el registro de auditoría
Para buscar todas las ejecuciones de una huella digital de consulta en particular en
los Registros de auditoría de Cloud,
consulta el registro de auditoría y busca cualquier
query_fingerprint que coincida con el campo Fingerprint en la tabla de estadísticas de consultas
TopN. Para obtener más información, consulta la Descripción general de consultas y visualización de registros. Usa este método para identificar al usuario que inició la consulta.