


Il pilastro dell'affidabilità del Google Cloud Well-Architected Framework fornisce principi e consigli per aiutarti a progettare, eseguire il deployment e gestire workload affidabili in Google Cloud.
Questo documento è rivolto ad architetti, sviluppatori, ingegneri di piattaforma, amministratori e Site Reliability Engineer cloud.
L'affidabilità è la capacità di un sistema di svolgere in modo coerente le funzioni previste all'interno delle condizioni definite e di mantenere un servizio ininterrotto. Le best practice per l'affidabilità includono ridondanza, progettazione a tolleranza di errore, monitoraggio e processi di ripristino automatico.
Nell'ambito dell'affidabilità, la resilienza è la capacità del sistema di resistere e riprendersi da errori o interruzioni impreviste, mantenendo al contempo le prestazioni. Le funzionalità diGoogle Cloud , come i deployment multiregionali, i backup automatici e le soluzioni di ripristino di emergenza, possono aiutarti a migliorare la resilienza del tuo sistema.
L'affidabilità è importante per la tua strategia cloud per molti motivi, tra cui:
- Tempo di inattività minimo: i tempi di inattività possono comportare una perdita di entrate, una riduzione della produttività e danni alla reputazione. Le architetture resilienti possono contribuire a garantire che i sistemi possano continuare a funzionare durante gli errori o a riprendersi in modo efficiente dagli errori.
- Esperienza utente migliorata: gli utenti si aspettano interazioni fluide con la tecnologia. I sistemi resilienti possono aiutare a mantenere prestazioni e disponibilità costanti e forniscono un servizio affidabile anche in caso di domanda elevata o problemi imprevisti.
- Integrità dei dati: gli errori possono causare la perdita o il danneggiamento dei dati. I sistemi resilienti implementano meccanismi come backup, ridondanza e replica per proteggere i dati e garantire che rimangano accurati e accessibili.
- Continuità operativa: la tua attività si affida alla tecnologia per le operazioni critiche. Le architetture resilienti possono contribuire a garantire la continuità dopo un errore catastrofico, consentendo alle funzioni aziendali di continuare senza interruzioni significative e supportando un rapido ripristino.
- Conformità: molti settori hanno requisiti normativi per la disponibilità del sistema e la protezione dei dati. Le architetture resilienti possono aiutarti a soddisfare questi standard garantendo che i sistemi rimangano operativi e sicuri.
- Riduzione dei costi a lungo termine: le architetture resilienti richiedono un investimento iniziale, ma la resilienza può contribuire a ridurre i costi nel tempo prevenendo costosi tempi di inattività, evitando correzioni reattive e consentendo un utilizzo più efficiente delle risorse.
Mentalità organizzativa
Per rendere i tuoi sistemi affidabili, hai bisogno di un piano e di una strategia consolidata. Questa strategia deve includere la formazione e l'autorità per dare priorità all'affidabilità insieme ad altre iniziative.
Definisci chiaramente che l'intera organizzazione è responsabile dell'affidabilità, inclusi lo sviluppo, il product management, le operazioni, la progettazione della piattaforma e il Site Reliability Engineering (SRE). Anche i gruppi incentrati sul business, come il marketing e le vendite, possono influenzare l'affidabilità.
Ogni team deve comprendere i target di affidabilità e i rischi delle proprie applicazioni. I team devono essere responsabili di questi requisiti. I conflitti tra l'affidabilità e lo sviluppo regolare delle funzionalità del prodotto devono essere classificati in ordine di priorità e riassegnati di conseguenza.
Pianifica e gestisci l'affidabilità in modo olistico, in tutte le funzioni e i team. Valuta la possibilità di creare un Cloud Center of Excellence (CCoE) che includa un pilastro di affidabilità. Per saperne di più, consulta Ottimizza il percorso verso il cloud della tua organizzazione con un Cloud Center of Excellence.
Aree di interesse per l'affidabilità
Le attività che svolgi per progettare, eseguire il deployment e gestire un sistema affidabile possono essere classificate nelle seguenti aree di interesse. Ciascuno dei principi e dei suggerimenti di affidabilità di questo pilastro è pertinente a una di queste aree di interesse.
- Definizione dell'ambito: per comprendere il tuo sistema, esegui un'analisi dettagliata della sua architettura. Devi comprendere i componenti, il loro funzionamento e la loro interazione, il flusso di dati e azioni attraverso il sistema e cosa potrebbe andare storto. Identificare potenziali errori, colli di bottiglia e rischi, il che ti aiuta a passare all'azione per mitigare questi problemi.
- Osservazione: per contribuire a prevenire gli errori di sistema, implementa un'osservazione e un monitoraggio completi e continui. Attraverso questa osservazione, puoi comprendere le tendenze e identificare i potenziali problemi in modo proattivo.
- Risposta: per ridurre l'impatto degli errori, rispondi in modo appropriato ed esegui il recupero in modo efficiente. Le risposte automatiche possono anche contribuire a ridurre l'impatto degli errori. Nonostante la pianificazione e i controlli, possono comunque verificarsi errori.
- Apprendimento: per evitare che gli errori si ripetano, impara da ogni esperienza e intraprendi le azioni appropriate.
Valuta i workload utilizzando una skill dell'agente
Per consentire agli agenti AI di valutare i tuoi workload cloud in base ai principi e ai suggerimenti di questo pilastro, utilizza la skill google-cloud-waf-reliability, disponibile nel repository Google Agent Skills su GitHub.
Per installare la skill, esegui questo comando nel client o nel terminale dell'agente:
npx skills add google/skills --skill google-cloud-waf-reliability
Quando richiesto, specifica gli agenti AI per cui vuoi installare la skill e imposta l'ambito di installazione (progetto o globale).
Se hai già installato la skill, puoi aggiornarla all'ultima versione eseguendo questo comando:
npx skills update
Principi fondamentali
I suggerimenti del pilastro dell'affidabilità del Well-Architected Framework sono mappati ai seguenti principi fondamentali:
- Definisci l'affidabilità in base agli obiettivi dell'esperienza utente
- Imposta target realistici per l'affidabilità
- Crea sistemi ad alta affidabilità tramite la ridondanza delle risorse
- Sfrutta la scalabilità orizzontale
- Rileva potenziali errori utilizzando l'osservabilità
- Progetta per una riduzione controllata
- Esegui test per il ripristino dagli errori
- Esegui test per il recupero dalla perdita di dati
- Esegui postmortem approfonditi
Collaboratori
Autori:
- Laura Hyatt | Customer Engineer, FSI
- Jose Andrade | Customer Engineer, SRE Specialist
- Gino Pelliccia | Principal Architect
Altri collaboratori:
- Andrés-Leonardo Martínez-Ortiz | Technical Program Manager
- Brian Kudzia | Enterprise Infrastructure Customer Engineer
- Daniel Lees | Cloud Security Architect
- Filipe Gracio, PhD | Customer Engineer, AI/ML Specialist
- Gary Harmson | Principal Architect
- Kumar Dhanagopal | Cross-Product Solution Developer
- Marwan Al Shawi | Partner Customer Engineer
- Nicolas Pintaux | Customer Engineer, Application Modernization Specialist
- Radhika Kanakam | Program Lead, Google Cloud Well-Architected Framework
- Ryan Cox | Principal Architect
- Samantha He | Technical Writer
- Wade Holmes | Global Solutions Director
- Zach Seils | Networking Specialist
Definiscono l'affidabilità in base agli obiettivi dell'esperienza utente
Questo principio del pilastro dell'affidabilità del Well-Architected FrameworkGoogle Cloud ti aiuta a valutare l'esperienza degli utenti e a mappare i risultati in base agli obiettivi e alle metriche di affidabilità.
Questo principio è pertinente all'area di interesse definizione dell'ambito dell'affidabilità.
Panoramica del principio
Gli strumenti di osservabilità forniscono grandi quantità di dati, ma non tutti i dati sono direttamente correlati agli impatti sugli utenti. Ad esempio, potresti osservare un utilizzo elevato della CPU, operazioni del server lente o persino l'arresto anomalo delle attività. Tuttavia, se questi problemi non influiscono sull'esperienza utente, non costituiscono un'interruzione.
Per misurare l'esperienza utente, devi distinguere tra il comportamento del sistema interno e i problemi rivolti agli utenti. Concentrati su metriche come la percentuale di successo delle richieste degli utenti. Non fare affidamento solo su metriche incentrate sul server, come l'utilizzo della CPU, che possono portare a conclusioni fuorvianti sull'affidabilità del servizio. La vera affidabilità significa che gli utenti possono utilizzare la tua applicazione o il tuo servizio in modo coerente ed efficace.
Consigli
Per misurare l'esperienza utente in modo efficace, prendi in considerazione i consigli riportati nelle sezioni seguenti.
Misura l'esperienza utente
Per comprendere appieno l'affidabilità del tuo servizio, dai la priorità alle metriche che riflettono l'esperienza effettiva degli utenti. Ad esempio, misura la percentuale di successo delle query degli utenti, la latenza delle applicazioni e i tassi di errore.
Idealmente, raccogli questi dati direttamente dal dispositivo o dal browser dell'utente. Se questa raccolta diretta dei dati non è fattibile, sposta il punto di misurazione progressivamente più lontano dall'utente nel sistema. Ad esempio, puoi utilizzare il bilanciatore del carico o il servizio di frontend come punto di misurazione. Questo approccio ti aiuta a identificare e risolvere i problemi prima che possano avere un impatto significativo sui tuoi utenti.
Analizza i percorsi degli utenti
Per capire in che modo gli utenti interagiscono con il tuo sistema, puoi utilizzare strumenti di tracciamento come Cloud Trace. Seguendo il percorso di un utente attraverso la tua applicazione, puoi trovare colli di bottiglia e problemi di latenza che potrebbero compromettere l'esperienza utente. Cloud Trace acquisisce dati sul rendimento dettagliati per ogni hop nell'architettura del servizio. Questi dati ti aiutano a identificare e risolvere i problemi di prestazioni in modo più efficiente, il che può portare a un'esperienza utente più affidabile e soddisfacente.
Imposta target realistici per l'affidabilità
Questo principio del pilastro dell'affidabilità del Google Cloud Well-Architected Framework ti aiuta a definire obiettivi di affidabilità tecnicamente fattibili per i tuoi workload in Google Cloud.
Questo principio è pertinente all'area di interesse definizione dell'ambito dell'affidabilità.
Panoramica del principio
Progetta i tuoi sistemi in modo che siano affidabili al punto che gli utenti siano soddisfatti. Potrebbe sembrare controintuitivo, ma un obiettivo di affidabilità del 100% spesso non è la strategia più efficace. Una maggiore affidabilità potrebbe comportare un costo significativamente più elevato, sia in termini di investimento finanziario sia di potenziali limitazioni all'innovazione. Se gli utenti sono già soddisfatti del livello di servizio attuale, gli sforzi per aumentare ulteriormente la soddisfazione potrebbero produrre un ritorno sull'investimento basso. Invece, puoi utilizzare meglio le risorse altrove.
Devi determinare il livello di affidabilità che soddisfa i tuoi utenti e il punto in cui il costo dei miglioramenti incrementali inizia a superare i vantaggi. Quando determini questo livello di affidabilità sufficiente, puoi allocare le risorse in modo strategico e concentrarti su funzionalità e miglioramenti che offrono un valore maggiore ai tuoi utenti.
Consigli
Per impostare obiettivi di affidabilità realistici, prendi in considerazione i suggerimenti nelle seguenti sottosezioni.
Accetta alcuni errori e assegna la priorità ai componenti
Punta a un'alta affidabilità, ad esempio un uptime del 99,99%, ma non impostare un target di uptime del 100%. Riconosci che alcuni errori sono inevitabili.
Il divario tra l'uptime del 100% e un target del 99,99% è il margine di errore. Questo divario viene spesso chiamato budget di errore. Il budget di errore può aiutarti ad assumerti rischi e a innovare, il che è fondamentale per qualsiasi attività per rimanere competitiva.
Dai la priorità all'affidabilità dei componenti più critici del sistema. Accetta che i componenti meno critici possano avere una tolleranza maggiore agli errori.
Bilancia affidabilità e costi
Per determinare il livello di affidabilità ottimale per il tuo sistema, esegui analisi costi-benefici approfondite.
Considera fattori come i requisiti di sistema, le conseguenze degli errori e la tolleranza al rischio della tua organizzazione per l'applicazione specifica. Ricorda di considerare le metriche di disaster recovery, come il Recovery Time Objective (RTO) e il Recovery Point Objective (RPO). Decidi quale livello di affidabilità è accettabile nell'ambito del budget e di altri vincoli.
Cerca modi per migliorare l'efficienza e ridurre i costi senza compromettere le funzionalità di affidabilità essenziali.
Crea sistemi ad alta affidabilità tramite la ridondanza delle risorse
Questo principio del pilastro dell'affidabilità del Google Cloud Well-Architected Framework fornisce consigli per pianificare, creare e gestire la ridondanza delle risorse, che può aiutarti a evitare errori.
Questo principio è pertinente all'area di interesse definizione dell'ambito dell'affidabilità.
Panoramica del principio
Dopo aver deciso il livello di affidabilità di cui hai bisogno, devi progettare i tuoi sistemi in modo da evitare qualsiasi single point of failure. Ogni componente critico del sistema deve essere replicato su più macchine, zone e regioni. Ad esempio, un database critico non può trovarsi in una sola regione e un server di metadati non può essere distribuito in una sola zona o regione. In questi esempi, se l'unica zona o regione subisce un'interruzione, il sistema subisce un'interruzione globale.
Consigli
Per creare sistemi ridondanti, tieni conto dei suggerimenti riportati nelle seguenti sottosezioni.
Identifica i domini in errore e replica i servizi
Mappa i domini in errore del tuo sistema, dalle singole VM alle regioni, e progetta la ridondanza tra i domini in errore.
Per garantire l'alta affidabilità, distribuisci e replica i tuoi servizi e le tue applicazioni in più zone e regioni. Configura il sistema per il failover automatico per assicurarti che i servizi e le applicazioni continuino a essere disponibili in caso di interruzioni a livello di zona o regione.
Per esempi di architetture multizona e multiregionali, consulta Progetta un'infrastruttura affidabile per i tuoi workload in Google Cloud.
Rileva e risolvi i problemi tempestivamente
Monitora continuamente lo stato dei domini in errore per rilevare e risolvere i problemi tempestivamente.
Puoi monitorare lo stato attuale dei servizi Google Cloud in tutte le regioni utilizzando la dashboard diGoogle Cloud Service Health. Puoi anche visualizzare gli incidenti relativi al tuo progetto utilizzando Personalized Service Health. Puoi utilizzare i bilanciatori del carico per rilevare l'integrità delle risorse e instradare automaticamente il traffico ai backend integri. Per saperne di più, consulta la panoramica dei controlli di integrità.
Testa gli scenari di failover
Come per un'esercitazione antincendio, simula regolarmente gli errori per convalidare l'efficacia delle tue strategie di replica e failover.
Per ulteriori informazioni, consulta Simula un'interruzione del servizio in una zona per un MIG a livello di regione e Simula un errore della zona nei cluster GKE a livello di regione.
Sfrutta la scalabilità orizzontale
Questo principio del pilastro dell'affidabilità del Google Cloud Well-Architected Framework fornisce consigli per aiutarti a utilizzare la scalabilità orizzontale. Utilizzando la scalabilità orizzontale, puoi contribuire a garantire che i tuoi workload inGoogle Cloud possano scalare in modo efficiente e mantenere le prestazioni.
Questo principio è pertinente all'area di interesse definizione dell'ambito dell'affidabilità.
Panoramica del principio
Riprogetta il sistema in un'architettura orizzontale. Per far fronte alla crescita del traffico o dei dati, puoi aggiungere altre risorse. Puoi anche rimuovere le risorse quando non sono in uso.
Per comprendere il valore della scalabilità orizzontale, considera le limitazioni della scalabilità verticale.
Uno scenario comune per lo scale up è l'utilizzo di un database MySQL come database primario con dati critici. Man mano che l'utilizzo del database aumenta, sono necessarie più RAM e CPU. Alla fine, il database raggiunge il limite di memoria sulla macchina host e deve essere eseguito l'upgrade. Questo processo potrebbe dover essere ripetuto più volte. Il problema è che esistono limiti rigidi alla crescita di un database. Le dimensioni delle VM non sono illimitate. Il database può raggiungere un punto in cui non è più possibile aggiungere altre risorse.
Anche se le risorse fossero illimitate, una VM di grandi dimensioni può diventare un single point of failure. Qualsiasi problema con la VM del database principale può causare risposte di errore o un'interruzione a livello di sistema che interessa tutti gli utenti. Evita i single point of failure, come descritto in Crea sistemi ad alta affidabilità tramite la ridondanza delle risorse.
Oltre a questi limiti di scalabilità, la scalabilità verticale tende a essere più costosa. Il costo può aumentare in modo esponenziale con l'acquisto di macchine con maggiore potenza di calcolo e memoria.
La scalabilità orizzontale, invece, può costare meno. Il potenziale di scalabilità orizzontale è praticamente illimitato in un sistema progettato per la scalabilità.
Consigli
Per passare da un'architettura con una singola VM a un'architettura con più macchine orizzontali, devi pianificare attentamente e utilizzare gli strumenti giusti. Per aiutarti a ottenere la scalabilità orizzontale, tieni presente i suggerimenti riportati nelle sottosezioni seguenti.
Utilizza i servizi gestiti
I servizi gestiti eliminano la necessità di gestire manualmente la scalabilità orizzontale. Ad esempio, con i gruppi di istanze gestite di Compute Engine, puoi aggiungere o rimuovere VM per scalare la tua applicazione in orizzontale. Per le applicazioni containerizzate, Cloud Run è una piattaforma serverless che può scalare automaticamente i container stateless in base al traffico in entrata.
Promuovere la progettazione modulare
I componenti modulari e le interfacce chiare ti aiutano a scalare i singoli componenti in base alle esigenze, anziché l'intera applicazione. Per saperne di più, consulta Promuovi la progettazione modulare nel pilastro Ottimizzazione delle prestazioni.
Implementa un design stateless
Progetta applicazioni stateless, ovvero senza dati archiviati localmente. In questo modo puoi aggiungere o rimuovere istanze senza preoccuparti della coerenza dei dati.
Rileva potenziali errori utilizzando l'osservabilità
Questo principio del pilastro dell'affidabilità del Google Cloud Well-Architected Framework fornisce consigli per aiutarti a identificare in modo proattivo le aree in cui potrebbero verificarsi errori e anomalie.
Questo principio è pertinente all'area di interesse osservazione dell'affidabilità.
Panoramica del principio
Per mantenere e migliorare l'affidabilità dei workload inGoogle Cloud, devi implementare un'osservabilità efficace utilizzando metriche, log e tracce.
- Le metriche sono misurazioni numeriche delle attività che vuoi monitorare per la tua applicazione a intervalli di tempo specifici. Ad esempio, potresti voler monitorare metriche tecniche come il tasso di richieste e la percentuale di errori, che possono essere utilizzate come indicatori del livello di servizio (SLI). Potresti anche dover monitorare metriche aziendali specifiche dell'applicazione, come gli ordini effettuati e i pagamenti ricevuti.
- I log sono record con timestamp di eventi discreti che si verificano all'interno di un'applicazione o di un sistema. L'evento potrebbe essere un errore, un'anomalia o una modifica dello stato. I log potrebbero includere metriche e puoi utilizzarli anche per gli SLI.
- Una traccia rappresenta il percorso di un singolo utente o di una singola transazione attraverso una serie di applicazioni separate o i componenti di un'applicazione. Ad esempio, questi componenti potrebbero essere microservizi. Le tracce ti aiutano a monitorare quali componenti sono stati utilizzati nei percorsi, dove si trovano i colli di bottiglia e quanto tempo hanno richiesto i percorsi.
Metriche, log e tracce ti aiutano a monitorare il sistema in modo continuo. Il monitoraggio completo ti aiuta a scoprire dove e perché si sono verificati gli errori. Puoi anche rilevare potenziali errori prima che si verifichino.
Consigli
Per rilevare potenziali errori in modo efficiente, prendi in considerazione i suggerimenti nelle seguenti sottosezioni.
Ottieni insight completi
Per monitorare metriche chiave come i tempi di risposta e le percentuali di errore, utilizza Cloud Monitoring e Cloud Logging. Questi strumenti ti aiutano anche a garantire che le metriche soddisfino costantemente le esigenze del tuo workload.
Per prendere decisioni basate sui dati, analizza le metriche dei servizi predefiniti per comprendere le dipendenze dei componenti e il loro impatto sulle prestazioni complessive del workload.
Per personalizzare la tua strategia di monitoraggio, crea e pubblica le tue metriche utilizzando Google Cloud SDK.
Esegui la risoluzione dei problemi proattiva
Implementa una gestione degli errori efficace e attiva il logging in tutti i componenti dei tuoi workload in Google Cloud. Attiva log come i log di accesso di Cloud Storage e i log di flusso VPC.
Quando configuri il logging, tieni conto dei costi associati. Per controllare i costi di logging, puoi configurare filtri di esclusione sui sink di log per escludere determinati log dall'archiviazione.
Ottimizza l'utilizzo delle risorse
Monitora il consumo della CPU, le metriche di I/O di rete e le metriche di I/O del disco per rilevare risorse con provisioning insufficiente ed eccessivo in servizi come GKE, Compute Engine e Managed Service for Apache Spark. Per un elenco completo dei servizi supportati, consulta la panoramica di Cloud Monitoring.
Assegnazione di priorità agli avvisi
Per gli avvisi, concentrati sulle metriche principali, imposta soglie appropriate per ridurre al minimo l'eccesso di avvisi e assicurati rispondere in modo tempestivo ai problemi significativi. Questo approccio mirato ti consente di mantenere in modo proattivo l'affidabilità del workload. Per ulteriori informazioni, consulta la Panoramica degli avvisi.
Progetta per la riduzione controllata
Questo principio del pilastro dell'affidabilità del Google Cloud Well-Architected Framework fornisce consigli per aiutarti a progettare i tuoi workload Google Cloud in modo che falliscano in modo controllato.
Questo principio è pertinente all'area di interesse Risposta dell'affidabilità.
Panoramica del principio
La riduzione controllata è un approccio di progettazione in cui un sistema sottoposto a un carico elevato continua a funzionare, eventualmente con prestazioni o accuratezza ridotte. La riduzione controllata garantisce la disponibilità continua del sistema e previene un errore completo, anche se il lavoro del sistema non è ottimale. Quando il carico torna a un livello gestibile, il sistema riprende la piena funzionalità.
Ad esempio, durante i periodi di carico elevato, la Ricerca Google dà la priorità ai risultati delle pagine web con un ranking più elevato, sacrificando potenzialmente un po' di accuratezza. Quando il carico diminuisce, la Ricerca Google ricalcola i risultati di ricerca.
Consigli
Per progettare i tuoi sistemi per la riduzione controllata, tieni conto dei suggerimenti riportati nelle sezioni seguenti.
Implementa la limitazione
Assicurati che le repliche possano gestire in modo indipendente i sovraccarichi e limitare le richieste in entrata in scenari di traffico elevato. Questo approccio ti aiuta a prevenire errori a cascata causati da variazioni del traffico in eccesso tra le zone.
Utilizza strumenti come Apigee per controllare la frequenza delle richieste API durante i periodi di traffico elevato. Puoi configurare le regole della policy in modo che riflettano il modo in cui vuoi ridurre le richieste.
Elimina tempestivamente le richieste in eccesso
Configura i tuoi sistemi in modo che eliminino le richieste in eccesso a livello di frontend per proteggere i componenti di backend. L'eliminazione di alcune richieste evita errori globali e consente al sistema di ripristinarsi in modo più agevole.Con questo approccio, alcuni utenti potrebbero riscontrare errori. Tuttavia, puoi ridurre al minimo l'impatto delle interruzioni, a differenza di un approccio come l'interruzione del circuito, in cui tutto il traffico viene interrotto durante un sovraccarico.
Gestisci gli errori parziali e i nuovi tentativi
Crea le tue applicazioni in modo che gestiscano senza problemi gli errori parziali e i nuovi tentativi. Questo design contribuisce a garantire che venga gestito il maggior volume di traffico possibile in scenari di carico elevato.
Testa scenari di sovraccarico
Per verificare che i meccanismi di limitazione e di eliminazione delle richieste funzionino in modo efficace, simula regolarmente condizioni di sovraccarico nel sistema. I test aiutano a garantire che il tuo sistema sia preparato per i picchi di traffico reali.
Monitora i picchi di traffico
Utilizza strumenti di analisi e monitoraggio per prevedere e rispondere ai picchi di traffico prima che si trasformino in sovraccarichi. Il rilevamento e la risposta tempestivi possono aiutare a mantenere la disponibilità del servizio durante i periodi di domanda elevata.
Esegui test per il ripristino dagli errori
Questo principio del pilastro dell'affidabilità del Google Cloud Well-Architected Framework fornisce consigli per aiutarti a progettare ed eseguire test per il recupero in caso di errori.
Questo principio è pertinente all'area di interesse Apprendimento dell'affidabilità.
Panoramica del principio
Per assicurarti che il tuo sistema possa riprendersi da errori, devi eseguire periodicamente test che includano failover regionali, rollback delle release e ripristino dei dati dai backup.
Questo test ti aiuta a esercitarti con le risposte a eventi che comportano rischi significativi per l'affidabilità, come l'interruzione di un'intera regione. Questo test ti aiuta anche a verificare che il sistema si comporti come previsto durante un'interruzione.
Nell'improbabile caso in cui un'intera regione non sia disponibile, devi eseguire il failover di tutto il traffico verso un'altra regione. Durante il normale funzionamento del workload, quando i dati vengono modificati, devono essere sincronizzati dalla regione principale alla regione di failover. Devi verificare che i dati replicati siano sempre molto recenti, in modo che gli utenti non subiscano perdite di dati o interruzioni della sessione. Il sistema di bilanciamento del carico deve inoltre essere in grado di spostare il traffico verso la regione di failover in qualsiasi momento senza interruzioni del servizio. Per ridurre al minimo i tempi di inattività dopo un'interruzione a livello di regione, gli ingegneri operativi devono anche essere in grado di spostare manualmente e in modo efficiente il traffico degli utenti da una regione, nel minor tempo possibile. Questa operazione è talvolta chiamata svuotamento di una regione, il che significa che interrompi il traffico in entrata verso la regione e lo sposti altrove.
Consigli
Quando progetti ed esegui test per il ripristino in caso di errore, tieni conto dei consigli riportati nelle sottosezioni seguenti.
Definisci gli obiettivi e l'ambito dei test
Definisci chiaramente cosa vuoi ottenere dai test. Ad esempio, i tuoi obiettivi possono includere:
- Convalida il Recovery Time Objective (RTO) e il Recovery Point Objective (RPO). Per maggiori dettagli, consulta Nozioni di base sulla RE DR.
- Valutare la resilienza e la tolleranza di errore del sistema in vari scenari di errore.
- Testa l'efficacia dei meccanismi di failover automatico.
Decidi quali componenti, servizi o regioni rientrano nell'ambito del test. L'ambito può includere livelli di applicazione specifici come frontend, backend e database oppure risorse Google Cloud specifiche come istanze Cloud SQL o cluster GKE. L'ambito deve inoltre specificare eventuali dipendenze esterne, come API di terze parti o Cloud Interconnect.
Prepara l'ambiente per i test
Scegli un ambiente appropriato, preferibilmente un ambiente di gestione temporanea o sandbox che replichi la configurazione di produzione. Se esegui il test in produzione, assicurati di avere pronte misure di sicurezza, come il monitoraggio automatico e le procedure di rollback manuale.
Crea un piano di backup. Acquisisci snapshot o backup di database e servizi critici per evitare la perdita di dati durante il test. Assicurati che il tuo team sia pronto a intervenire manualmente se i meccanismi di failover automatico non funzionano.
Per evitare interruzioni dei test, assicurati che i ruoli IAM, le policy e le configurazioni di failover siano configurati correttamente. Verifica che siano presenti le autorizzazioni necessarie per gli strumenti e gli script di test.
Informa gli stakeholder, tra cui i team operativi, DevOps e i proprietari delle applicazioni, in merito alla pianificazione, all'ambito e al potenziale impatto del test. Fornisci agli stakeholder una tempistica stimata e i comportamenti previsti durante il test.
Simula scenari di errore
Pianifica ed esegui gli errori utilizzando strumenti come Chaos Monkey. Puoi utilizzare script personalizzati per simulare errori di servizi critici, come l'arresto di un nodo principale in un cluster GKE multizona o un'istanza Cloud SQL disabilitata. Puoi anche utilizzare gli script per simulare un'interruzione della rete a livello di regione utilizzando regole firewall o limitazioni dell'API in base all'ambito del test. Aumenta gradualmente gli scenari di errore per osservare il comportamento del sistema in varie condizioni.
Introduci i test di carico insieme agli scenari di errore per replicare l'utilizzo reale durante le interruzioni. Testa gli impatti degli errori a cascata, ad esempio il comportamento dei sistemi frontend quando i servizi di backend non sono disponibili.
Per convalidare le modifiche alla configurazione e valutare la resilienza del sistema agli errori umani, testa gli scenari che comportano configurazioni errate. Ad esempio, esegui test con impostazioni di failover DNS errate o autorizzazioni IAM errate.
Monitora il comportamento del sistema
Monitora il modo in cui i bilanciatori del carico, i controlli di integrità e altri meccanismi cambiano il percorso del traffico. Utilizza strumenti Google Cloud come Cloud Monitoring e Cloud Logging per acquisire metriche ed eventi durante il test.
Osserva le variazioni di latenza, frequenza degli errori e velocità effettiva durante e dopo la simulazione degli errori e monitora l'impatto complessivo sulle prestazioni. Identifica eventuali peggioramenti o incoerenze nell'esperienza utente.
Assicurati che vengano generati log e attivati avvisi per gli eventi chiave, come interruzioni del servizio o failover. Utilizza questi dati per verificare l'efficacia dei tuoi sistemi di avviso e risposta agli incidenti.
Verifica il recupero in base ai tuoi RTO e RPO
Misura il tempo necessario al sistema per riprendere le normali operazioni dopo un errore, quindi confronta questi dati con l'RTO definito e documenta eventuali lacune.
Assicurati che l'integrità e la disponibilità dei dati siano in linea con l'RPO. Per testare la coerenza del database, confronta gli snapshot o i backup del database prima e dopo un errore.
Valuta il ripristino dei servizi e verifica che tutti i servizi siano stati ripristinati in uno stato funzionale con un'interruzione minima per gli utenti.
Documenta e analizza i risultati
Documenta ogni passaggio del test, lo scenario di errore e il comportamento del sistema corrispondente. Includi timestamp, log e metriche per analisi dettagliate.
Evidenzia i colli di bottiglia, i single point of failure o i comportamenti imprevisti osservati durante il test. Per stabilire le priorità delle correzioni, classifica i problemi in base alla gravità e all'impatto.
Suggerisci miglioramenti all'architettura del sistema, ai meccanismi di failover o alle configurazioni di monitoraggio. In base ai risultati dei test, aggiorna le policy di failover e i playbook pertinenti. Presentare un report post-mortem agli stakeholder. Il report deve riassumere i risultati, le lezioni apprese e i passaggi successivi. Per saperne di più, consulta Esegui post-mortem approfondite.
Itera e migliora
Per convalidare l'affidabilità e la resilienza nel tempo, pianifica test periodici (ad esempio, trimestrali).
Esegui test in diversi scenari, tra cui modifiche all'infrastruttura, aggiornamenti software e aumento dei carichi di traffico.
Automatizza i test di failover utilizzando le pipeline CI/CD per integrare i test di affidabilità nel ciclo di vita dello sviluppo.
Durante la fase di post-mortem, utilizza il feedback degli stakeholder e degli utenti finali per migliorare il processo di test e la resilienza del sistema.
Esegui test per il recupero dalla perdita di dati
Questo principio del pilastro dell'affidabilità del Google Cloud Well-Architected Framework fornisce consigli per aiutarti a progettare ed eseguire test per il recupero dalla perdita di dati.
Questo principio è pertinente all'area di interesse Apprendimento dell'affidabilità.
Panoramica del principio
Per assicurarti che il tuo sistema possa riprendersi da situazioni in cui i dati vengono persi o danneggiati, devi eseguire test per questi scenari. I casi di perdita di dati potrebbero essere causati da un bug del software o da un qualche tipo di calamità naturale. Dopo questi eventi, devi ripristinare i dati dai backup e riattivare tutti i servizi utilizzando i dati appena ripristinati.
Ti consigliamo di utilizzare tre criteri per valutare l'esito positivo o negativo di questo tipo di test di ripristino: integrità dei dati, Recovery Time Objective (RTO) e Recovery Point Objective (RPO). Per informazioni dettagliate sulle metriche RTO e RPO, consulta Nozioni di base RE DR.
L'obiettivo dei test di ripristino dei dati è verificare periodicamente che la tua organizzazione possa continuare a soddisfare i requisiti di continuità aziendale. Oltre a misurare RTO e RPO, un test di ripristino dei dati deve includere il test dell'intero stack di applicazioni e di tutti i servizi di infrastruttura critica con i dati ripristinati. Questa operazione è necessaria per confermare che l'intera applicazione di cui è stato eseguito il deployment funzioni correttamente nell'ambiente di test.
Consigli
Quando progetti ed esegui test per il recupero dalla perdita di dati, tieni conto dei suggerimenti riportati nelle sottosezioni seguenti.
Verifica la coerenza dei backup e testa i processi di ripristino
Devi verificare che i backup contengano snapshot dei dati coerenti e utilizzabili che puoi ripristinare per rimettere immediatamente in servizio le applicazioni. Per convalidare l'integrità dei dati, configura controlli di coerenza automatici da eseguire dopo ogni backup.
Per testare i backup, ripristinali in un ambiente non di produzione. Per assicurarti che i backup possano essere ripristinati in modo efficiente e che i dati ripristinati soddisfino i requisiti dell'applicazione, simula regolarmente scenari di recupero dati. Documenta i passaggi per il ripristino dei dati e addestra i tuoi team a eseguirli in modo efficace durante un errore.
Pianifica backup regolari e frequenti
Per ridurre al minimo la perdita di dati durante il ripristino e raggiungere gli obiettivi RPO, è essenziale eseguire backup pianificati regolarmente. Stabilisci una frequenza di backup in linea con il tuo RPO. Ad esempio, se l'RPO è di 15 minuti, pianifica l'esecuzione dei backup almeno ogni 15 minuti. Ottimizza gli intervalli di backup per ridurre il rischio di perdita di dati.
Utilizza strumenti Google Cloud come Cloud Storage, i backup automatici di Cloud SQL o i backup di Spanner per pianificare e gestire i backup. Per le applicazioni critiche, utilizza soluzioni di backup quasi continuo come il recupero point-in-time (PITR) per Cloud SQL o i backup incrementali per set di dati di grandi dimensioni.
Definisci e monitora l'RPO
Imposta un RPO chiaro in base alle tue esigenze aziendali e monitora l'aderenza all'RPO. Se gli intervalli di backup superano l'RPO definito, utilizza Cloud Monitoring per configurare gli avvisi.
Monitora lo stato del backup
Utilizza il servizio di RE e DRGoogle Cloud o strumenti simili per monitorare l'integrità dei backup e verificare che siano archiviati in posizioni sicure e affidabili. Assicurati che i backup vengano replicati in più regioni per una maggiore resilienza.
Pianifica scenari che vanno oltre il backup
Combina i backup con strategie di ripristino di emergenza come configurazioni di failover attivo-attivo o replica tra regioni per migliorare i tempi di ripristino in casi estremi. Per saperne di più, consulta la Guida alla pianificazione del disaster recovery.
Esegui post-mortem approfonditi
Questo principio del pilastro dell'affidabilità del Google Cloud Well-Architected Framework fornisce consigli per aiutarti a condurre post-mortem efficaci dopo errori e incidenti.
Questo principio è pertinente all'area di interesse Apprendimento dell'affidabilità.
Panoramica del principio
Un'analisi post mortem è un resoconto scritto di un incidente, del suo impatto, delle azioni intraprese per mitigarlo o risolverlo, delle cause principali e delle azioni di follow-up per evitare che si ripeta. L'obiettivo di un postmortem è imparare dagli errori e non attribuire colpe.
Il seguente diagramma mostra il flusso di lavoro di un postmortem:
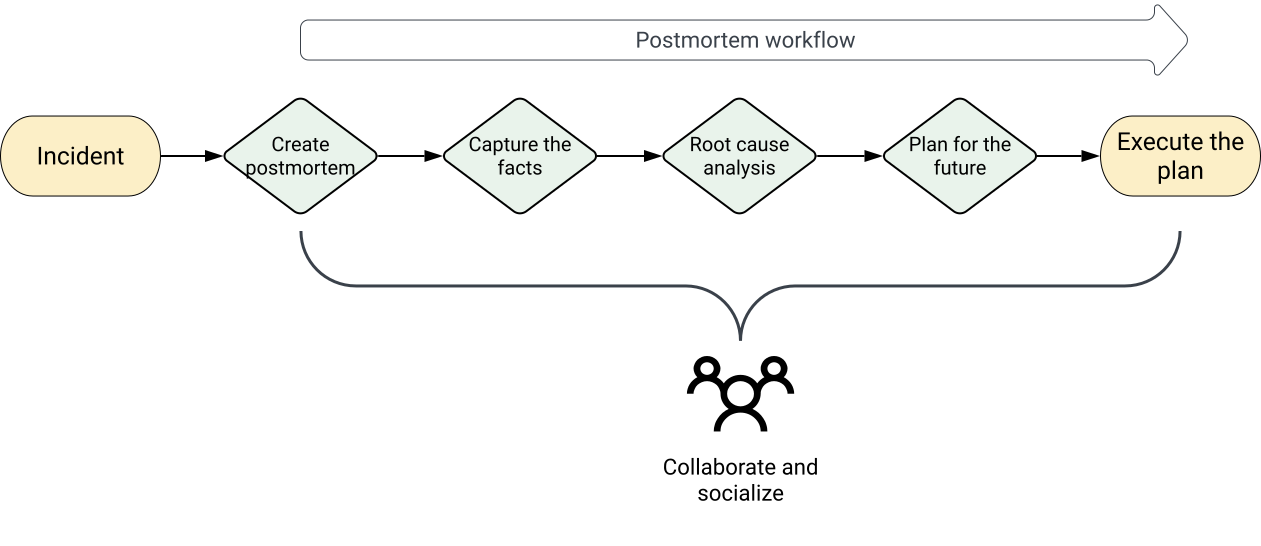
Il flusso di lavoro di un postmortem include i seguenti passaggi:
- Crea postmortem
- Acquisisci i fatti
- Identifica e analizza le cause principali
- Pianifica per il futuro
- Esegui il piano
Esegui analisi post mortem dopo eventi importanti e non importanti, come i seguenti:
- Tempi di inattività o peggioramenti visibili agli utenti oltre una determinata soglia.
- Perdite di dati di qualsiasi tipo.
- Interventi da parte degli ingegneri on-call, come il rollback di una release o il reindirizzamento del traffico.
- Tempi di risoluzione superiori a una soglia definita.
- Errori di monitoraggio, che di solito implicano il rilevamento manuale degli incidenti.
Consigli
Definisci i criteri per il postmortem prima che si verifichi un incidente, in modo che tutti sappiano quando è necessario un postmortem.
Per condurre postmortem efficaci, prendi in considerazione i consigli riportati nelle sottosezioni seguenti.
Esegui analisi post mortem senza attribuzione delle colpe
I postmortem efficaci si concentrano su processi, strumenti e tecnologie e non attribuiscono la colpa a singoli individui o team. Lo scopo di un'analisi post-mortem è migliorare la tecnologia e il futuro, non trovare i colpevoli. Tutti commettiamo errori. L'obiettivo deve essere analizzare gli errori e imparare da questi.
I seguenti esempi mostrano la differenza tra un feedback che attribuisce la colpa e un feedback senza colpe:
- Feedback che attribuisce la colpa: "Dobbiamo riscrivere l'intero complicato sistema di backend! Si è rotto ogni settimana negli ultimi tre trimestri e sono sicuro che siamo tutti stanchi di risolvere i problemi un po' alla volta. Seriamente, se mi chiamano un'altra volta, lo riscrivo io…"
- Feedback senza colpe: "Un'attività per riscrivere l'intero sistema di backend potrebbe effettivamente impedire che queste pagine continuino a verificarsi. Il manuale di manutenzione di questa versione è piuttosto lungo e molto difficile da imparare completamente. Sono sicuro che i nostri futuri on-call engineer ci ringrazieranno!"
Rendi il report postmortem leggibile da tutti i segmenti di pubblico previsti
Per ogni informazione che prevedi di includere nel report, valuta se è importante e necessaria per aiutare il pubblico a capire cosa è successo. Puoi spostare i dati e le spiegazioni supplementari in un'appendice del report. I revisori che hanno bisogno di ulteriori informazioni possono richiederle.
Evita soluzioni complesse o eccessivamente ingegnerizzate
Prima di iniziare a esplorare le soluzioni per un problema, valuta l'importanza del problema e la probabilità che si ripresenti. Aggiungere complessità al sistema per risolvere problemi che difficilmente si verificheranno di nuovo può portare a una maggiore instabilità.
Condividi il postmortem nel modo più ampio possibile
Per assicurarti che i problemi non rimangano irrisolti, pubblica il risultato del postmortem per un vasto pubblico e ottieni il supporto della dirigenza. Il valore di un postmortem è proporzionale all'apprendimento che avviene dopo il postmortem. Quando più persone imparano dagli incidenti, la probabilità che si verifichino errori simili si riduce.