


您可以使用 Dataflow ML 的大規模資料處理功能,建立預測和推論管道,以及準備訓練資料。
需求條件和限制
- Dataflow ML 支援批次和串流管道。
- Apache Beam 2.40.0 以上版本支援
RunInferenceAPI。 - Apache Beam 2.53.0 以上版本支援
MLTransformAPI。 - 模型處理常式適用於 PyTorch、scikit-learn、TensorFlow、ONNX 和 TensorRT。如果是不支援的架構,則可使用自訂模型處理常式。
準備訓練資料
使用
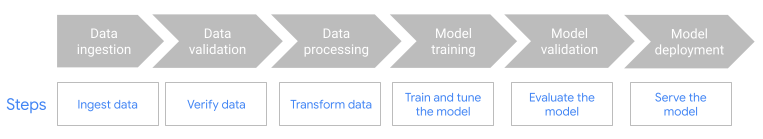
MLTransform功能準備資料,用於訓練機器學習模型。詳情請參閱「使用MLTransform預先處理資料」。搭配使用 Dataflow 與機器學習作業架構,例如 Kubeflow Pipelines (KFP) 或 TensorFlow Extended (TFX)。詳情請參閱「機器學習工作流程中的 Dataflow ML」。
預測和推論管道
Dataflow ML 結合 Dataflow 的強大功能與 Apache Beam 的 RunInference API。使用 RunInference API 時,您需要定義模型的特徵和屬性,並將該設定傳遞至 RunInference 轉換。這項功能可讓使用者在 Dataflow 管道中執行模型,而不必瞭解模型的實作細節。您可以選擇最適合資料的架構,例如 TensorFlow 和 PyTorch。
在管道中執行多個模型
使用 RunInference 轉換,將多個推論模型新增至 Dataflow 管道。如需更多資訊 (包括程式碼詳細資料),請參閱 Apache Beam 說明文件中的「多模型管道」。
建構跨語言管道
如要在 Java 管道中使用 RunInference,請建立跨語言 Python 轉換。管道會呼叫轉換作業,執行預先處理、後製處理和推論。
如需詳細操作說明和範例管道,請參閱「使用 Java SDK 的 RunInference」。
搭配 Dataflow 使用 GPU
如果批次或串流管道需要使用加速器,您可以在 NVIDIA GPU 裝置上執行 Dataflow 管道。詳情請參閱「使用 GPU 執行 Dataflow 管道」。
排解 Dataflow ML 問題
本節提供疑難排解策略和連結,有助於您使用 Dataflow ML。
堆疊預期每個張量的大小都相同
使用 RunInference API 時,如果提供的圖片大小不同,或字詞嵌入長度不同,可能會發生下列錯誤:
File "/beam/sdks/python/apache_beam/ml/inference/pytorch_inference.py", line 232, in run_inference batched_tensors = torch.stack(key_to_tensor_list[key]) RuntimeError: stack expects each tensor to be equal size, but got [12] at entry 0 and [10] at entry 1 [while running 'PyTorchRunInference/ParDo(_RunInferenceDoFn)']
發生這項錯誤的原因是 RunInference API 無法批次處理不同大小的張量元素。如需解決方法,請參閱 Apache Beam 說明文件中的「無法批次處理張量元素」。
避免大型模型發生記憶體不足錯誤
載入中型或大型機器學習模型時,機器可能會發生記憶體不足。Dataflow 提供工具,可協助避免在載入機器學習模型時發生記憶體不足 (OOM) 錯誤。詳情請參閱「RunInference 轉換最佳做法」。
後續步驟
- 瀏覽 Dataflow ML 筆記本,查看特定用途。
- 如要深入瞭解如何搭配使用機器學習與 Apache Beam,請參閱 Apache Beam 的 AI/機器學習管道說明文件。
- 進一步瞭解
RunInferenceAPI。 - 瞭解
RunInference最佳做法。 - 瞭解可用來監控
RunInference轉換作業的指標。