


本頁面說明使用 MLTransform 功能的原因和方法,協助您準備資料,用於訓練機器學習 (ML) 模型。只要在一個類別中合併多個資料處理轉換,MLTransform 就能簡化將 Apache Beam ML 資料處理作業套用至工作流程的程序。
如要瞭解如何使用 MLTransform 執行嵌入生成工作,請參閱「使用 MLTransform 生成嵌入」。
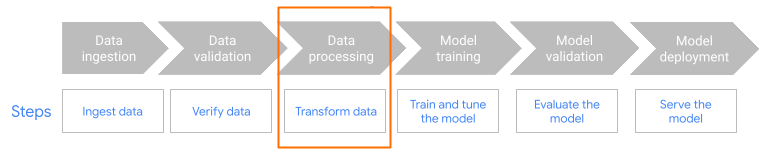
MLTransform。優點
MLTransform 類別具有下列優點:
- 轉換資料,不必編寫複雜的程式碼或管理基礎程式庫。
- 透過單一介面有效率地鏈結多種處理作業。
生成嵌入,用於將資料推送至向量資料庫或執行推論。
如要進一步瞭解如何生成嵌入,請參閱「使用 MLTransform 生成嵌入」。
支援與限制
MLTransform 類別有下列限制:
- 適用於使用 Apache Beam Python SDK 2.53.0 以上版本的管道。
- 管道必須使用預設視窗。
使用 TFT 的資料處理轉換:
- 支援 Python 3.9、3.10、3.11。
- 支援批次管道。
用途
範例筆記本示範如何將 MLTransform 用於嵌入特定用途。
- 我想從資料集計算詞彙
- 從資料集計算出不重複的詞彙,然後將每個字詞或符記對應至不同的整數索引。使用這項轉換功能,將文字資料轉換為數值表示法,以用於機器學習任務。
- 我想擴充資料,訓練機器學習模型
- 擴充資料,以便用於訓練機器學習模型。Apache Beam
MLTransform類別包含多個資料縮放轉換。
如需可用轉換的完整清單,請參閱 Apache Beam 說明文件中的「轉換」一節。
使用 MLTransform
如要使用 MLTransform 類別預先處理資料,請在管道中加入下列程式碼:
  import apache_beam as beam
  from apache_beam.ml.transforms.base import MLTransform
  from apache_beam.ml.transforms.tft import TRANSFORM_NAME
  import tempfile

  data = [
      {
          DATA
      },
  ]

  artifact_location = gs://BUCKET_NAME
  TRANSFORM_FUNCTION_NAME = TRANSFORM_NAME(columns=['x'])

  with beam.Pipeline() as p:
    transformed_data = (
        p
        | beam.Create(data)
        | MLTransform(write_artifact_location=artifact_location).with_transform(
            TRANSFORM_FUNCTION_NAME)
        | beam.Map(print))
替換下列值:
TRANSFORM_NAME:要使用的轉換名稱BCUKET_NAME:Cloud Storage bucket 的名稱DATA:要轉換的輸入資料TRANSFORM_FUNCTION_NAME:在程式碼中指派給轉換函式的名稱
後續步驟
- 如要進一步瞭解
MLTransform,請參閱 Apache Beam 說明文件中的「預先處理資料」。 - 如需更多範例,請參閱 Apache Beam 轉換目錄中的「
MLTransformfor data processing 」(用於資料處理的 )。 - 在 Colab 中執行互動式筆記本。