


In diesem Dokument wird beschrieben, wie Sie mit Knowledge Studio relevante Daten-Assets finden und darüber chatten, visuell untersuchen, wie diese Daten-Assets verbunden sind, und Antworten zu den Daten-Assets in natürlicher Sprache finden. Knowledge Studio kombiniert eine konversationelle Chatoberfläche mit einem interaktiven Kontextgraphen, damit Sie Ihre gesamte Datenlandschaft intuitiv erkunden und darin navigieren können.
Dieses Dokument richtet sich an Datenanalysten, Geschäftsanalysten und Data Stewards, die ihre Unternehmensmetadaten in natürlicher Sprache abfragen und Beziehungen zu ihren Daten-Assets in einem Kontextgraphen visuell darstellen möchten.
Funktionsweise des explorativen Analysetools
Die Benutzeroberfläche Neuer Chat bietet die folgenden Funktionen für die interaktive Datenerkennung:
Schnittstelle für natürliche Sprache: Stellen Sie Fragen auf Englisch zu Ihrem Datenbestand (z. B. „Welche Tabellen enthalten Abwanderungsmesswerte für europäische Kunden?“).
Chat mit Gemini: Der Agent basiert auf Gemini und analysiert Ihre Fragen in natürlicher Sprache, führt Such- und Metadaten-Suchtools im Knowledge Catalog aus, formuliert mehrstufige Erkundungspläne und zeigt den Fortschritt in minimierbaren Denkspuren an.
Kontextdiagramm-Visualisierung: Interaktiv durch die Beziehungen zwischen Datasets, Tabellen, Abfragen und Geschäftsbegriffen navigieren. In der visuellen Grafik werden die aktiven Knoten und Einstiegslinks angezeigt, die den Arbeits-Kontextsatz für Ihre Explorationssitzung bilden. Klicken Sie auf Knoten, um detaillierte Spaltenschemas zu prüfen, aktive Knotenschubladen-Einträge zu überprüfen oder das Diagramm nach Asset-Typ zu filtern.
BigQuery-Unterstützung beim Programmieren ausführen: Validieren Sie Datenbeziehungen, indem Sie generierte SQL-Abfragen direkt in der Explorations-Oberfläche für Ihr Data Warehouse ausführen.
Der Kontextgraph visualisiert semantische Geschäftsbeziehungen, Glossardefinitionen und verifizierte Join-Pfade. Es ist kein Viewer für die Ausführung von ETL-Pipelines. Wenn Sie die Transformationsschritte der Pipeline, die Laufzeitjobs oder die operativen Datenflüsse (z. B. Dataflow-Pipelines) prüfen möchten, rufen Sie die Datenherkunft in Knowledge Catalog auf. Weitere Informationen finden Sie unter Datenherkunft verwenden.
Hinweis
-
In the Google Cloud console, on the project selector page, select or create a Google Cloud project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
-
If you're using an existing project for this guide, verify that you have the permissions required to complete this guide. If you created a new project, then you already have the required permissions.
-
Verify that billing is enabled for your Google Cloud project.
- Prüfen Sie, ob Ihre Daten-Assets vorhanden sind. Knowledge Catalog nimmt automatisch strukturelle und operative Metadaten aus zentralen Google Cloud -Diensten auf, ohne dass eine manuelle Konfiguration erforderlich ist. Für Organisationen mit maßgeschneiderten Wissensdatenbanken, Governance-Tools von Drittanbietern oder lokalen Systemen bietet Knowledge Catalog flexible Mechanismen für die Datenaufnahme:
- Optional: Prüfen Sie, ob Unternehmensglossare und ‑begriffe (z. B. Definitionen von Geschäfts-KPIs) in Knowledge Catalog konfiguriert und mit Ihren zugrunde liegenden Daten-Assets verknüpft sind. Weitere Informationen finden Sie unter Unternehmensglossar verwalten.
- Aktivieren Sie die erforderlichen APIs:
Für die grundlegende Untersuchung erforderlich:
- Dataplex API (
dataplex.googleapis.com): Erforderlich, um Knowledge Studio zu öffnen, den Katalog zu durchsuchen und den Kontextgraphen und Glossare zu erkunden.
Erforderlich pro Funktion (in Ihrem Projekt aktiviert):
- BigQuery API (
bigquery.googleapis.com): Zum Durchsuchen von BigQuery-Datasets und -Tabellen, Prüfen von Abfragejobs und Ausführen von SQL-Abfragen. - Data Lineage API (
datalineage.googleapis.com): Zum Durchsuchen der Upstream- und Downstream-Datenherkunft und zum Prüfen von Herkunftsprozessen. - Gemini Data Analytics API (
geminidataanalytics.googleapis.com): Zum Verwenden von BigQuery-Konversationsanalysen und zum Generieren von Insights zur Datenverteilung. - Google Documents API (
docs.googleapis.com): Zum Lesen von Google-Dokumenten, die in Chat-Prompts verlinkt sind.
- Dataplex API (
Erforderliche Rollen
Bitten Sie Ihren Administrator, Ihnen die folgenden IAM-Rollen für Ihr Projekt zuzuweisen, um die Berechtigungen zu erhalten, die Sie zum Erkunden von Daten-Assets und des Kontextgraphen in Knowledge Studio benötigen:
-
Suche im Kernkatalog und Kontextdiagramm-Exploration:
- Dataplex Catalog-Betrachter (
roles/dataplex.catalogViewer) - Service Usage Consumer (
roles/serviceusage.serviceUsageConsumer)
- Dataplex Catalog-Betrachter (
-
BigQuery-Metadaten durchsuchen und SQL-Abfragen ausführen:
- BigQuery Metadata Viewer (
roles/bigquery.metadataViewer) - BigQuery Data Viewer (
roles/bigquery.dataViewer) - BigQuery Job User (
roles/bigquery.jobUser)
- BigQuery Metadata Viewer (
-
Konversationelle Analysen in BigQuery verwenden:
- Gemini for Google Cloud Data Agent Stateless User (
roles/geminidataanalytics.dataAgentStatelessUser) - BigQuery Data Viewer (
roles/bigquery.dataViewer) - BigQuery Job User (
roles/bigquery.jobUser)
- Gemini for Google Cloud Data Agent Stateless User (
-
Data Lineage durchsuchen:
- Data Lineage Viewer (
roles/datalineage.viewer) - BigQuery Resource Viewer (
roles/bigquery.resourceViewer)
- Data Lineage Viewer (
Weitere Informationen zum Zuweisen von Rollen finden Sie unter Zugriff auf Projekte, Ordner und Organisationen verwalten.
Sie können die erforderlichen Berechtigungen auch über benutzerdefinierte Rollen oder andere vordefinierte Rollen erhalten.
Ihrem Nutzerkonto Rollen zuweisen
Wenn Sie die erforderlichen Berechtigungen zum Verwalten des IAM-Zugriffs (Identity and Access Management) in Ihrem Projekt haben, können Sie diese Rollen Ihrem eigenen Nutzerkonto zuweisen. Verwenden Sie zum Zuweisen von Rollen den Befehl gcloud projects add-iam-policy-binding:
Ersetzen Sie folgende Werte, bevor sie einen der Befehlsdaten verwenden:
- PROJECT_ID: Projekt-ID in Google Cloud .
- USER_EMAIL: Die E-Mail-Adresse Ihres Nutzerkontos (z. B.
name@example.com).
Führen Sie folgenden Befehl aus:
Linux, macOS oder Cloud Shell
gcloud projects add-iam-policy-binding PROJECT_ID \
    --member="user:USER_EMAIL" \
    --role="roles/dataplex.catalogViewer"

gcloud projects add-iam-policy-binding PROJECT_ID \
    --member="user:USER_EMAIL" \
    --role="roles/serviceusage.serviceUsageConsumer"

gcloud projects add-iam-policy-binding PROJECT_ID \
    --member="user:USER_EMAIL" \
    --role="roles/bigquery.metadataViewer"

gcloud projects add-iam-policy-binding PROJECT_ID \
    --member="user:USER_EMAIL" \
    --role="roles/bigquery.dataViewer"

gcloud projects add-iam-policy-binding PROJECT_ID \
    --member="user:USER_EMAIL" \
    --role="roles/bigquery.jobUser"

gcloud projects add-iam-policy-binding PROJECT_ID \
    --member="user:USER_EMAIL" \
    --role="roles/geminidataanalytics.dataAgentStatelessUser"

gcloud projects add-iam-policy-binding PROJECT_ID \
    --member="user:USER_EMAIL" \
    --role="roles/datalineage.viewer"

gcloud projects add-iam-policy-binding PROJECT_ID \
    --member="user:USER_EMAIL" \
    --role="roles/bigquery.resourceViewer"
Windows (PowerShell)
gcloud projects add-iam-policy-binding PROJECT_ID `
    --member="user:USER_EMAIL" `
    --role="roles/dataplex.catalogViewer"

gcloud projects add-iam-policy-binding PROJECT_ID `
    --member="user:USER_EMAIL" `
    --role="roles/serviceusage.serviceUsageConsumer"

gcloud projects add-iam-policy-binding PROJECT_ID `
    --member="user:USER_EMAIL" `
    --role="roles/bigquery.metadataViewer"

gcloud projects add-iam-policy-binding PROJECT_ID `
    --member="user:USER_EMAIL" `
    --role="roles/bigquery.dataViewer"

gcloud projects add-iam-policy-binding PROJECT_ID `
    --member="user:USER_EMAIL" `
    --role="roles/bigquery.jobUser"

gcloud projects add-iam-policy-binding PROJECT_ID `
    --member="user:USER_EMAIL" `
    --role="roles/geminidataanalytics.dataAgentStatelessUser"

gcloud projects add-iam-policy-binding PROJECT_ID `
    --member="user:USER_EMAIL" `
    --role="roles/datalineage.viewer"

gcloud projects add-iam-policy-binding PROJECT_ID `
    --member="user:USER_EMAIL" `
    --role="roles/bigquery.resourceViewer"
Windows (cmd.exe)
gcloud projects add-iam-policy-binding PROJECT_ID ^
    --member="user:USER_EMAIL" ^
    --role="roles/dataplex.catalogViewer"

gcloud projects add-iam-policy-binding PROJECT_ID ^
    --member="user:USER_EMAIL" ^
    --role="roles/serviceusage.serviceUsageConsumer"

gcloud projects add-iam-policy-binding PROJECT_ID ^
    --member="user:USER_EMAIL" ^
    --role="roles/bigquery.metadataViewer"

gcloud projects add-iam-policy-binding PROJECT_ID ^
    --member="user:USER_EMAIL" ^
    --role="roles/bigquery.dataViewer"

gcloud projects add-iam-policy-binding PROJECT_ID ^
    --member="user:USER_EMAIL" ^
    --role="roles/bigquery.jobUser"

gcloud projects add-iam-policy-binding PROJECT_ID ^
    --member="user:USER_EMAIL" ^
    --role="roles/geminidataanalytics.dataAgentStatelessUser"

gcloud projects add-iam-policy-binding PROJECT_ID ^
    --member="user:USER_EMAIL" ^
    --role="roles/datalineage.viewer"

gcloud projects add-iam-policy-binding PROJECT_ID ^
    --member="user:USER_EMAIL" ^
    --role="roles/bigquery.resourceViewer"
Sie können diese Befehle in Cloud Shell oder in einem lokalen Terminal ausführen, in dem die Google Cloud CLI installiert und initialisiert ist.
Explorations-Oberfläche öffnen
Rufen Sie in der Google Cloud Console Knowledge Studio (Vorabversion) auf.
Die Benutzeroberfläche enthält die folgenden Elemente:
Seitenleiste: Hier können Sie eine neue Erkundungssitzung starten (Neuer Chat), nach früheren Chatsitzungen suchen oder zwischen den Oberflächen Neuer Chat, Kontextsätze und Anreicherungen wechseln.
Konversationsfenster: Enthält ein zentrales Prompt-Feld mit der Modellauswahl und Einstiegsprompt-Chips wie Welche Daten habe ich im Knowledge Catalog?.
Graphbereich anzeigen -Symbol: Öffnet oder schließt den Bereich Kontextdiagramm.
Daten-Assets mithilfe natürlicher Sprache finden
Wenn Sie nach Daten-Assets suchen möchten, geben Sie im Prompt-Feld der Oberfläche Neuer Chat eine Frage ein oder klicken Sie auf einen der Chips für Einstiegsprompts (z. B. Welche Daten habe ich in Knowledge Catalog?).
Gemini analysiert Ihre Anfrage, führt interne Erkennungstools aus und zeigt strukturierte Ergebnisse im Chatbereich an.
Je nach Anfrage kann die Chatantwort des KI-Agenten Folgendes enthalten:
- Maximierbare Bereiche für übereinstimmende Assets: Zeigt interaktive Kartenzusammenfassungen der gefundenen Daten-Assets an, gruppiert nach Typ (z. B. Tabellen oder Glossare).
- Textzusammenfassungen: Beschreibt die gefundenen Kerndatasets, Tabellen und Glossare.
- Anleitung für Folgeschritte: Der Agent schlägt nächste Schritte vor, z. B. das Erkunden bestimmter Domains oder das Prüfen von Tabellenschemas.

Abbildung 1. Die Chatantwort mit passenden Assets, Zusammenfassungen von Datasets und weiterführenden Hinweisen. (Klicken Sie auf das Bild, um es zu vergrößern.) Optional: Wenn Sie die Denkprozessschritte und internen Toolaufrufe des KI-Agenten prüfen möchten, maximieren Sie den Abschnitt Thinking in der Chatantwort. In diesem Abschnitt wird die mehrstufige Suchstrategie des KI-Agenten erläutert, einschließlich des Übergangs von allgemeinen Suchanfragen zu gezielten Asset-Filtern. Die folgende Liste enthält einige der internen Vorgänge, die der Agent möglicherweise ausführt, um Ihre Anfragen zu beantworten:
Katalogsuche: Fragt Knowledge Catalog mit genauen Projekteinschränkungen ab, wobei Stichwort- und semantische Übereinstimmungen verwendet werden (z. B. Filtern nach
type=datasetodertype=context-set). Weitere Informationen zu den zugrunde liegenden Mechanismen finden Sie unter Nach Daten-Assets suchen.Metadatenabruf: Ruft Schemas, Beschreibungen und Herkunft für übereinstimmende Einträge ab. Für BigQuery-Tabellen werden auch verknüpfte Unternehmensglossare und strukturell verwandte Tabellen abgerufen. Weitere Informationen zur zugrunde liegenden API finden Sie unter Kontext für Daten-Assets abrufen.
UI-Rendering: Formatiert die abgerufenen Metadaten als interaktive Karten im Chatbereich.
Suchbereich und Begründung konfigurieren
Damit Gemini möglichst genaue Antworten liefert und Sie nicht zu lange auf eine Antwort warten müssen, können Sie die Zielumgebung und die Komplexität der Argumentation des Agenten über die Drop-down-Menüs unter dem Chat-Prompt-Feld einschränken:
Daten durchsuchen in: Beschränkt die internen Suchvorgänge des KI-Agenten auf ein oder mehrere bestimmte Google Cloud -Projekte.
Wählen Sie diese Option, wenn Sie einen großen Knowledge Catalog-Footprint haben und genau wissen, welche Projekte Ihre Ziel-Daten-Assets enthalten. Durch das Filtern nach Projekten wird die Erkennung erheblich beschleunigt und verhindert, dass der Agent halluziniert oder Tabellen mit ähnlichen Namen aus Test- oder Staging-Umgebungen zurückgibt. Lassen Sie diese Einstellung auf Alle Projekte, wenn Sie nicht wissen, wo sich der Datenstandort befindet.
Denkstufe: Steuert, wie tief der Agent über Ihren Prompt nachdenkt. Dadurch wird festgelegt, wie umfassend er Abfragemöglichkeiten bewertet und Suchergebnisse iteriert, bevor er Ihnen antwortet.
Wählen Sie diese Option, wenn Sie die Antwortgeschwindigkeit gegen die Gründlichkeit der Suche abwägen müssen. * Wählen Sie Niedrig für schnelle, direkte und unkomplizierte Keyword-Suchen aus, bei denen der Asset-Name bekannt ist. * Wählen Sie Mittel für typische Explorationsworkflows aus, bei denen der Agent möglicherweise ein oder zwei Folgeabfragen ausführen muss. * Wählen Sie Hoch für komplexe, vage oder mehrdeutige Fragen aus, bei denen der Agent eine mehrstufige Suchstrategie ausführen, die ersten Ergebnisse bewerten und seine Abfragen verfeinern muss, bevor er eine endgültige Antwort zurückgibt.
Spezialisierte Analyse-Agents ausführen
Standardmäßig beschränkt der von Gemini unterstützte Chat Abfragen auf strukturelle Metadaten und beschreibende Kataloge. Wenn Ihre Frage eine tiefgreifende Datenanalyse oder das Ausführen von Abfragen für tatsächliche Tabellendaten erfordert, können Sie spezialisierte Analyse-Agents aufrufen, indem Sie bestimmte Erwähnungen direkt in Ihren Chat-Prompt einfügen.
In der folgenden Liste sind die unterstützten Analyse-Agenten und ihre Funktionen aufgeführt:
@BqJobs: Ruft den Agenten BigQuery-Abfragejob auf. Wenn diese Option aktiviert ist, erhält der von Gemini unterstützte Chat die Berechtigung, SQL-Anweisungen direkt für Ihre Tabellen auszuführen. Verwenden Sie diese Erwähnung, wenn der KI-Agent Ihre Frage durch Abfragen der Daten beantworten soll, anstatt nur Metadaten zu prüfen.Links zu Google-Dokumenten: Wenn Sie einen Link zu einem Google-Dokument in den Chat einfügen, kann der KI-Agent den Inhalt des Dokuments lesen. Sie müssen Google Drive-Lesezugriff auf das verknüpfte Dokument haben und die Google Drive API muss in Ihrem Projekt aktiviert sein.
@BqCA: Ruft den Agenten für konversationelle Analyse in BigQuery auf. Wenn diese Option aktiviert ist, werden Ihre analytischen Fragen (z. B. zu Trends, Aggregationen oder komplexen Business-Intelligence-Workflows) zusammen mit dem Tabellenkontext an einen hochspezialisierten Subagenten übertragen, der in der Lage ist, erweiterte, mehrstufige SQL-Schlussfolgerungen zu ziehen.
Weitere Informationen zu den Funktionen, erforderlichen Berechtigungen und Preisen für diese Sub-Agents finden Sie unter Konversationsanalysen in BigQuery.
Semantische Beziehungen visualisieren
Der Kontextgraph dient als interaktiver Canvas, auf dem Sie technische Speicherressourcen und ihre Beziehungen zu logischen Geschäftssemantiken sehen können.
Datenverbindungen untersuchen
Wenn Sie semantische Beziehungen im Graph-Canvas aktiv untersuchen und erweitern möchten, müssen Sie zuerst den Graphen laden.
Wenn Sie einen ersten Kontextgraphen aus den Chatergebnissen laden möchten, klicken Sie auf eine beliebige Eintragskarte in der Kachel Übereinstimmende Assets. Im Bereich Kontextdiagramm wird ein interaktives topologisches Diagramm für dieses Daten-Asset und die damit verbundenen Entitäten angezeigt.
Um zu verstehen, wie ein Kontextdiagramm die Geschäftslogik dem Datenspeicher zuordnet, sehen Sie sich das szelwico_curated_retail_analytics-Diagramm in Abbildung 2 an.

Dieser Graph dient als Data Warehouse für Berichte und Analysen für ein Tankstellennetz und Convenience Stores.
Der Graph vereint technische Daten-Assets und Geschäftsregeln in einer einzigen Ansicht:
- Zentrale Faktentabellen: Blaue BigQuery-Knoten stellen Transaktionsdaten dar, z. B. tägliche Kraftstoffverkäufe (
fact_daily_station_fuel_sales) und die Leistung des Treuepunkteprogramms (fact_loyalty_promo_attribution). - Dimensionstabellen: Zusätzliche blaue Knoten stellen angereicherte Dimensionstabellen dar, z. B. Stationen (
dim_stations_enriched) und Kundenflotten (dim_customers_and_fleets). - Gesteuerte Geschäftslogik: Gelbe Knoten stellen Glossarbegriffe dar, die strenge Berechnungsregeln für die Daten definieren. Der Knoten Friday Golden Pump 20% Discount definiert beispielsweise, wie eine Nettogebühr nach Rabatt für Mitglieder des Treueprogramms berechnet wird.
- Beziehungen: Die Linien zwischen den Knoten veranschaulichen, wie Tabellen miteinander verknüpft sind, z. B. wie die Dimensionstabelle „Station“ mit der Faktentabelle „Tägliche Kraftstoffverkäufe“ verknüpft ist.
Kontextdiagramm-Canvas
Der Canvas des Kontextgraphen bietet die folgenden primären UI-Bereiche, mit denen Sie die Datentopologie untersuchen können:
- Canvas-Header: Im oberen Header-Menü werden die Anzahl der aktiven Knoten und der Titel des Kontextsets angezeigt. Außerdem finden Sie dort Layout- und Rendering-Optionen:
- Feld „Einträge suchen“: Geben Sie Suchbegriffe in das Feld Einträge nach Name, Dataset oder Beschreibung suchen ein, um neue Daten-Assets zu suchen und manuell direkt dem Canvas-Layout hinzuzufügen.
- Vollbildsymbol: Mit dem Symbol können Sie den Canvas-Darstellungsbereich auf den gesamten Bildschirm maximieren.
- Optionen für die Diagrammansicht: Klicken Sie auf das Symbol Weitere Optionen (), um ein Menü zum Verwalten des Renderings zu öffnen. Es bietet die folgenden Schalter:
- Nur Fokusknoten: Blendet umliegende Verbindungen aus, um nur die Knoten im Kontext hervorzuheben.
- Kanten anzeigen: Schaltet die Sichtbarkeit aller Kantenbeziehungslinien um, um dichte Diagramme übersichtlicher zu gestalten und zu beschleunigen.
- Container hervorheben: Hebt strukturelle Datenbankgruppierungen wie Datasets oder Glossare hervor, in denen sich Knoten befinden.
- Explorer einblenden: Schaltet die Sichtbarkeit des Explorers in der Seitenleiste mit der Knotenliste um.
- Grafiklegende öffnen: Zeigt Definitionen für das visuelle Vokabular der Grafik an.
- Diagrammfilter: Klicken Sie auf das Symbol Diagrammsteuerung (), um den Bereich Filter zu öffnen. Hier können Sie die Diagrammdichte durch Filtern von Verbindungen steuern. Es sind folgende Filterkategorien verfügbar:
- Typen: Filtern Sie Knoten nach Entitätstyp (z. B. Tabellen und Ansichten, Glossarbegriffe, Datenprodukte oder Kontext).
- Beziehungen: Filtern Sie die farbigen Kanten, die Knoten verbinden, nach ihrem Beziehungstyp (z. B. Schema-Join, Verwandt, Definition, Kontext oder Pakete).
- Herkunft: Steuern Sie die Sichtbarkeit von Datenherkunftskanten, einschließlich der Schalter für Upstream (Herkunft, die in einen Knoten fließt) und Downstream (Herkunft, die aus einem Knoten fließt).
- Isolierte Knoten: Wählen Sie Alle Knoten anzeigen, Ausblenden nicht verbundener Knoten oder Nur isolierte Knoten anzeigen aus.
- Hop-Tiefe: Wählen Sie einen Ankerknoten im Canvas aus, von dem aus die Entfernung gemessen werden soll, und wählen Sie dann eine numerische Entfernung aus (z. B. 1, 2, 3 oder Alle), um alle Knoten herauszufiltern, die weiter von Ihrem Anker entfernt sind.
- Canvas-Zoom-Steuerelemente: In der linken unteren Ecke des Canvas finden Sie Steuerelemente zum Verwalten des Viewport-Renderings:
- Zoomsteuerelemente: Verwenden Sie die Schaltflächen Heranzoomen () und Herauszoomen (), um die Grafik zu skalieren.
- An Bildschirm anpassen: Verwenden Sie das Symbol , um die Größe des Diagrammlayouts so anzupassen, dass es vollständig in den Darstellungsbereich passt.
Visuelle Elemente von Diagrammen verstehen
Der Kontextgraph verwendet bestimmte Farben, Symbole und Kantenstile, um verschiedene Arten von Daten-Assets und ihre Beziehungen darzustellen. Wenn Sie Definitionen für das visuelle Vokabular des Diagramms aufrufen möchten, klicken Sie auf das Symbol Weitere Optionen () und wählen Sie Diagrammlegende öffnen aus.
Knotenstatus
Knoten zeigen Badges an, die ihren aktuellen Status im Canvas angeben:
- Ausgewählt: Der Eintrag, den Sie prüfen. Der Rest des Diagramms wird abgeblendet, sodass die Verbindungen hervorgehoben werden.
- Im Fokus des KI-Agenten:Ein Teil Ihres Fokus: die Arbeitsgruppe, die Sie und der KI-Agent untersuchen.
- Wird erweitert: Gibt an, dass das System die mit diesem Eintrag verknüpften Einträge wie Herkunft, Joins und Glossarbegriffe lädt und dem Diagramm hinzufügt.
Farbcodierung von Datenquellen
Die Farbe eines Knotens gibt die zugrunde liegende Datenquelle oder den Entitätstyp an:
- Blau: BigQuery (Tabellen, Ansichten, Datasets).
- Blaugrün: Lakehouse (Kataloge, Namespaces, Tabellen, Ansichten).
- Gelb: Glossar, Katalog oder Knowledge Catalog (Glossare, Begriffe, Kataloge).
- Braun: Datenbank oder Speicher (Spanner, AlloyDB, Cloud Storage).
- Pink: dbt (Modelle, semantische Modelle, Tests, Makros, Exposures).
- Orange: Datenprodukt.
- Rot: Kontext (Kontextsets).
- Grün: Looker (LookML-Projekte, -Modelle, -Explores, -Ansichten).
- Grau: Benutzerdefinierte Assets (benutzerdefinierte Eintragsgruppen und nicht unterstützte Eintragstypen).
Beziehungskanten
Die Linien, die Knoten verbinden, stellen semantische Beziehungen dar. Sie können diese Kanten im Bereich Filter filtern (wie unter Datenverbindungen untersuchen beschrieben):
- Schema-Join: Blaue Kanten, die verifizierte Join-Pfade für mehrere Tabellen, Primärschlüssel und Fremdschlüssel abbilden.
- Definition: Orangefarbene Kanten, die zugrunde liegende Tabellenspalten direkt mit zertifizierten Begriffen des Unternehmensglossars und KPI-Formeln verbinden.
- Kontext: Graue Kanten, die einem Zieldaten-Asset einen speziellen Kontext zuweisen.
- Pakete: Graue Kanten, die zeigen, welche Daten-Assets in einem bestimmten Datenprodukt gebündelt sind.
Einträge manuell zum Kontextgraphen hinzufügen
Anstatt sich nur auf Chatbefehle zu verlassen, können Sie den Kontextgraphen manuell mit bestimmten Daten-Assets direkt über die Canvas-Oberfläche füllen. Das ist nützlich, wenn Sie bereits wissen, welche Ressourcen Sie verbinden und visualisieren möchten.
So suchen Sie nach bestimmten Assets und fügen sie dem Diagramm hinzu:
- Wenn Sie nach Einträgen suchen möchten, klicken Sie direkt im Canvas-Header auf das Feld Einträge nach Name, Dataset oder Beschreibung suchen.
- Optional: Wenn Sie das Zielprojekt ändern möchten, wählen Sie im Drop-down-Menü Projekt ein Google Cloud Projekt aus. Standardmäßig ist hier Alle Projekte festgelegt.
- Geben Sie ein Keyword, einen Dataset-Namen oder eine Eintragsbeschreibung ein.
- Wenn Sie einen Knoten auf dem Canvas platzieren möchten, klicken Sie in der Drop-down-Liste mit den Suchergebnissen auf den gewünschten Eintrag. Das Diagramm wird aktualisiert, um den neuen Knoten anzuzeigen, und alle vorhandenen semantischen oder strukturellen Beziehungen werden automatisch zugeordnet.

Verbindungen für einen bestimmten Knoten untersuchen
Wenn Sie Metadatendetails aufrufen, Beziehungen maximieren oder zusätzliche Aktionen für einen einzelnen Knoten auf dem aktiven Canvas ausführen möchten, können Sie direkt mit dem Knoten interagieren, indem Sie verschiedene Mausklicks verwenden.
Verwenden Sie eine der folgenden Methoden, um mit einem bestimmten Knoten zu interagieren:
Metadaten ansehen: Klicken Sie einmal auf den Knoten, um eine Seitenleiste mit detaillierten Metadaten (z. B. verbundene Knoten) für das ausgewählte Asset zu öffnen.
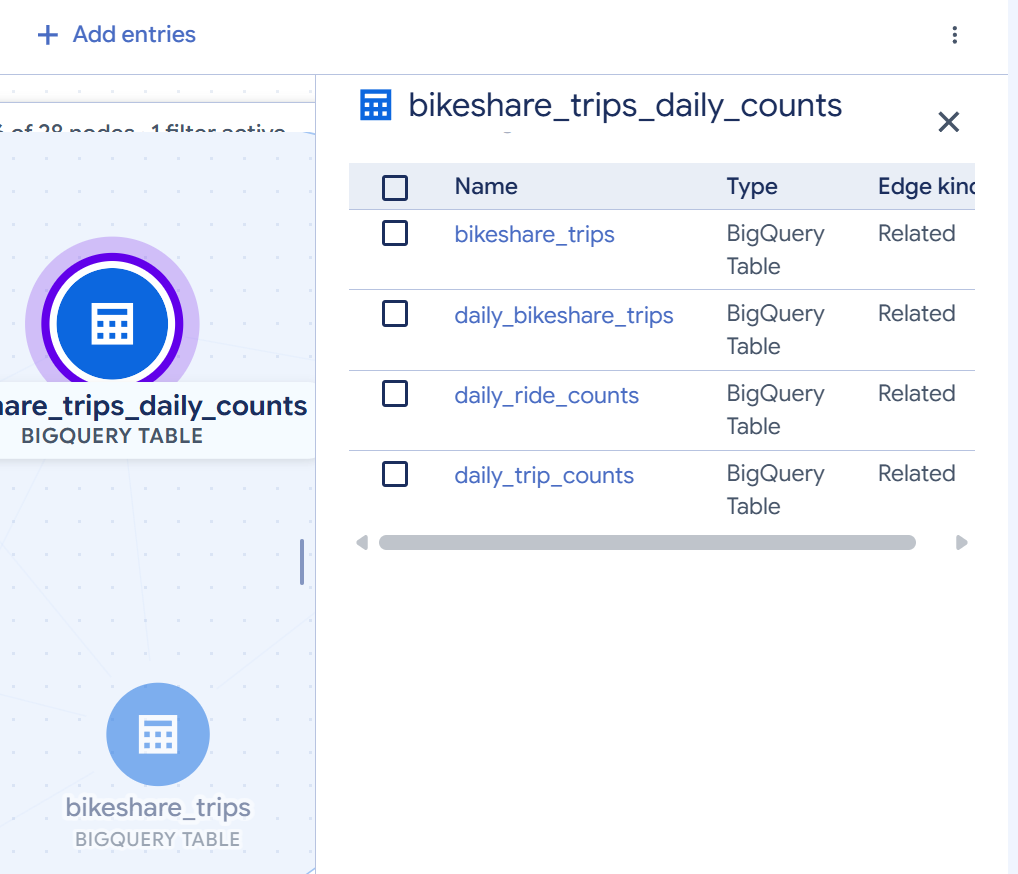
Abbildung 4. Seitenleiste mit Metadatendetails eines Knotens. (Klicken Sie auf das Bild, um es zu vergrößern.) Weitere Optionen öffnen: Wenn Sie auf zusätzliche Aktionen wie das Verfolgen der Herkunft oder das Entfernen des Knotens zugreifen möchten, rechtsklicken Sie auf den Knoten, um das Kontextmenü zu öffnen. In diesem Menü können Sie die folgenden Aktionen auswählen:
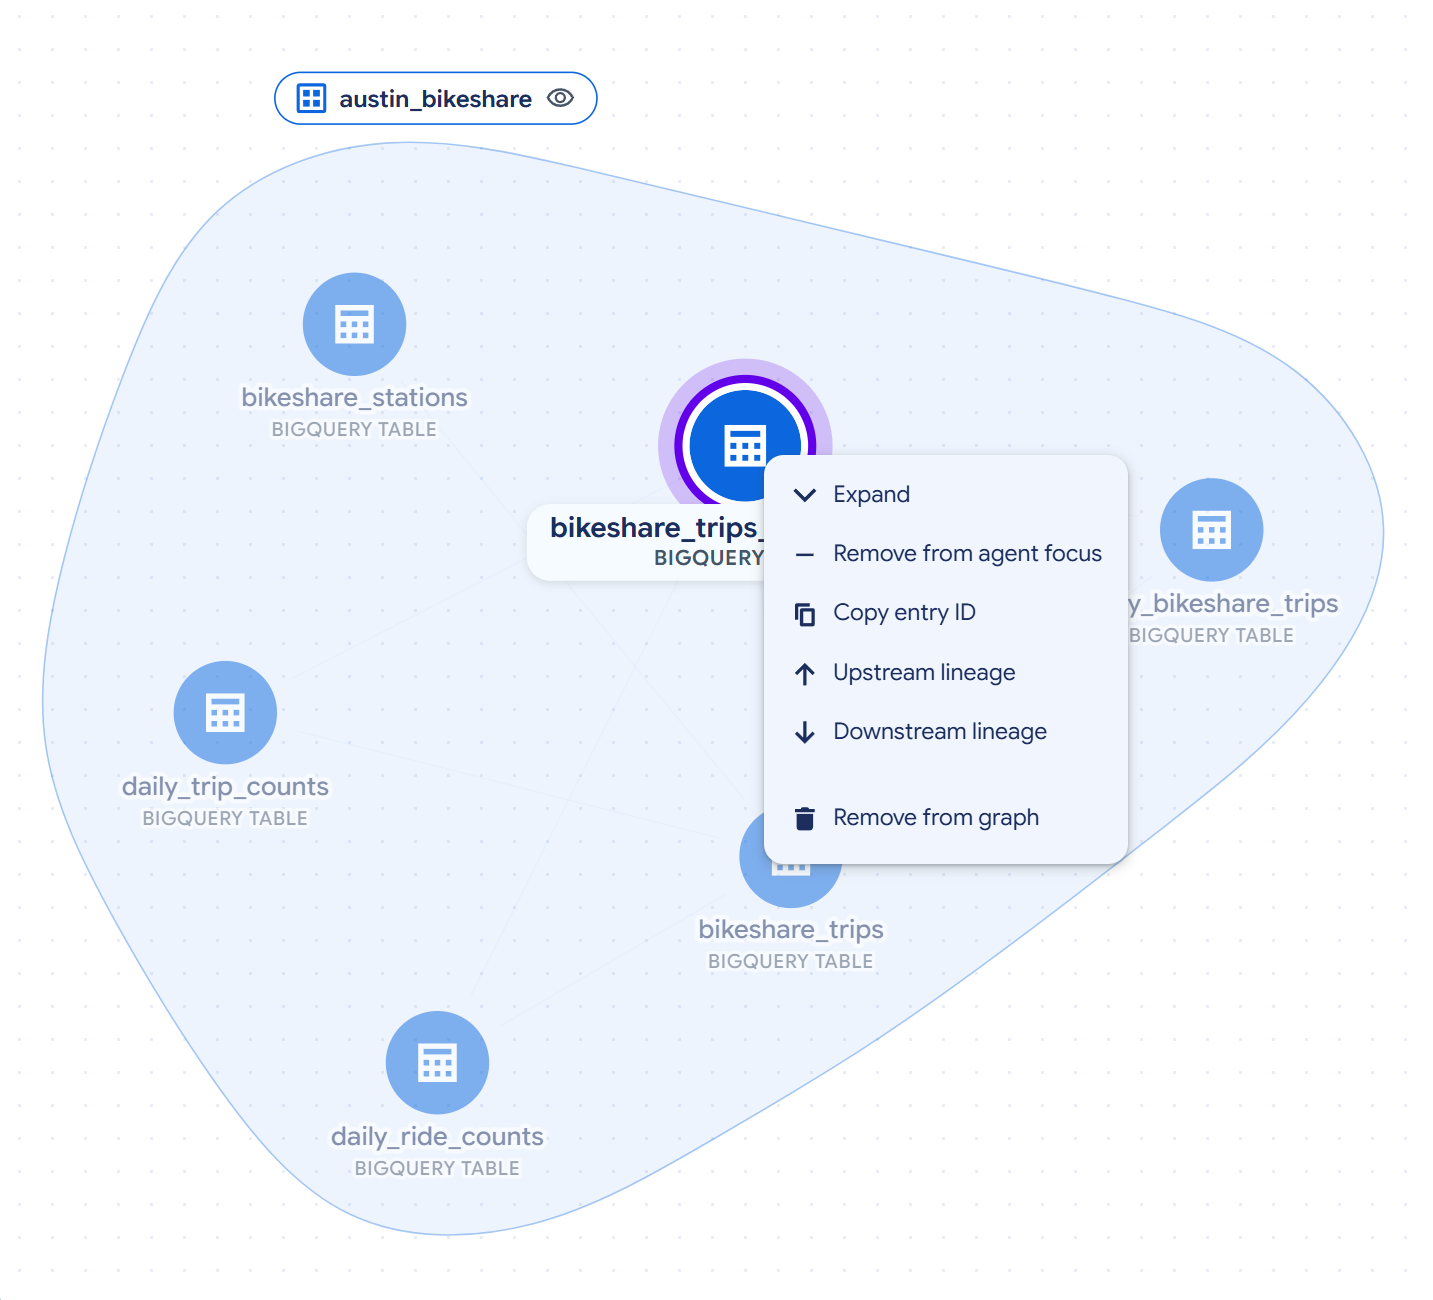
Abbildung 5. Das Kontextmenü eines Knotens. (Zum Vergrößern auf das Bild klicken) - Maximieren: Ruft die direkten Nachbarverbindungen nach Beziehungstyp ab und zeigt sie an.
- Aus KI-Agenten-Fokus entfernen: Der Knoten wird aus dem Arbeitssatz ausgeschlossen, den Sie und der KI-Agent untersuchen.
- Eintrags-ID kopieren: Kopiert die eindeutige Kennung für das Asset.
- Upstream-Datenherkunft: Verfolgt und erweitert die Datenherkunft, die in den Knoten fließt.
- Nachgelagerte Herkunft: Verfolgt und erweitert die Datenherkunft, die vom Knoten ausgeht.
- Aus Grafik entfernen: Entfernt den Knoten aus dem aktiven Canvas.
Beziehungen maximieren: Wenn Sie alle Beziehungen gleichzeitig maximieren möchten (um alle verbundenen Tabellen, Ansichten und Glossarbegriffe anzuzeigen), doppelklicken Sie auf den Knoten. Der Knoten zeigt ein Minimierungssymbol (
-) an, das darauf hinweist, dass seine Verbindungen maximiert sind. Doppelklicken Sie noch einmal auf den Knoten, um die Beziehungen zu minimieren.
Aktiven Kontext abfragen und erweitern
Der von Gemini unterstützte Chat behält den Kontext der Unterhaltung über mehrere Prompts hinweg bei. Da der aktive Kontextgraph im Arbeitsspeicher gehalten wird, können Sie Folgefragen stellen, den Graphen erweitern oder Abfragen generieren, ohne frühere Details wiederholen zu müssen.
Fragen zu Assets im Kontext stellen
Wenn Sie nach Assets fragen, die sich bereits im Canvas befinden, prüft der KI-Agent den Kontextgraphen im Arbeitsspeicher direkt, ohne die Erkennungstools noch einmal aufzurufen.
So stellen Sie eine Frage zu einem Asset auf Ihrem Canvas:
Geben Sie im Prompt-Feld eine Frage zu verbundenen Geschäftsbegriffen oder Metadaten für ein Asset auf Ihrem Canvas ein und klicken Sie dann auf Senden. Beispiel:
Are there any glossaries connected to TABLE_NAME?Ersetzen Sie TABLE_NAME durch den Namen einer Tabelle oder eines Daten-Assets, die bzw. das in Ihren Kontextgraphen geladen wurde (z. B.
customers).Der KI-Agent prüft den aktiven Kontextgraphen im Arbeitsspeicher und gibt eine Zusammenfassung der verbundenen Begriffe aus dem Unternehmensglossar und der Spaltenbeziehungen zurück, ohne den Katalog noch einmal abzufragen.
Optional: Wenn Sie Fragen mit externem Wissen beantworten möchten, geben Sie in Ihrem Prompt einen Link zu einem externen Google-Dokument an. Der Agent kann die Dokumentinhalte lesen und dieses externe Wissen verwenden, um Ihre Fragen zu beantworten.
Semantischen Graphen durchlaufen und erweitern
Wenn Sie nach neuen oder tieferen Beziehungen über den aktiven Graphen hinaus fragen, wechselt der Agent dynamisch seine Toolstrategie, um Verbindungen wie Schema-Joins, Glossardefinitionen oder benutzerdefinierte semantische Dokumentation zu finden.
So verfolgen Sie Beziehungen von einem Geschäftskonzept oder einer Entität nach außen:
Geben Sie im Prompt-Feld eine Anfrage ein, um Beziehungen nach außen zu verfolgen, und klicken Sie dann auf Senden. Beispiel:
Show how my data is connected to GLOSSARY_TERMErsetzen Sie GLOSSARY_TERM durch den Namen eines Unternehmensglossarbegriffs in Ihrem Katalog (z. B.
Customer Value).Der Agent durchläuft die Kanten des semantischen Graphen, z. B. abfragebasierte
schema-join-Links,definition-Links für Glossare oderpackagesfür Datenprodukte, und fügt die neu gefundenen Tabellen dem Canvas hinzu. Die Grafik wird auf den neu erkundeten Glossarknoten zentriert, die semantischen Links werden gerendert und der Zähler für Aktive Knoten wird aktualisiert.
SQL generieren und Verteilungen prüfen
Während Sie Assets in der Chat-Oberfläche untersuchen, können Sie mit der BigQuery-Konversationsanalyse direkt in Ihren Daten detaillierte Analysen durchführen.
So generieren Sie eine Abfrage und prüfen Datenverteilungen mit dem aktiven Kontext:
Bitten Sie den KI-Agenten im Prompt-Feld, eine Abfrage mit den sichtbaren Knoten zu schreiben, und klicken Sie dann auf Senden. Beispiel:
Generate a query to calculate average customer balance by region
using the active tables.
Der Agent verwendet den aktiven Kontextgraphen als Fundierung, um kontextbezogenes SQL mit verifizierten Join-Schlüsseln (z. B.
customer_idundregion_id) zu generieren.Optional: Wenn Sie Datenverteilungen auswerten möchten, bitten Sie den KI-Agenten um statistische Zusammenfassungen.
Der KI-Agent kann Abfragen ausführen und Inline-Diagramme zur Datenverteilung im Chatfenster rendern, damit Sie die Datenverteilungen bewerten können, bevor Sie benutzerdefinierten Code schreiben.
Chatprotokoll verwalten
Knowledge Studio speichert Ihre explorativen Datenanalysesitzungen automatisch. Sie können frühere Chats direkt im Navigationsbereich suchen, fortsetzen oder löschen.
So rufen Sie Ihren Chatverlauf auf oder verwalten ihn:
- Achten Sie darauf, dass im Navigationsbereich von Knowledge Studio der Abschnitt Zuletzt verwendet maximiert ist.
- Wenn Sie eine bestimmte frühere Unterhaltung finden möchten, geben Sie im Feld Chats suchen Suchbegriffe ein, die sich auf die vorherigen Fragen oder den Kontext des Chats beziehen.
- Wenn Sie eine Explorationssitzung fortsetzen möchten, klicken Sie in der Liste auf den Namen des Chats. Dadurch wird der vorherige Chat-Thread wiederhergestellt.
- Wenn Sie eine frühere Unterhaltung löschen möchten, bewegen Sie den Mauszeiger auf den Chatnamen in der Liste und klicken Sie dann auf das Symbol Löschen.
Nächste Schritte
Kontext mit Knowledge Studio anreichern
Hier erfahren Sie, wie Sie umfangreichen Datenkontext orchestrieren, Kontextsets erstellen und KI-Agenten mithilfe von Knowledge Studio-Schnittstellen fundieren.
Datenkontext
Erfahren Sie, wie aktiver Kontext passive Metadaten transformiert, um KI-Agenten zu fundieren und Halluzinationen zu vermeiden.
Statistiken für strukturierte Daten generieren
Abfragelogs auswerten, um automatisch Spaltenbeschreibungen, Tabellenzusammenfassungen und empfohlene Joins zu generieren.
Nach Ressourcen suchen
Katalogressourcen in Google Cloud und Drittanbietersystemen mit natürlicher Sprache finden und untersuchen.
Anreicherungsaufgaben
Hier erfahren Sie, wie Sie KI-gestützte Workflows zur Metadatenextraktion konfigurieren, um automatisch Datenkontext zu erstellen.
KI-Agenten mit MCP fundieren
KI-Agenten und Entwicklertools über das Model Context Protocol mit Knowledge Catalog verbinden