


このドキュメントでは、Knowledge Studio を使用して、関連するデータアセットを検出してチャットする方法、それらのデータアセットがどのように接続されているかを視覚的に探索する方法、自然言語を使用してデータアセットに関する回答を見つける方法について説明します。Knowledge Studio は、会話型チャット インターフェースとインタラクティブなコンテキスト グラフを組み合わせて、データ環境全体を直感的に探索してナビゲートできるようにします。
このドキュメントは、自然言語を使用してエンタープライズ メタデータをクエリし、コンテキスト グラフでデータアセットの関係を視覚的にナビゲートするデータ アナリスト、ビジネス アナリスト、データ スチュワードを対象としています。
データ探索の仕組み
新しいチャット インターフェースには、インタラクティブなデータ検出のための次の機能が用意されています。
自然言語インターフェース: データ資産について英語で質問します(例: 「ヨーロッパのお客様のチャーン指標を含むテーブルはどれですか?」)。
Gemini を活用したチャット: Gemini を活用したエージェントは、自然言語の質問を解析し、Knowledge Catalog に対して検索ツールとメタデータ検索ツールを実行し、マルチステップの探索計画を策定して、折りたたみ可能な思考トレースで進行状況を表示します。
コンテキスト グラフ ビジュアライザー: データセット、テーブル、クエリ、ビジネス用語の関係をインタラクティブに操作できます。ビジュアル グラフには、探索セッションの作業コンテキスト セットを構成するアクティブなノードとエントリリンクが表示されます。ノードをクリックして、詳細な列スキーマを検査したり、アクティブなノードドロワーのリストを確認したり、アセットタイプでグラフをフィルタしたりします。
BigQuery コーディング支援の実行: 生成された SQL クエリをデータ探索インターフェースからデータ ウェアハウスに対して直接実行して、データ関係を検証します。
コンテキスト グラフは、セマンティックなビジネス関係、用語集の定義、検証済みの結合パスを可視化します。これは、運用 ETL パイプライン実行ビューアではありません。パイプライン変換ステップ、ランタイム ジョブ、運用データフロー(Dataflow パイプラインなど)を検査するには、Knowledge Catalog のデータリネージを表示します。詳細については、データリネージを使用するをご覧ください。
始める前に
-
In the Google Cloud console, on the project selector page, select or create a Google Cloud project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
-
If you're using an existing project for this guide, verify that you have the permissions required to complete this guide. If you created a new project, then you already have the required permissions.
-
Verify that billing is enabled for your Google Cloud project.
- データアセットが存在することを確認します。Knowledge Catalog は、手動構成を必要とせずに、コア Google Cloud サービスから構造メタデータと運用メタデータを自動的に取り込みます。独自のナレッジベース、サードパーティのガバナンス ツール、オンプレミス システムを使用している組織向けに、Knowledge Catalog は柔軟な取り込みメカニズムを提供します。
- 省略可: ビジネス用語集と用語(ビジネス KPI の定義など)が Knowledge Catalog で構成され、基盤となるデータアセットにリンクされていることを確認します。詳細については、ビジネス用語集を管理するをご覧ください。
- 必要な API を有効にします。
コア探索に必要なもの:
- Dataplex API(
dataplex.googleapis.com): Knowledge Studio を開き、カタログを検索し、コンテキスト グラフと用語集を探索するために必要です。
機能ごとに必要(プロジェクトで有効):
- BigQuery API(
bigquery.googleapis.com): BigQuery データセットとテーブルの閲覧、クエリジョブの検査、SQL クエリの実行。 - Data Lineage API(
datalineage.googleapis.com): アップストリームとダウンストリームのデータリネージを閲覧し、リネージ プロセスを検査します。 - Gemini Data Analytics API(
geminidataanalytics.googleapis.com): BigQuery の会話型分析を使用し、データ分布の分析情報を生成します。 - Google Documents API(
docs.googleapis.com): チャット プロンプトにリンクされている Google ドキュメントを読み取るため。
- Dataplex API(
必要なロール
Knowledge Studio でデータアセットとコンテキスト グラフを探索するために必要な権限を取得するには、プロジェクトに対する次の IAM ロールを付与するよう管理者に依頼してください。
-
コアカタログ検索とコンテキスト グラフの探索:
- Dataplex Catalog 閲覧者 (
roles/dataplex.catalogViewer) - Service Usage コンシューマー (
roles/serviceusage.serviceUsageConsumer)
- Dataplex Catalog 閲覧者 (
-
BigQuery メタデータの閲覧と SQL クエリの実行:
- BigQuery メタデータ閲覧者 (
roles/bigquery.metadataViewer) - BigQuery データ閲覧者 (
roles/bigquery.dataViewer) - BigQuery ジョブユーザー (
roles/bigquery.jobUser)
- BigQuery メタデータ閲覧者 (
-
BigQuery の会話型分析を使用する:
- Gemini for Google Cloud データ エージェント ステートレス ユーザー (
roles/geminidataanalytics.dataAgentStatelessUser) - BigQuery データ閲覧者 (
roles/bigquery.dataViewer) - BigQuery ジョブユーザー (
roles/bigquery.jobUser)
- Gemini for Google Cloud データ エージェント ステートレス ユーザー (
-
データリネージの閲覧:
- データリネージ閲覧者 (
roles/datalineage.viewer) - BigQuery リソース閲覧者 (
roles/bigquery.resourceViewer)
- データリネージ閲覧者 (
ロールの付与については、プロジェクト、フォルダ、組織へのアクセス権の管理をご覧ください。
必要な権限は、カスタムロールや他の事前定義ロールから取得することもできます。
ユーザー アカウントにロールを付与する
プロジェクトで Identity and Access Management(IAM)アクセスを管理するために必要な権限がある場合は、これらのロールを独自のユーザー アカウントに付与できます。ロールを付与するには、gcloud projects add-iam-policy-binding コマンドを使用します。
後述のコマンドデータを使用する前に、次のように置き換えます。
- PROJECT_ID: 実際の Google Cloud プロジェクト ID。
- USER_EMAIL: ユーザー アカウントのメールアドレス(例:
name@example.com)。
次のコマンドを実行します。
Linux、macOS、Cloud Shell
gcloud projects add-iam-policy-binding PROJECT_ID \
    --member="user:USER_EMAIL" \
    --role="roles/dataplex.catalogViewer"

gcloud projects add-iam-policy-binding PROJECT_ID \
    --member="user:USER_EMAIL" \
    --role="roles/serviceusage.serviceUsageConsumer"

gcloud projects add-iam-policy-binding PROJECT_ID \
    --member="user:USER_EMAIL" \
    --role="roles/bigquery.metadataViewer"

gcloud projects add-iam-policy-binding PROJECT_ID \
    --member="user:USER_EMAIL" \
    --role="roles/bigquery.dataViewer"

gcloud projects add-iam-policy-binding PROJECT_ID \
    --member="user:USER_EMAIL" \
    --role="roles/bigquery.jobUser"

gcloud projects add-iam-policy-binding PROJECT_ID \
    --member="user:USER_EMAIL" \
    --role="roles/geminidataanalytics.dataAgentStatelessUser"

gcloud projects add-iam-policy-binding PROJECT_ID \
    --member="user:USER_EMAIL" \
    --role="roles/datalineage.viewer"

gcloud projects add-iam-policy-binding PROJECT_ID \
    --member="user:USER_EMAIL" \
    --role="roles/bigquery.resourceViewer"
Windows(PowerShell)
gcloud projects add-iam-policy-binding PROJECT_ID `
    --member="user:USER_EMAIL" `
    --role="roles/dataplex.catalogViewer"

gcloud projects add-iam-policy-binding PROJECT_ID `
    --member="user:USER_EMAIL" `
    --role="roles/serviceusage.serviceUsageConsumer"

gcloud projects add-iam-policy-binding PROJECT_ID `
    --member="user:USER_EMAIL" `
    --role="roles/bigquery.metadataViewer"

gcloud projects add-iam-policy-binding PROJECT_ID `
    --member="user:USER_EMAIL" `
    --role="roles/bigquery.dataViewer"

gcloud projects add-iam-policy-binding PROJECT_ID `
    --member="user:USER_EMAIL" `
    --role="roles/bigquery.jobUser"

gcloud projects add-iam-policy-binding PROJECT_ID `
    --member="user:USER_EMAIL" `
    --role="roles/geminidataanalytics.dataAgentStatelessUser"

gcloud projects add-iam-policy-binding PROJECT_ID `
    --member="user:USER_EMAIL" `
    --role="roles/datalineage.viewer"

gcloud projects add-iam-policy-binding PROJECT_ID `
    --member="user:USER_EMAIL" `
    --role="roles/bigquery.resourceViewer"
Windows(cmd.exe)
gcloud projects add-iam-policy-binding PROJECT_ID ^
    --member="user:USER_EMAIL" ^
    --role="roles/dataplex.catalogViewer"

gcloud projects add-iam-policy-binding PROJECT_ID ^
    --member="user:USER_EMAIL" ^
    --role="roles/serviceusage.serviceUsageConsumer"

gcloud projects add-iam-policy-binding PROJECT_ID ^
    --member="user:USER_EMAIL" ^
    --role="roles/bigquery.metadataViewer"

gcloud projects add-iam-policy-binding PROJECT_ID ^
    --member="user:USER_EMAIL" ^
    --role="roles/bigquery.dataViewer"

gcloud projects add-iam-policy-binding PROJECT_ID ^
    --member="user:USER_EMAIL" ^
    --role="roles/bigquery.jobUser"

gcloud projects add-iam-policy-binding PROJECT_ID ^
    --member="user:USER_EMAIL" ^
    --role="roles/geminidataanalytics.dataAgentStatelessUser"

gcloud projects add-iam-policy-binding PROJECT_ID ^
    --member="user:USER_EMAIL" ^
    --role="roles/datalineage.viewer"

gcloud projects add-iam-policy-binding PROJECT_ID ^
    --member="user:USER_EMAIL" ^
    --role="roles/bigquery.resourceViewer"
これらのコマンドは、Cloud Shell または Google Cloud CLI がインストールされ、初期化されているローカル ターミナルで実行できます。
データ探索インターフェースを開く
Google Cloud コンソールで、[Knowledge Studio(プレビュー)] に移動します。
インターフェースには、次のインターフェース要素が表示されます。
サイドバー: 新しい探索セッション(新しいチャット)を開始したり、以前のチャット セッションを検索したり、[新しいチャット]、[コンテキスト セット]、[エンリッチメント] のインターフェースを切り替えたりできます。
会話型チャット ウィンドウ: モデル セレクタとスターター プロンプト チップ(Knowledge Catalog にはどのようなデータがありますか?など)を含む中央のプロンプト フィールドがあります。
グラフパネルを表示 アイコン: [コンテキスト グラフ] パネルを開くか閉じます。
自然言語を使用してデータアセットを検出する
データアセットを検索するには、[新しいチャット] インターフェースのプロンプト フィールドに質問を入力するか、スターター プロンプト チップのいずれか([Knowledge Catalog にはどのようなデータがありますか?] など)をクリックします。
Gemini はリクエストを分析し、内部検出ツールを実行して、構造化された結果をチャットパネルに表示します。
クエリに応じて、エージェントからのチャット レスポンスには次のものが含まれます。
- 一致するアセットの展開ツール: 検出されたデータアセットのインタラクティブなカードの概要が、タイプ(テーブルや用語集など)別にグループ化されて表示されます。
- テキストの要約: 検出されたコア データセット、テーブル、用語集について説明します。
- フォローアップ ガイダンス: エージェントは、特定のドメインの探索やテーブル スキーマの検査など、次のステップを提案します。

図 1. 一致するアセット、データセットの概要、フォローアップ ガイダンスを表示するチャット レスポンス。(画像をクリックすると拡大します) 省略可: エージェントの推論ステップと内部ツール呼び出しを検査するには、チャット レスポンスの [思考] セクションを開きます。このセクションでは、エージェントの多段階検索戦略について説明します。これには、広範な検出クエリからターゲットを絞ったアセット フィルタへの移行方法も含まれます。次のリストは、エージェントがリクエストに応答するために実行する内部オペレーションの一部を示しています。
カタログ検索: キーワードとセマンティック マッチング(
type=datasetやtype=context-setによるフィルタリングなど)を使用して、正確なプロジェクト制約で Knowledge Catalog をクエリします。基盤となるメカニズムの詳細については、データアセットを検索するをご覧ください。メタデータの取得: 一致したエントリのスキーマ、説明、リネージを取得します。BigQuery テーブルの場合、リンクされたビジネス用語集と構造的に関連するテーブルも取得します。基盤となる API の詳細については、データアセットのコンテキストを取得するをご覧ください。
UI レンダリング: 取得したメタデータをチャットパネルのインタラクティブ カードとしてフォーマットします。
検索スコープと推論を構成する
Gemini が最も正確な回答を提供し、回答を待つ時間を最小限に抑えるには、チャット プロンプト ボックスの下にあるプルダウン コントロールを使用して、エージェントのターゲット環境と推論の複雑さを制限します。
データ探索の範囲: エージェントの内部検索オペレーションを 1 つ以上の特定の Google Cloud プロジェクトに制限します。
このオプションは、Knowledge Catalog のフットプリントが大きく、ターゲット データアセットを含むプロジェクトが正確にわかっている場合に選択します。プロジェクトでフィルタすると、検出が大幅に高速化され、エージェントがテスト環境やステージング環境からハルシネーションを生成したり、類似した名前のテーブルを返したりするのを防ぐことができます。データの場所が不明な場合は、[すべてのプロジェクト] のままにします。
思考レベル: エージェントがプロンプトについて推論する深さを制御します。これにより、クエリの可能性をどの程度網羅的に評価し、検索結果を反復処理してから回答するかが決まります。
このオプションは、レスポンス速度と検索の徹底性のバランスを取る必要がある場合に選択します。* アセット名がわかっている場合に、高速、直接、簡単なキーワード検索を行うには、[低] を選択します。* エージェントが 1 つまたは 2 つのフォローアップ クエリを実行する必要がある可能性がある、一般的な探索ワークフローの場合は、Medium を選択します。 * エージェントが多段階の検索戦略を実行し、初期結果を評価し、最終的な回答を返す前にクエリを洗練する必要がある、複雑、曖昧、または不明瞭な質問の場合は、Highを選択します。
専門的な分析エージェントを実行する
デフォルトでは、Gemini を活用したチャットでは、クエリが構造メタデータと記述カタログに制限されます。質問に詳細なデータ分析や実際のテーブルデータに対するクエリの実行が必要な場合は、チャット プロンプトに特定のメンションを直接追加して、専用の分析エージェントを呼び出すことができます。
次のリストに、サポートされている分析エージェントとその機能を示します。
@BqJobs: BigQuery クエリジョブ エージェントを呼び出します。これを含めると、Gemini を活用したチャットに、テーブルに対して SQL ステートメントを直接実行する権限が付与されます。このメンションは、エージェントがメタデータを確認するだけでなく、データをクエリして質問に回答するようにする場合に使用します。Google ドキュメントのリンク: Google ドキュメントのリンクをチャットに貼り付けると、エージェントはドキュメントの内容を読み取ることができます。リンクされたドキュメントに対する Google ドライブの閲覧者アクセス権があり、プロジェクトで Google Drive API が有効になっている必要があります。
@BqCA: BigQuery 会話型分析エージェントを呼び出します。これを含めると、分析に関する質問(トレンド、集計、複雑なビジネス インテリジェンス ワークフローなど)が、テーブル コンテキストとともに、高度なマルチステップ SQL 推論を実行できる高度に専門化されたサブエージェントに転送されます。
これらのサブエージェントの機能、必要な権限、料金の詳細については、BigQuery の会話分析をご覧ください。
セマンティック関係を可視化する
コンテキスト グラフは、技術的なストレージ リソースと、論理的なビジネス セマンティクスとの関係を表示できるインタラクティブなキャンバスとして機能します。
データ接続を調べる
グラフ キャンバスでセマンティック関係を積極的に探索して拡張するには、まずグラフを読み込む必要があります。
チャットの結果から初期コンテキスト グラフを読み込むには、[一致するアセット] タイルのエントリカードをクリックします。[コンテキスト グラフ] パネルには、そのデータアセットと接続されたエンティティのインタラクティブなトポロジグラフが表示されます。
たとえば、コンテキスト グラフがビジネス ロジックをデータ ストレージにマッピングする方法を理解するには、図 2 に示す szelwico_curated_retail_analytics グラフを考えてみましょう。

このグラフは、小売ガソリン スタンド ネットワークとコンビニエンス ストアのレポートと分析データ ウェアハウスとして機能します。
このグラフは、技術データアセットとビジネスルールを 1 つのビューに統合します。
- コア ファクト テーブル: 青色の BigQuery ノードは、1 日の燃料販売量(
fact_daily_station_fuel_sales)やポイント プログラムのパフォーマンス(fact_loyalty_promo_attribution)などのトランザクション データを表します。 - ディメンション テーブル: 追加の青色のノードは、ステーション(
dim_stations_enriched)や顧客フリート(dim_customers_and_fleets)などの拡充されたディメンション テーブルを表します。 - 管理されたビジネス ロジック: 黄色のノードは、データの厳格な計算ルールを定義する用語集の用語を表します。たとえば、Friday Golden Pump 20% Discount ノードは、ロイヤリティ メンバーの割引後の正味料金の計算方法を定義します。
- 関係: ノード間の線は、テーブルがどのように結合されるかを示します。たとえば、ステーション ディメンション テーブルが日次燃料販売ファクト テーブルにどのように結合されるかを示します。
コンテキスト グラフ キャンバス
コンテキスト グラフ キャンバスには、データ トポロジを探索するのに役立つ次の主要な UI 領域が用意されています。
- キャンバス ヘッダー: 上部のヘッダー メニューには、アクティブなノード数とコンテキスト セットのタイトルが表示されます。また、レイアウトとレンダリングのオプションも表示されます。
- エントリの検索フィールド: [名前、データセット、説明でエントリを検索] フィールドにキーワードを入力して検索し、新しいデータアセットをキャンバス レイアウトに直接手動で追加します。
- 全画面表示アイコン: アイコンを使用すると、キャンバスのビューポートを画面全体に拡大できます。
- グラフの表示オプション: [その他のオプション]()アイコンをクリックして、レンダリングを管理するメニューを開きます。次の切り替えボタンがあります。
- フォーカス ノードのみ: 周囲の接続を非表示にして、コンテキスト内のノードのみをハイライト表示します。
- エッジを表示: すべてのエッジ関係線の表示を切り替えて、密なグラフを整理し、高速化します。
- コンテナをハイライト表示する: ノードが配置されているデータセットや用語集などの構造化データベース グループを強調表示します。
- エクスプローラを表示: ノードリストのサイドバー エクスプローラの表示 / 非表示を切り替えます。
- グラフの凡例を開く: グラフの視覚的な語彙の定義を表示します。
- グラフフィルタ: [グラフ コントロール]()アイコンをクリックして [フィルタ] パネルを開きます。このパネルでは、接続をフィルタリングしてグラフの密度を制御できます。次のフィルタ カテゴリが用意されています。
- タイプ: エンティティ タイプ(テーブルとビュー、用語集の用語、データ プロダクト、コンテキストなど)でノードをフィルタします。
- 関係: ノードを接続する色付きのエッジを、関係タイプ(スキーマ結合、関連、定義、コンテキスト、パッケージなど)でフィルタします。
- リネージ: データリネージ エッジの可視性を制御します。これには、アップストリーム(ノードに流入するリネージ)とダウンストリーム(ノードから流出するリネージ)の切り替えが含まれます。
- 分離されたノード: [すべて] のノードを表示するか、接続されていないノードを [非表示] にするか、分離されたノード [のみ] を表示するかを選択します。
- ホップの深さ: キャンバス上のアンカーノードを選択して距離を測定し、数値距離(1、2、3、すべてなど)を選択して、アンカーから離れたノードを除外します。
- キャンバスのズーム コントロール: キャンバスの左下には、ビューポートのレンダリングを管理するためのビュー コントロールがあります。
- ズーム コントロール: ズームイン()ボタンとズームアウト()ボタンを使用して、グラフを拡大または縮小します。
- 画面に合わせる: アイコンを使用して、グラフのレイアウトをビューポート内に収まるようにサイズ変更します。
グラフの視覚要素を理解する
コンテキスト グラフでは、特定の色、アイコン、エッジスタイルを使用して、さまざまなタイプのデータアセットとその関係を表します。グラフの視覚的な語彙の定義を表示するには、[その他のオプション]()アイコンをクリックして、[グラフの凡例を開く] を選択します。
ノードの状態
ノードには、キャンバス上の現在の状態を示すバッジが表示されます。
- 選択済み: 検査中のエントリ。グラフの残りの部分は暗くなり、接続が目立つようになります。
- エージェントのフォーカス: フォーカスの一部。ユーザーとエージェントが探索しているワーキング セット。
- 展開中: システムが、このエントリに関連するエントリ(リネージ、結合、用語集の用語など)を読み込み、グラフに追加していることを示します。
データソースの色分け
ノードの色は、基盤となるデータソースまたはエンティティ タイプを示します。
- 青: BigQuery(テーブル、ビュー、データセット)。
- ティール: Lakehouse(カタログ、名前空間、テーブル、ビュー)。
- 黄色: 用語集、カタログ、Knowledge Catalog(用語集、用語、カタログ)。
- 茶色: データベースまたはストレージ(Spanner、AlloyDB、Cloud Storage)。
- ピンク: dbt(モデル、セマンティック モデル、テスト、マクロ、エクスポージャー)。
- オレンジ: データ プロダクト。
- 赤: コンテキスト(コンテキスト セット)。
- 緑: Looker(LookML プロジェクト、モデル、Explore、ビュー)。
- グレー: カスタム アセット(カスタム エントリ グループとサポートされていないエントリタイプ)。
関係エッジ
ノードを接続する線は、意味的な関係を表します。これらのエッジは、[フィルタ] パネルを使用してフィルタできます(データ接続を調べるを参照)。
- スキーマ結合: 検証済みのマルチテーブル結合パス、主キー、外部キーをマッピングする青色のエッジ。
- 定義: 基盤となるテーブル列を、認定されたビジネス用語集の用語と KPI 式に直接接続するオレンジ色のエッジ。
- コンテキスト: ターゲット データアセットに特殊なコンテキストを関連付けるグレーのエッジ。
- パッケージ: 特定のデータ プロダクトにバンドルされているデータアセットを示すグレーのエッジ。
コンテキスト グラフにエントリを手動で追加する
チャット コマンドのみに頼るのではなく、キャンバス インターフェースから直接、特定のデータアセットをコンテキスト グラフに手動でシードできます。これは、接続して可視化するリソースがすでにわかっている場合に便利です。
特定のアセットを検索してグラフに追加するには、次の操作を行います。
- エントリを検索するには、キャンバス ヘッダーにある [名前、データセット、または説明でエントリを検索] フィールドをクリックします。
- 省略可: ターゲット プロジェクトを変更するには、[プロジェクト] プルダウン メニューで Google Cloud プロジェクトを選択します(デフォルトでは、[すべてのプロジェクト] に設定されています)。
- キーワード、データセット名、エントリの説明を入力します。
- キャンバスにノードを配置するには、一致する検索結果のプルダウン リストから必要なエントリをクリックします。グラフが更新され、新しいノードが表示されます。また、既存のセマンティック関係や構造関係が自動的にマッピングされます。

特定のノードの接続を調べる
メタデータの詳細を表示したり、関係を開いたり、アクティブなキャンバス上の個々のノードに対して追加のアクションにアクセスしたりするには、さまざまなマウスクリックを使用してノードを直接操作します。
特定のノードを操作するには、次のいずれかの方法を使用します。
メタデータを表示する: 選択したアセットの詳細なメタデータ(接続されたノードなど)を表示するサイドパネルを開くには、ノードを 1 回クリックします。
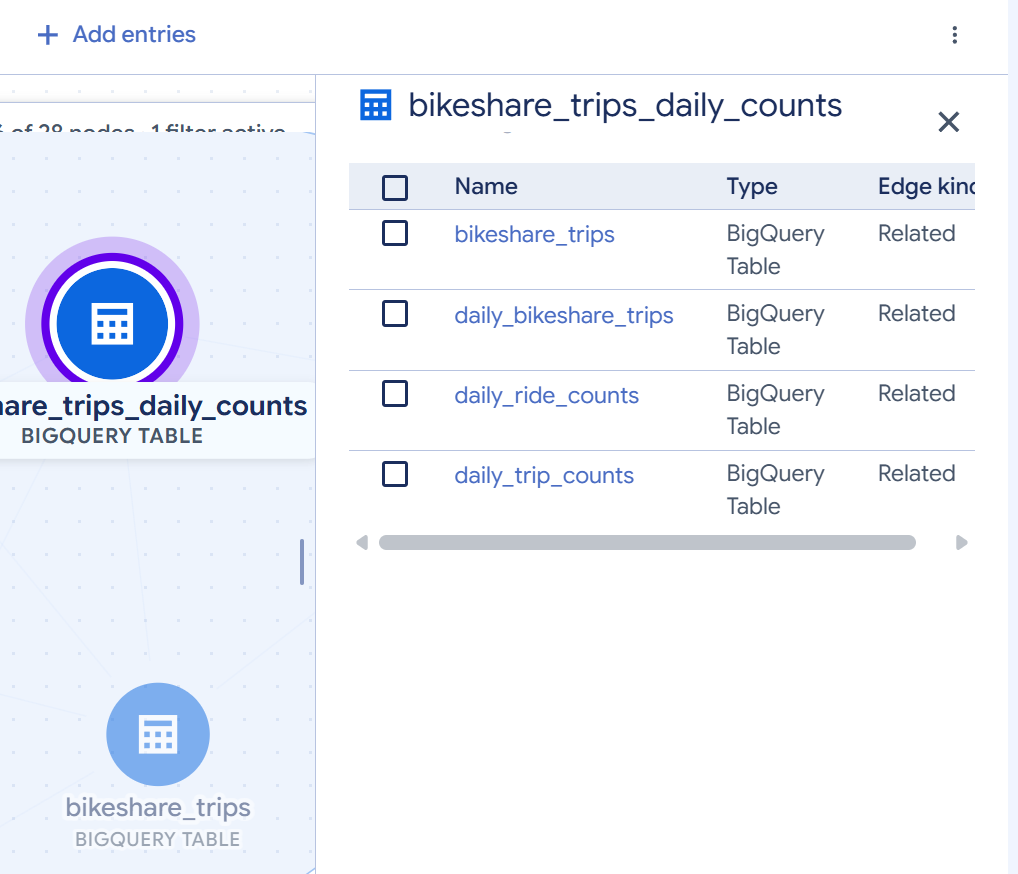
図 4. ノードのメタデータの詳細サイドパネル。(画像をクリックすると拡大します) その他のオプションを開く: リネージのトレースやノードの削除などの追加のアクションにアクセスするには、ノードを右クリックしてコンテキスト メニューを開きます。このメニューから、次の操作を選択できます。
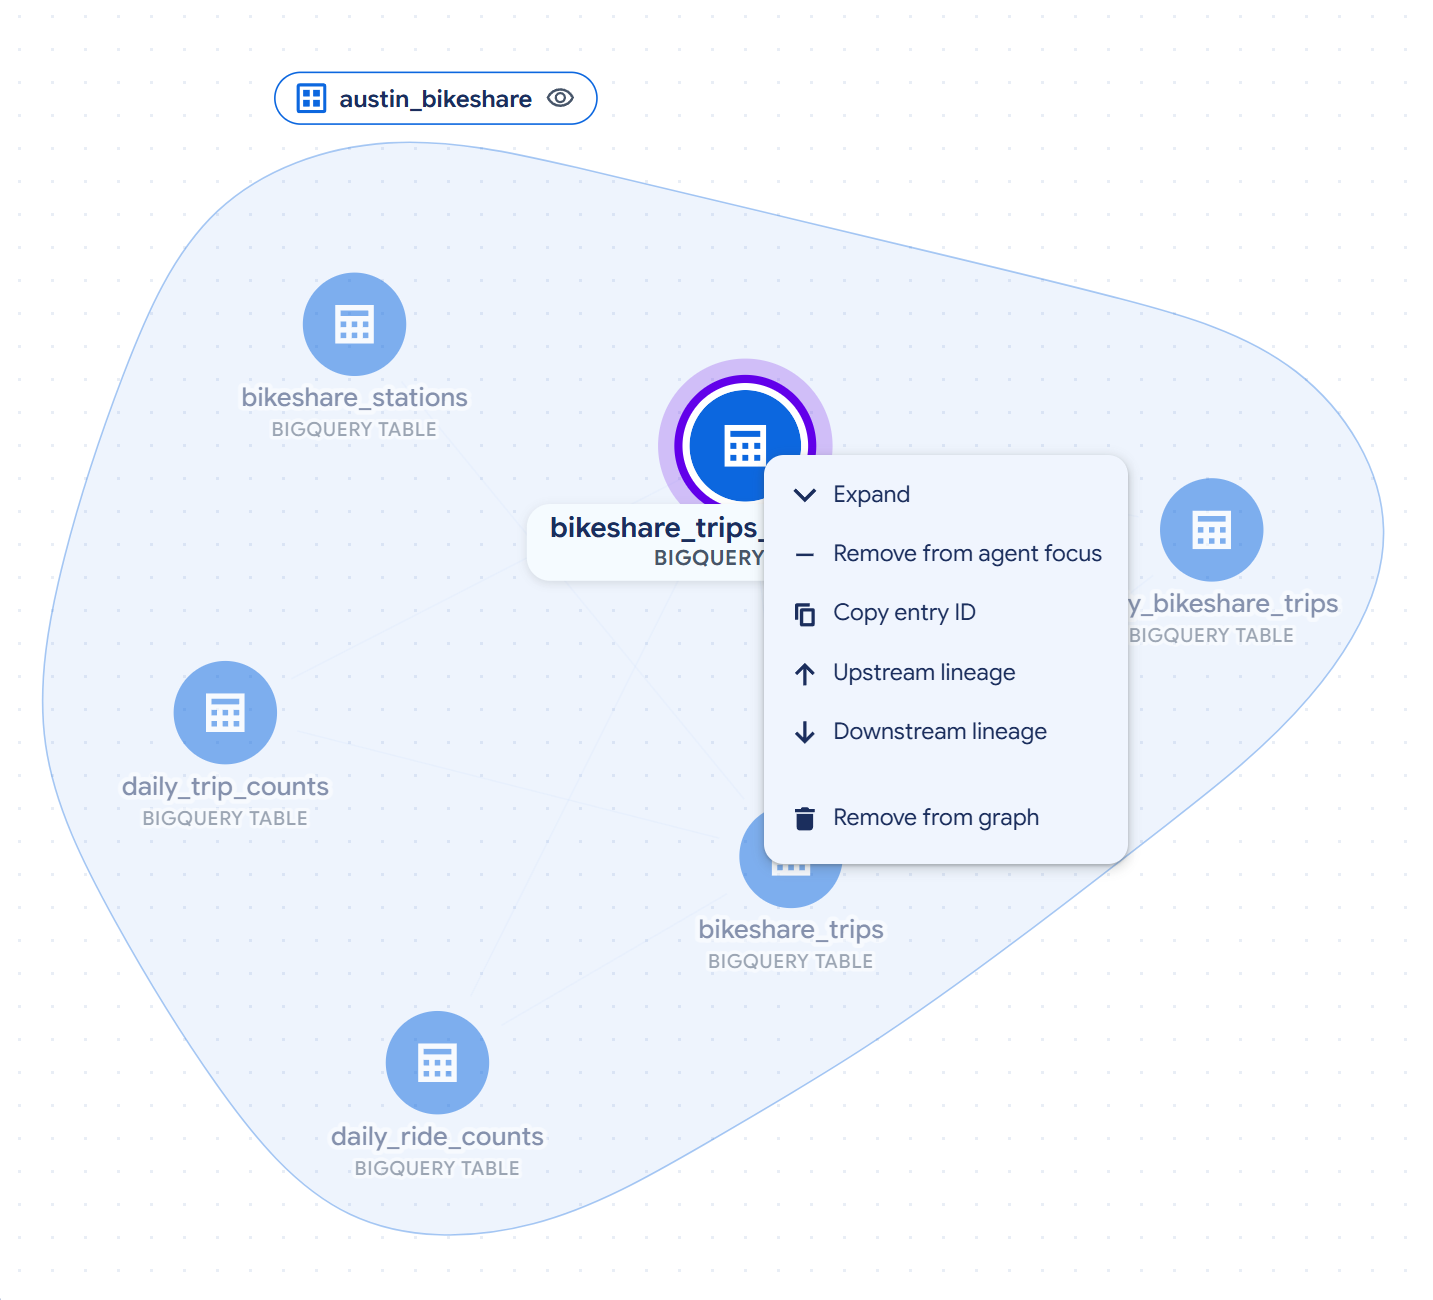
図 5. ノードのコンテキスト メニュー。(画像をクリックすると拡大します )- 展開: 関係タイプ別に、直接の隣接接続を取得して表示します。
- エージェントのフォーカスから削除: あなたとエージェントが探索しているワーキング セットからノードを除外します。
- エントリ ID をコピー: アセットの固有識別子をコピーします。
- アップストリーム リネージ: ノードに流入するデータリネージをトレースして展開します。
- ダウンストリーム リネージ: ノードから流出するデータリネージをトレースして展開します。
- グラフから削除: アクティブなキャンバスからノードを削除します。
関係を開く: すべての関係を一度に開く(接続されているすべてのテーブル、ビュー、用語集の用語を表示する)には、ノードをダブルクリックします。ノードには、接続が展開されていることを示す折りたたみバッジ(
-)が表示されます。関係を折りたたむには、ノードをもう一度ダブルクリックします。
アクティブなコンテキストをクエリして拡張する
Gemini を活用したチャットでは、プロンプト間で会話のコンテキストが維持されます。アクティブなコンテキスト グラフはワーキング メモリに保持されるため、以前の詳細を繰り返すことなく、フォローアップの質問、グラフの外側への拡張、クエリの生成を行うことができます。
コンテキスト内のアセットについて質問する
キャンバスにすでに存在するアセットについて質問すると、エージェントは検出ツールを再度呼び出すことなく、メモリ内のコンテキスト グラフを直接検査します。
キャンバス上のアセットについて質問するには、次の操作を行います。
プロンプト フィールドに、キャンバス上のアセットに関連するビジネス用語またはメタデータに関する質問を入力し、 [送信] をクリックします。次に例を示します。
Are there any glossaries connected to TABLE_NAME?TABLE_NAME は、コンテキスト グラフに読み込まれたテーブルまたはデータアセットの名前(
customersなど)に置き換えます。エージェントは、メモリ内のアクティブなコンテキスト グラフを検査し、カタログを再クエリすることなく、接続されたビジネス用語集の用語と列の関係の会話の要約を返します。
省略可: 外部の知識を使用して質問に回答するには、プロンプトに外部の Google ドキュメントへのリンクを指定します。エージェントはドキュメントの内容を読み取り、その外部知識を使用して質問に回答できます。
セマンティック グラフを走査して展開する
アクティブなグラフ以外の新しい関係やより深い関係を探索するようにリクエストすると、エージェントはツール戦略を動的に切り替えて、スキーマ結合、用語集の定義、カスタム セマンティック ドキュメントなどの接続を検出します。
ビジネス コンセプトまたはエンティティから外側に向かって関係をトレースするには、次の操作を行います。
プロンプト フィールドに、関係を外向きにトレースするリクエストを入力し、 [送信] をクリックします。次に例を示します。
Show how my data is connected to GLOSSARY_TERMGLOSSARY_TERM は、カタログ内のビジネス用語集の用語の名前に置き換えます(例:
Customer Value)。エージェントは、クエリベースの
schema-joinリンク、用語集のdefinitionリンク、データ プロダクトのpackagesなどのセマンティック グラフのエッジを走査し、新しく検出されたテーブルをキャンバスに追加します。グラフは、新しく探索された用語集ノードを中心に配置し、そのセマンティック リンクをレンダリングして、[アクティブ ノード] カウンタを更新します。
SQL を生成して分布を検査する
チャット インターフェースでアセットを探索しながら、インラインの BigQuery 会話分析を使用して、データに対して直接詳細な分析を行うことができます。
アクティブなコンテキストを使用してクエリを生成し、データ分布を検査するには、次の操作を行います。
[プロンプト] フィールドで、表示されているノードを使用してクエリを作成するようエージェントに指示し、 [送信] をクリックします。次に例を示します。
Generate a query to calculate average customer balance by region
using the active tables.
エージェントは、アクティブなコンテキスト グラフをグラウンディングとして使用し、検証済みの結合キー(
customer_idやregion_idなど)を含むコンテキスト対応の SQL を生成します。省略可: データ分布を評価するには、エージェントに統計サマリーをリクエストします。
エージェントは、クエリを実行し、チャット ウィンドウ内にインライン データ分布グラフをレンダリングして、カスタムコードを記述する前にデータ分布を評価できるようにします。
チャットの履歴を管理する
Knowledge Studio では、データ探索セッションが自動的に保存されるため、ナビゲーション パネルから直接、以前のチャットを検索、再開、削除できます。
チャット履歴を表示または管理する手順は次のとおりです。
- Knowledge Studio のナビゲーション パネルで、[最近] セクションが開いていることを確認します。
- 過去の特定の会話を見つけるには、[チャットを検索] フィールドに、チャットの以前の質問またはコンテキストに関連するキーワードを入力します。
- 探索セッションを再開するには、リスト内のチャットの名前をクリックします。これにより、以前のチャット スレッドが復元されます。
- 過去の会話を削除するには、リスト内のチャット名にカーソルを合わせ、 [削除] アイコンをクリックします。
次のステップ
Knowledge Studio でコンテキストを拡充する
Knowledge Studio インターフェースを使用して、リッチデータ コンテキストをオーケストレートし、コンテキスト セットを構築して、AI エージェントをグラウンディングする方法を学びます。
MCP を使用してエージェントをグラウンディングする
Model Context Protocol を使用して、AI エージェントとデベロッパー ツールを Knowledge Catalog に接続します。