


Mit Knowledge Catalog können Sie technische Metadaten und Geschäftssemantik für strukturierte und unstrukturierte Daten mithilfe von Gemini-basierten Funktionen vereinheitlichen. Anschließend können Sie den resultierenden Kontextgraphen verwenden, um Assets zu finden, die Datenqualität zu prüfen und generative KI-Anwendungen zu fundieren, um Halluzinationen zu reduzieren.
Dieses Dokument richtet sich an Data und Context Engineers, Data Scientists, Data Stewards und KI-Entwickler. Es wird davon ausgegangen, dass Sie mit Datenbank- und Speichersystemen wie BigQuery oder Cloud Storage vertraut sind und ein grundlegendes Verständnis von Konzepten der generativen KI wie Retrieval Augmented Generation (RAG) oder Model Context Protocol (MCP) haben.
Eine detaillierte Anleitung zu Knowledge Catalog finden Sie im folgenden Video:
Branchenspezifische Datenkomplexität bewältigen
In modernen Unternehmen sind Daten komplex, stark verteilt und liegen sowohl in strukturierten als auch in unstrukturierten Formaten vor. Geschäftsanfragen lassen sich selten einem einzelnen Datenbankschema oder Dokumentenspeicher zuordnen. Diese Silos sicher aufeinander abzustimmen und gleichzeitig sofortige, zuverlässige Antworten auf domänenübergreifende Fragen zu liefern, ist eine große operative Herausforderung.
Knowledge Catalog fungiert als semantische Grundlage, die diese Lücke schließt, und ermöglicht es KI-Agenten und Analysetools, fundierten, relevanten Kontext abzurufen.
Wichtige Nutzerrollen
Context Engineers (Data Engineers): Automatisieren Sie die Metadatenaggregation über Datenbanken und Cloud Storage hinweg, verfolgen Sie Transformationen mit Herkunft und erstellen Sie Workflows für die Anreicherung und Bewertung.
Data Stewards (Governance-Teams): Sie können die Qualität der Metadaten überwachen, indem Sie KI-generierte Beschreibungen durch Human in the Loop-Überprüfungen optimieren, Geschäftsvokabulare mit Glossaren standardisieren und benutzerdefinierte Aspekte definieren, um Katalogeinträgen domänenspezifischen Kontext hinzuzufügen.
KI-Entwickler. Fundieren Sie LLMs und KI-Anwendungen mit vertrauenswürdigen Unternehmensdatenschemas mithilfe von MCP-Servern oder Context Retrieval APIs.
Einsatzfelder nach Branchen
In der folgenden Tabelle werden die komplexen Fragen, die in der Praxis auftreten, die technischen Grenzen, die sie überschreiten, und die Unterstützung von Knowledge Catalog für Unternehmen beschrieben:
| Branche | Datenbezogene und betriebliche Herausforderungen | Zu lösendes Geschäftsproblem | Wie Knowledge Catalog das Problem löst |
|---|---|---|---|
| E-Commerce |
|
„Suche nach Elektronikprodukten mit hohen Rückgaberaten und Kundenfotos, die Anzeichen von Schäden bei der Lieferung zeigen.“ | Semantische Fundierung über Datenformate hinweg: Metadaten aus Transaktionsdatenbanken werden automatisch erkannt und mit unstrukturierten Bildern in Cloud Storage-Buckets verknüpft. So können KI-Tools die Abfrage über verschiedene Speichersysteme hinweg auflösen. |
| Produktion/Fertigung |
|
„Erstelle Zusammenfassungen für alle Inspektionsberichte zu Maschinen in der Region West, die im letzten Quartal die Sicherheitsprüfungen nicht bestanden haben.“ | Regionales und unstrukturiertes Crawling: Crawlt und katalogisiert unstrukturierte PDF-Prüfberichte zusammen mit Asset-Metadaten, sodass generative KI-Agenten Berichte nach Region finden, zusammenstellen und zusammenfassen können. |
| Gesundheitswesen |
|
„Welche Patienten haben das höchste Risiko für eine Wiederaufnahme innerhalb von 30 Tagen, wenn man die aktuellen Laborwerte und die Häufigkeit der Termine betrachtet?“ | Datenqualität und Data Lineage: Berechnet die Datenqualität auf Zeilenebene und erstellt Data Lineage-Karten für Feeds mit elektronischen Gesundheitsdaten. So wird sichergestellt, dass klinische Vorhersagemodelle nur auf verifizierten, hochwertigen Vitalparametern von Patienten basieren. |
| Finanzdienstleistungen |
|
„Welche der zehn umsatzstärksten Kunden haben sich über ‚Leistungsprobleme‘ beschwert und wie wirkt sich das auf die Prognosen für das dritte Quartal aus?“ | Einheitlicher Kontextgraphen: Vereinheitlicht Kundendatensätze, Supportfeedback und Finanztabellen, sodass Abfragen in natürlicher Sprache Umsatzstatistiken von Kunden mit unstrukturierten Feedbackdateien verknüpfen können, um finanzielle Auswirkungen zu prognostizieren. |
Um diese betrieblichen Herausforderungen zu bewältigen, bietet Knowledge Catalog wichtige Funktionen, mit denen Data Engineers, Data Scientists und KI-Entwickler regulierte Datensysteme erstellen können:
KI-Agenten mit dem Model Context Protocol (MCP) fundieren Metadaten, Schemas, Datenherkunft und Geschäftsregeln direkt für KI-Agenten über lokale oder Remote-MCP-Server verfügbar machen. Diese Server ermöglichen es Modellen, die betrieblichen Erwartungen zu prüfen, bevor sie Aktionen vorschlagen.
Suche nach KI und Analysen beschleunigen: Finden Sie relevante Daten-Assets mithilfe der semantischen Suche in natürlicher Sprache. Generative Zusammenfassungen und Empfehlungen helfen Nutzern, Daten zu finden, ohne auf manuelle Dokumentationsprüfungen warten zu müssen.
Datenprodukte im großen Maßstab verwalten Fassen Sie Asset-Sammlungen mit Service Level Agreements (SLAs), Verträgen, Inhaberschaftsdetails und Nutzungshinweisen in einzelnen, verwalteten Einheiten für die Suche und das Abo zusammen.
So funktioniert der Knowledge Catalog
Knowledge Catalog vereinheitlicht die Datenverwaltung und den Kontext über einen dreistufigen Lebenszyklus. Das folgende Diagramm veranschaulicht, wie der Dienst physische Daten-Assets der Geschäftssemantik für die Fundierung von KI-Agenten zuordnet:

Weitere Informationen zu diesen Metadatenkonzepten finden Sie unter Informationen zu Metadaten.
In den folgenden Abschnitten werden die drei Säulen des Metadaten-Lebenszyklus beschrieben und es wird veranschaulicht, wie ein Einzelhandelsunternehmen sie auf Datenbanktabellen, Dateien und externe Katalogeinträge anwendet:
Aggregation (Erkennung und Aufnahme). Knowledge Catalog crawlt und indexiert automatisch technische Metadaten in Ihrem Datenbestand, ohne die zugrunde liegenden Daten zu verschieben:
- Integrierte Datenbanken: Die automatisierte Katalogisierung erfasst Schemas und Attribute auf Plattformen wie BigQuery, AlloyDB for PostgreSQL und Spanner.
- Verwaltete Konnektivität. Sie können Definitionen aus externen Systemen wie Oracle oder PostgreSQL oder Partner-Registries wie Collibra aufnehmen, ohne benutzerdefinierte Pipelines schreiben zu müssen.
- Data Lineage. Verfolgen Sie Transformationen auf Spaltenebene über Pipelines hinweg, um zu sehen, woher Ihre Daten stammen und wie sie sich geändert haben.
- Beispiel: Ein Einzelhandelsunternehmen nimmt automatisch Metadaten aus Transaktionsdatenbanken auf, z. B. die Tabellen
ordersundorder_items, und indexiert unstrukturierte Produktdateien, die in Cloud Storage-Buckets gespeichert sind. Sie verknüpfen externe Datenbanken, um einen einheitlichen Metadatenindex in einem auffindbaren Verzeichnis zu erstellen.
Weitere Informationen zur Metadatenaggregation und Datenaufnahme (zum Maximieren klicken)
- Unterstützte Datenquellen: Hier werden alle unterstützten Google Cloud und externen Quellen für die automatisierte Aufnahme aufgeführt.
- Verwaltete Verbindungen – Übersicht: Hier wird erläutert, wie Sie technische Schemas aus externen Systemen aufnehmen.
- Datenherkunft verfolgen: Hier wird beschrieben, wie Sie Pipeline-Transformationen und den Datenfluss auf Spaltenebene visualisieren.
Anreicherung (Kontext kuratieren und Vertrauen verifizieren). Knowledge Catalog verknüpft technische Strukturen mit geschäftlicher Bedeutung und erstellt Vertrauenssignale:
- KI-generierte Insights: Gemini analysiert Abfragelogs, um Spaltenbeschreibungen, Tabellenzusammenfassungen und empfohlene Joins zu generieren.
- Glossare und Aspekte. Ordnen Sie interne Messwertnamen mithilfe von Geschäftsbegriffen und logischen Vorlagen einem gemeinsamen Vokabular zu.
- Datenqualität und Anomalieerkennung: Erzwingen Sie Sauberkeitsrichtlinien und führen Sie Scans mit maschinellem Lernen durch, um statistische Ausreißer oder Probleme mit der Datenaktualität zu erkennen und wichtige Vertrauenssignale zu generieren.
- Governance-Überprüfungen. Risiken minimieren, indem Sie mithilfe von Workflow-Überprüfungsprozessen Metadatenaktualisierungen vor der Veröffentlichung prüfen.
- Beispiel: Das Einzelhandelsteam reichert Assets an, indem es Dateneinblicke auslöst, um Spaltenbeschreibungen zu empfehlen, und Regeln für die Datenqualität ausführt. Sie ordnen Geschäftsdefinitionen aktiven Aufträgen zu, indem sie Glossare und Aspekte erstellen.
Weitere Informationen zur Metadatenanreicherung und Vertrauensprüfung (zum Maximieren klicken)
- Dateneinblicke konfigurieren: Hier wird erläutert, wie Sie automatisierte Dataset-Beschreibungen und ‑Zusammenfassungen generieren.
- Unternehmensglossare verwalten: Hier wird beschrieben, wie Sie Standardbegriffe und Unternehmensvokabulare anpassen.
- Metadaten mit Aspekten anreichern: Hier wird gezeigt, wie Sie logischen Assets strukturierte Metadatenattribute hinzufügen.
- Datenqualitätsregeln wiederverwenden: Hier erfahren Sie, wie Sie Datenbankvalidierungsregeln erstellen und wiederverwenden.
- Übersicht über die Datenprofilerstellung: Hier wird beschrieben, wie Sie Scans auf Schemaanomalien und statistische Abweichungen konfigurieren.
Suchen und Abrufen (Zugriff und Fundierung): KI-Anwendungen und geschäftliche Nutzer fragen das einheitliche Kontextdiagramm ab, um sicher auf Daten zuzugreifen:
- KI-Agenten fundieren Verbinden Sie Ihre LLM-basierten Anwendungen und KI-Agenten mit dem Katalog.
- Context API Anfragen für Fundierungsnutzlasten mit niedriger Latenz ausführen.
- Semantische Suche. Mit Abfragen in natürlicher Sprache die richtigen Assets finden.
- Datenpakete: Bündeln Sie Tabellensammlungen, Lizenzierungsdetails und SLAs in sicheren Self-Service-Datenpaketen.
- Beispiel: Analysten führen semantische Suchen in natürlicher Sprache durch, um Assets zu finden. KI-Anwendungen nutzen diesen Index sicher über MCP-Server oder die Context Retrieval API. Hochwertige Assets werden in einer sicheren Ansicht verpackt.
Weitere Informationen zum Abrufen von Kontext und zur Fundierung von Agenten (zum Maximieren klicken)
- Übersicht über das Model Context Protocol (MCP): Hier wird erläutert, wie Sie generative KI-Agenten und Anwendungsebenen mit dem Knowledge Catalog-Kontext verbinden.
- Kontext mit LookupContext abrufen: Hier wird gezeigt, wie Sie wichtige operative Nutzlasten für Agent-Prompts extrahieren.
- Nach Assets suchen: Beschreibt die Funktionen für die Asset-Suche mithilfe der semantischen Abfragesyntax in natürlicher Sprache.
Knowledge Catalog im KI-Ökosystem von Google Cloud
Wenn Sie eine Datengrundlage erstellen, ist es wichtig zu verstehen, wie Knowledge Catalog in zugehörige Dienste eingebunden wird.
Google Cloud Datenbanken und Modelle
- BigQuery. Knowledge Catalog crawlt und indexiert BigQuery-Datasets, -Tabellen und -Ansichten automatisch. Es löst Gemini-basierte Dateneinblicke aus, um Abfrageverläufe zu analysieren, Beschreibungen zu veröffentlichen und verifizierte Beispielabfragen vorzuschlagen.
- Looker (Google Cloud Core). Knowledge Catalog nimmt Looker-Dashboards, Looks und LookML-Strukturen wie Ansichten, Explores, Dimensionen und Messwerte auf. Bei dieser Aufnahme werden Herkunftszuordnungen erstellt, um nachzuvollziehen, wie operative Werte Geschäftssemantiken zugeordnet werden.
- Lakehouse-Laufzeitkatalog. Knowledge Catalog ist in den Lakehouse-Laufzeitkatalog eingebunden, den Laufzeit-Metastore für Open-Source-Iceberg-Arbeitslasten. Technische Metadaten werden automatisch über Lakehouse-Laufzeitkatalog-Arbeitslasten indexiert, um einen einheitlichen aktiven Kontext bereitzustellen.
Plattformen und Assistenten für KI-Agenten
- Konversationsanalyse: Analyseschnittstellen verwenden Katalogbegriffe und Suchtools, damit Nutzer Geschäftsmesswerte in natürlicher Sprache mit verifizierter Fundierung abfragen können.
- Gemini für KI-Agenten: Hochpräzise KI-Agenten verwenden Katalogmetadaten, um Datenbankabfragen auszuführen, was Halluzinationen reduziert.
- Gemini Enterprise Agent Platform: Knowledge Catalog dient als zentraler Data-Governance-Standard in Zielplattformumgebungen. Sie ist mit der Gemini Enterprise Agent Platform verknüpft, um Tools und Kontext in die Agent Registry der Plattform einzuspeisen.
Google Cloud Datenbank- und KI-Dienstintegration
Knowledge Catalog bildet zusammen mit anderenGoogle Cloud -Produkten die Grundlage für Ihre Daten. In der folgenden Tabelle wird gezeigt, wie Knowledge Catalog in verwandte Dienste eingebunden wird und diese ergänzt:
| Dienst | Primäre Rolle | Einbindung in Knowledge Catalog |
|---|---|---|
| Knowledge Catalog | Governance und Kontext für KI-Agenten | Dient als einheitlicher semantischer Kontextgraph, führt Scans zur Datenqualitätsprüfung aus und stellt KI-Modellen und Anwendungen fundierte Schemas zur Verfügung. |
| BigQuery | Data-Warehouse-Prozesse für Unternehmen | Speichert, fragt ab und verarbeitet Datasets; crawlt, indexiert und reichert diese Tabellen automatisch mit geschäftlichen Klassifizierungsaspekten an. |
| Gemini Enterprise Agent Platform | Entwicklung von KI-Modellen | Erstellt, stellt bereit und hostet Foundation Models. Benutzerdefinierte KI-Agenten rufen Metadatenkontext ab, um logische Schlussfolgerungen zu fundieren. |
| Cloud Storage | Speicherung unstrukturierter Dateien | Speichert unstrukturierte Rohdateien und führt automatisch unstrukturierte Erkennungsscans aus, um PDFs und Bilder zu parsen und Beziehungszuordnungen zu erstellen. |
Semantik und Datenformate
Damit agentische Systeme effektiv angewiesen und fundiert werden können, müssen Sie zwischen der physischen Datenstruktur und der semantischen Bedeutung unterscheiden:
- Semantik: Die geschäftliche Bedeutung, die Absicht und die Beziehungen, die mit Ihren Daten verbunden sind. Während technische Schemas strukturelle Speicherspezifikationen wie Datenbanktyp, Zeichenlänge oder Ganzzahlbeschränkung definieren, beschreibt die Semantik, was das Dataset tatsächlich darstellt. Sie können beispielsweise eine Spalte mit dem Namen
txn_qtyder Geschäftsdefinition „Kaufmenge“ zuordnen. - Strukturierte Daten: Informationen, die in definierten Schemas und relationalen Formaten gespeichert sind. Beispiele hierfür sind BigQuery-Tabellen, Spanner-Datenbanken und operative Postgres-Tabellen. Knowledge Catalog crawlt diese Metadaten automatisch und zeichnet Spalten und Einschränkungen auf.
Kontextorchestrierung in der Agentischen Daten-Cloud
Im Rahmen der Agentischen Daten-Cloud von Google dient Knowledge Catalog als semantische Orchestrierungsebene. Anstatt dass Entwickler Datenbankschemas und Regeln manuell in Prompts hartcodieren müssen, stellt die Kontext-Engine dynamisch den genauen semantischen Kontext bereit, den ein Agent benötigt, um intelligente Entscheidungen zu treffen.
Die folgende Abbildung zeigt, wie Knowledge Catalog Datenkontext orchestriert und bereitstellt:
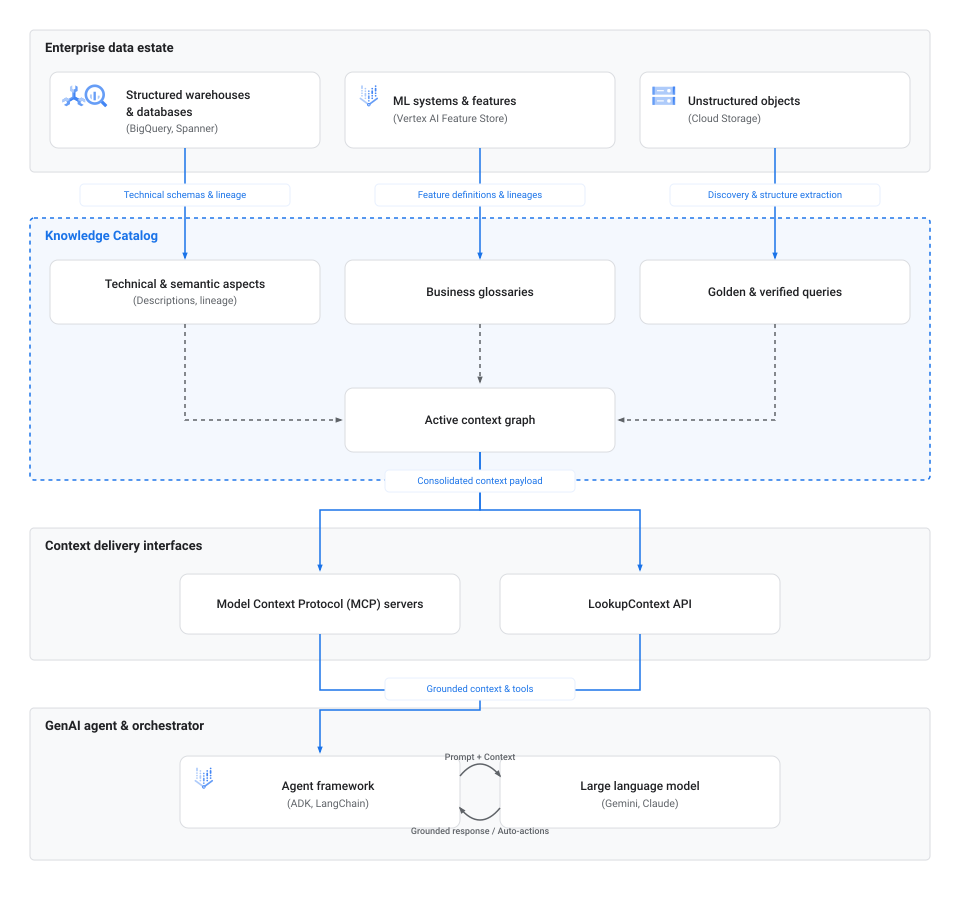
Der Workflow für die Kontextorchestrierung besteht aus den folgenden Phasen:
- Aufnahme und Auffindbarkeit Operative Datenbanken, Warehouses wie Spanner und BigQuery, unstrukturierte Objektspeicher wie Cloud Storage und Laufzeit-Metastores wie der Lakehouse-Laufzeitkatalog speisen technische Schemas, Herkunftskarten und Metadatendefinitionen direkt in Knowledge Catalog ein.
- Kontextzuordnung: Im Knowledge Catalog werden diese Metadatenattribute mit semantischen Elementen verknüpft, darunter technische Aspekte, Unternehmensglossare und verifizierte Abfragen, um den aktiven Kontextgraphen zu erstellen.
- Bereitstellungsschnittstellen: KI-Anwendungen und Orchestratoren rufen diesen konsolidierten Kontextgraphen programmatisch über Standard-Connectors wie MCP oder direkte
LookupContext-API-Endpunkte ab. - Agentenfundierung: Orchestrierungs-Frameworks wie das Agent Development Kit (ADK) oder LangChain fügen diesen Metadatenkontext direkt in LLM-Prompts ein. Durch diese Injektion wird die Argumentation des KI-Agenten auf verifizierte Organisationsregeln gestützt, sodass er Datenbanken abfragen oder automatisierte Aktionen ohne Halluzinationen ausführen kann.
KI-Agentenprofile
Je nachdem, welche Workflows Sie automatisieren möchten, können Sie verschiedene Klassen von KI-Agenten erstellen, die auf dem Knowledge Catalog basieren:
- Data Discovery-Agenten. Diese Assistenten helfen Nutzern, den Datenbestand zu durchsuchen und darin zu navigieren. Anstatt Keyword-Matching zu verwenden, analysieren sie die Absicht und Einschränkungen in natürlicher Sprache, um die relevantesten physischen Assets abzurufen.
- Agenten zur Metadatenanreicherung: Diese Hintergrund-Agents nehmen unstrukturierten Text aus Wikis, README-Dateien oder Chatprotokollen auf, parsen den Text in formale Metadaten und schreiben die Metadaten als Aspekte in Knowledge Catalog, um die Metadaten auf dem neuesten Stand zu halten.
- Datenqualität und Pipeline-Agents Diese autonomen Agenten werten Qualitätsregeln aus, erkennen Schemaabweichungen und erstellen oder reparieren Datentransformationspipelines, indem sie die Datenherkunft und Profilstatistiken abfragen.
Orchestrierungstools
Zum Erstellen und Einbinden dieser KI-Agenten können Sie die folgenden Tools verwenden:
- Model Context Protocol (MCP): Ein standardisiertes, offenes Protokoll zum Verknüpfen von KI-Agenten mit externen Ressourcen. Sie können Agenten so konfigurieren, dass sie entweder über den Remote-MCP-Server oder die lokale MCP-Toolbox eine Verbindung zum Katalog herstellen. Weitere Informationen finden Sie unter Model Context Protocol (MCP) in Knowledge Catalog.
- Agent Development Kit (ADK): Ein Framework von Google, das das Erstellen, Ausführen und Testen von generativen KI-Agenten vereinfacht und integrierte Bindungen an die Catalog Service API bietet. Weitere Informationen findest du auf der ADK-Startseite.
- LookupContext API Ein REST- und gRPC-API-Endpunkt, der eine einheitliche YAML- oder JSON-Kontextnutzlast für Daten-Assets extrahiert, die direkt in LLM-Prompts eingefügt werden kann. Weitere Informationen finden Sie unter Kontext mit der LookupContext API abrufen.
Kontextzugriff mit MCP
Das Model Context Protocol (MCP) ist eine standardisierte Brücke, mit der KI-Agenten und ‑Tools nahtlos mit Datenquellen wie dem Knowledge Catalog verbunden werden können. In der folgenden Vergleichstabelle finden Sie die beste Option für Ihre Integration:
| Implementierung | Optimal für | Wichtige Details | Endpunkt oder Einrichtung |
|---|---|---|---|
| Remote-MCP-Server | Cloud-First-Bereitstellungen, serverlose Umgebungen wie Cloud Run und verwaltete externe Dienste. | Von Google gehosteter Endpunkt, für den keine lokale Serververwaltung erforderlich ist. | Endpunkt: https://dataplex.googleapis.com/mcpInformationen zur Einrichtung finden Sie unter Remote-MCP-Server verwenden. |
| Lokale MCP-Toolbox | Lokale Agentenentwicklung, schnelles Prototyping und Desktop-IDE-Integrationen wie VS Code oder Cursor. | Befehlszeilentool, das als lokaler Proxy zwischen Ihrer Arbeitsbereichsumgebung und dem Knowledge Catalog fungiert. | Erfordert die Installation einer Binärdatei und .mcp.json-Einstellungen.Informationen zur Einrichtung finden Sie unter Lokalen MCP-Server verwenden. |
Best Practices für agentischen Datenkontext
Beachten Sie die folgenden Best Practices, um zuverlässige agentische Umgebungen zu erstellen, wenn Sie Metadaten in Knowledge Catalog organisieren und abfragen:
- Aspekte hinzufügen KI-Agenten können offizielle Produktionstabellen und temporäre Sandbox-Mockups nicht allein anhand des Namens unterscheiden. Definieren Sie einen benutzerdefinierten Aspekt für Vertrauenssignale und wenden Sie ihn an, um autoritative Datenprodukte zu zertifizieren. So können Sie dafür sorgen, dass KI-Agenten Abfragen an diese Ressourcen priorisieren oder einschränken.
- Suchvorgänge mithilfe von Kontextbudgets optimieren Geben Sie beim Aufrufen der
LookupContextAPI den Parametercontext_budgetan. Die API optimiert und passt zuerst die wichtigsten Metadaten wie Herkunft und primäre Beschreibungen innerhalb der von Ihnen angegebenen Token-Einschränkungen an. - Stellen Sie weitere Informationen bereit, um Join-Pfade offenzulegen. Listen Sie in Ihren Kontextanfragen bis zu 10 zugehörige Tabellen oder Assets auf. Wenn Sie eine Gruppe von Assets bereitstellen, kann die Kontext-Engine Join-Pfade und Beziehungen automatisch ausfüllen. So kann der KI-Agent besser verstehen, wie Tabellen miteinander verknüpft sind.
- Semantische Glossare strukturieren Standardisieren Sie Begriffe und Abkürzungen in Unternehmensglossaren. Diese Standardisierung hilft Konversationstools, geschäftsspezifische Synonyme und Messwerte genau aufzulösen.
- Golden Queries veröffentlichen Sie können verifizierte Abfragen in natürlicher Sprache und die entsprechenden SQL-Äquivalente direkt an Knowledge Catalog-Einträge anhängen. Durch die Fundierung der Argumentation in diesen verifizierten Vorlagen verhindern Sie SQL-Konvertierungsfehler in Text-zu-SQL-Agents.
Upgrade von Dataplex Universal Catalog auf Knowledge Catalog
Dataplex Universal Catalog wurde zu Knowledge Catalog weiterentwickelt. Weitere Informationen zu dieser Umstellung finden Sie unter Upgrade von Dataplex Universal Catalog auf Knowledge Catalog.
Beschränkungen
Beachten Sie bei der Planung Ihrer Bereitstellung die folgenden Einschränkungen:
Unterstützte Integrationen. Knowledge Catalog unterstützt zwar wichtige Drittanbietersysteme, bestimmte automatisierte semantische Extraktionen sind jedoch möglicherweise auf integrierte Google Cloud -Dienste beschränkt.
Kontingentlimits Für das Abrufen von Kontext und das Extrahieren von Metadaten gelten die Standard-API-Kontingente von Google Cloud .
Sicherheitsperimeter Bevor Sie Ihre Ressourcen erstellen, müssen Sie manuell einen VPC Service Controls-Sicherheitsperimeter erstellen. Andernfalls sind Ihre Ressourcen nicht durch einen Perimeter geschützt. Weitere Informationen finden Sie unter VPC Service Controls mit Knowledge Catalog.
Nächste Schritte
Datenkontext
Erfahren Sie, wie aktiver Kontext passive Metadaten transformiert, um KI-Agenten zu fundieren und Halluzinationen zu vermeiden.
Grundlegenden Datenkontext herstellen
Unternehmensglossar erstellen, benutzerdefinierte Aspekttypen definieren und Assets in BigQuery anreichern.
KI-Agenten mit MCP fundieren
KI-Agenten und Entwicklertools über das Model Context Protocol mit Knowledge Catalog verbinden
Nach Ressourcen suchen
Katalogressourcen in Google Cloud und Drittanbietersystemen mit natürlicher Sprache finden und untersuchen.
Datenqualitätsscans automatisieren
Definieren Sie Validierungsregeln und überwachen Sie die Datenqualität in Tabellen mit automatisierten Qualitätsscans.
Interaktive Anwendungsfälle ansehen
Anhand von Beispielen aus der Praxis werden Lösungen für die Kontextanreicherung, die Datenherkunft und Agentic Workflows vorgestellt.