Auf dieser Seite werden die Dateitypen aufgeführt, die von Sensitive Data Protection gescannt werden können. Außerdem werden die Scanmodi beschrieben, die von Sensitive Data Protection zum Analysieren von Dateien verwendet werden.
Unterstützte Dateitypen bei Prüf- und De-Identifizierungsvorgängen
In der folgenden Tabelle sind die Dateitypen aufgeführt, die Sensitive Data Protection prüfen und transformieren (de-identifizieren) kann.
Sensitive Data Protection verwendet Dateiendungen und Medientypen (MIME-Typen), um die Typen der zu scannenden Dateien und die anzuwendenden Scanmodi zu identifizieren. Sensitive Data Protection scannt beispielsweise eine .txt-Datei im Nur-Text-Modus, auch wenn die Datei als CSV-Datei strukturiert ist, die normalerweise im strukturierten Parsing-Modus gescannt wird.
| Dateityp | Dateiendungen | Limits | Scanmodus | Transformationsunterstützung |
|---|---|---|---|---|
Apache Avro |
avro |
Avro-Beschränkungen | Strukturiertes Parsen | |
Comma- or tab-separated values | CSV, TSV | Strukturiertes Parsen | Identifizierung von Inhalt aufheben | |
PDF |
PDF-Limits | Intelligentes Parsen von Dokumenten | ||
Text |
asc, brf, c, c++, cc, cpp, cs, css, cxx, dart, eml, go, h, h++, hh, hpp, hs, htm, html, hxx, ini, java, js, json, jsonl, lhs, m, markdown, md, mkd, ml, mli, ocaml, php, pht, phtml, pl, pm, py, pyw, rb, rbw, rc, rs, scala, sh, shtm, shtml, sql, tex, text, txt, vcard, vcs, wml, xhtml, xml, xsd, xsl, yaml, yml |
Nur-Text | Identifizierung von Inhalt aufheben | |
Microsoft Word |
docm, docx, dotm, dotx |
Word-Beschränkungen | Intelligentes Parsen von Dokumenten | |
Microsoft Excel |
xlsm, xlsx, xltm, xltx |
Excel-Limits | Intelligentes Parsen von Dokumenten | |
Microsoft Powerpoint |
potm, potx, pptm, pptx |
PowerPoint-Limits | Intelligentes Parsen von Dokumenten | |
Image |
bmp, gif, jpe, jpeg, jpg, png, tif, tiff |
TIFF-Limits |
|
Bearbeitung für alle Bildtypen außer TIFF |
Binary |
Nicht erkannte Dateitypen und Bilder, die nicht mit optischer Zeichenerkennung (OCR), Bildinhaltserkennung oder Bildinhaltklassifizierung gescannt werden können. |
Binär |
Unterstützte Dateicluster bei Erkennungsvorgängen
Während der Erkennung organisiert Sensitive Data Protection die erkannten Dateien in Datei-Clustern. Diese Cluster sind Gruppen ähnlicher Dateitypen. In der folgenden Tabelle sind die unterstützten Dateicluster und Dateiendungen aufgeführt. Nicht alle erkannten Dateien können gescannt werden.
Dateien können zwischen Datei-Clustern verschoben werden, wenn Sensitive Data Protection Unterstützung für weitere Datei-Cluster hinzufügt. Wenn die Unterstützung für das Scannen erweitert wird, scannt der Erkennungsdienst möglicherweise Dateien, die zuvor nicht gescannt wurden. Die Abrechnung erfolgt wie unter Discovery-Preise beschrieben.
| Dateicluster | Dateiendungen | Limits | Scanmodus |
|---|---|---|---|
Text |
asc, eml, htm, html, ini, json, jsonL, log, markdown, md, mkd, plist, shtm, shtml, sql, tex, text, txt, vcard, vcs, xsd, xsl |
Nur-Text | |
Source Code |
bat, brf, c, c++, cc, cmd, cpp, cs, css, cxx, dart, go, h, hh, hpp, hs, hxx, java, js, lhs, m, ml, ocaml, php, phtm, phtml, pl, ps1, py, pyw, rb, rbw, rc, rs, scala, scpt, scr, script, sh, sql, vb, vbs, wml, xml, yaml, yml |
Nur-Text | |
Structured Data |
avro, csv, tsv, proto |
Strukturiertes Parsen für Avro-, CSV- und TSV-Dateien. Nur-Text-Parsing für proto-Dateien | |
Rich Documents |
doc, docm, docx, dotm, dotx, pdf, potm, potx, ppt, pptm, pptx, xls, xlsm, xlsx, xltm, xltx |
Unterstützte PDF-, Microsoft Word-, Excel- und PowerPoint-Dateien, die kleiner als 30 MiB sind, werden gescannt. | Intelligentes Parsen von Dokumenten |
Images |
bmp, gif, heic, ico, jpe, jpeg, jpg, pm, png, svg, tif, tiff, webp |
Unterstützte Bilder (bmp, gif, jpe, jpeg, jpg, png, tif und tiff), die kleiner als 4 MiB sind, werden mit OCR in Regionen gescannt, die das Scannen von Bildern unterstützen. Für TIFF-Bilder gelten die TIFF-Limits. |
|
Executables |
ac, air, apk, app, appimage, bas, bin, bms, class, cls, com, command, ctl, ctx, dca, ddf, dep, dll, dob, dox, dsr, dsx, dws, exe, frm, frx, gadget, ipa, mpk, oca, ocx, pag, pgx, pif, pyc, res, run, scb, tlb, vbd, vbg, vbl, vbp, vbr, vbw, vbz, vlx, wct, widget, workflow, wsf, x86, x86_64, xap, xbe, xlm |
Derzeit nicht gescannt | |
Archives |
7z, a, ace, afa, alz, apk, ar, arc, arj, ark, b1, b6z, ba, bh, cab, car, cdx, cfs, cpio, cpt, dar, dd, dgc, dmg, ear, esd, gca, genozip, gz, ha, hki, ice, ima, img, iso, jar, kgb, lha, lpaq#*, lzh, lzx, mou, pak, paq#*, paq6, paq7, paq8 und Varianten, partimg, pea, phar, pim, pit, qda, rar, rk, run, s7z, sda, sea, sen, sfx, shar, shk, sit, sitx, sqx, swm, tar, tar.bz2, tar.gz, tar.lz4, tar.lzma, tar.xz, tar.z, tgz, uc, uc0, uc2, uca, ucn, ue2, uha, ur2, war, wim, xar, xp3, yz1, zip, zipx, zoo, zpaq, zz |
Sensitive Data Protection scannt Dateien in Archiven mit den folgenden Dateiendungen: bz2, cpio, gz, jar, lz4, lzma, tar, tar.bz2, tar.gz, tar.lz4, tar.lzma, tar.xz, tar.z, xz, z, zip Der für jede Datei verwendete Scanmodus hängt vom Dateityp ab. |
|
Multimedia |
3g2, 3gp, 8svx, aa, aac, aax, act, aiff, alac, amr, amv, ape, asf, au, avi, awb, cda, drc, dss, dvf, f4a, f4b, f4p, f4v, flac, flv, gif, gifv, gsm, iklax, ivs, M2TS, m2v, m4a, m4b, m4p, m4p (mit DRM), m4v, mkv, mmf, mng, mogg, mov, movpkg, mp2, mp3, mp4, mpc, mpe, mpeg, mpg, mpv, msv, MTS, mxf, nmf, nsv, oga, ogg, ogv, opus, qt, ra, raw, rf64, rm, rmvb, roq, sln, svi, TS, tta, viv, vob, voc, vox, wav, webm, wma, wmv, wv, yuv |
Derzeit nicht gescannt | |
AI Models |
caffemodel, ckpt, coreml, dlc, ggjt, ggmf, ggml, gguf, h5, keras, llamafile, mar, mleap, nc, npy, npz, onnx, pb, pkl, prompt, pt, pt2, pte, pth, ptl, safetensors, surml, tflite, tfrecords |
Derzeit nicht gescannt | |
Unknown |
Alle anderen Dateien, die sich nicht in einem anderen Cluster befinden. | Dies sind Dateien, die keine Erweiterungen haben oder gängige, aber nicht standardmäßige Erweiterungen wie .dat, .1 oder .2 verwenden. | Derzeit nicht gescannt |
Nicht erkannte Dateitypen in Cloud Storage
Wenn eine Datei während eines Speicherscans nicht erkannt wird, wird sie vom System standardmäßig als Binärdatei gescannt. Es wird versucht, den Inhalt in UTF_8 zu konvertieren und dann als Nur-Text zu scannen.
Wenn eine Datei während eines Erkennungsscans nicht erkannt wird, wird sie vom System nicht gescannt.
Wenn Sie eine Sammlung von Dateien haben, die Sie überspringen möchten, weil Sensitive Data Protection sie nicht erkennt, können Sie mit CloudStorageOptions.file_set.regex_file_set.exclude_regex eine Ausschlussliste angeben.
Limits für gescannte Byte pro Datei
Im Allgemeinen können Sie die Anzahl der gescannten Byte pro Datei begrenzen. In derGoogle Cloud -Konsole können Sie dazu die Stichprobenerhebung aktivieren. In der Cloud Data Loss Prevention API legen Sie das Feld bytes_limit_per_file oder bytesLimitPerFilePercent fest.
Stichproben werden im OCR- und intelligenten Parsing-Modus nicht unterstützt. Das bedeutet, dass Sensitive Data Protection beim Scannen der folgenden Dateitypen im OCR- oder intelligenten Dokumentparsen-Modus alle Einstellungen ignoriert, die Sie zum Begrenzen der pro Datei gescannten Byte anwenden.
- Bild
- Microsoft Excel
- Microsoft PowerPoint
- Microsoft Word
Wenn Sie diese Dateien im Binärmodus scannen, gelten die Limits.
Scanmodi
Jeder Scanmodus bietet zusätzliche Standortdetails in den Prüfungsergebnissen.
Bei TIFF-Bildern enthält das Objekt ImageLocation auch ein pageNumber-Feld, das die Seite mit dem Ergebnis identifiziert. Die Seitennummerierung beginnt bei 0.
| Scanmodus | Hinweise | Zusätzliche anzugebende Standortdetails |
|---|---|---|
| Binär | Wenn eine Datei nicht wie jeder andere Typ geparst werden kann, wird sie in UTF_8 konvertiert und als Text gescannt. Das binäre Scannen wirkt sich auf die Erkennungsqualität aus. |
|
| Intelligentes Parsen von Dokumenten | Dokumente werden nach aus der Formatierung extrahiertem Text geparst. Eingebettete Bilder werden mithilfe von OCR in Regionen gescannt, die dieses unterstützen . Außerhalb dieser Regionen werden Bilder als Binärdateien gescannt. |
DocumentLocation |
| Extraktion von Metadaten | Für alle von Cloud Storage gescannten Dateien werden zusätzlich zum Inhalt der Datei |
MetadataLocation |
| Optische Zeichenerkennung (OCR) |
In Regionen, die das Scannen von Bildern unterstützen, verwendet Sensitive Data Protection OCR, um textbasierte infoTypes in Bildern zu finden. |
ImageLocation |
| Erkennung von Bildinhalten | In Regionen, die das Scannen von Bildern unterstützen, kann Sensitive Data Protection Bild-Pixel und ‑merkmale direkt analysieren, anstatt Text aus Bildern zu extrahieren. In diesem Scanmodus wird ein bestimmtes Element im Bild gesucht und ein Begrenzungsrahmen darum erstellt. Beispielsweise kann dieser Scanmodus eine Person oder einen Barcode an einer bestimmten Stelle in einem Bild erkennen. Sensitive Data Protection verwendet diesen Scanmodus für alle Objekt-infoTypes, die in der Inspektions- oder Redaktionskonfiguration angegeben sind. |
ImageLocation |
| Klassifizierung von Bildinhalten | In Regionen, die das Scannen von Bildern unterstützen, kann Sensitive Data Protection Bild-Pixel und ‑merkmale direkt analysieren, anstatt Text aus Bildern zu extrahieren. In diesem Scanmodus wird das gesamte Bild analysiert, um ein einzelnes Thema oder eine einzelne Kategorie zuzuweisen. Es wird ein Label oder eine Klassifizierung erstellt. Sensitive Data Protection verwendet diesen Scanmodus für alle infoType-Detektoren für Bildkontexte, die in der Inspektions- oder Maskierungskonfiguration angegeben sind. |
ImageLocation |
| Nur-Text | Keine weiteren Details | |
| Strukturiertes Parsen | Strukturelle Informationen werden verwendet, um Ergebnisse zu beeinflussen. In diesem Scanmodus verwendet Sensitive Data Protection die Headerinformationen als Kontext. Dabei wird eine zeilen- und spaltenübergreifende Analyse ausgeführt, um korrelierte Daten zu finden. Beispielsweise kann dieser Scanmodus eine Adresse identifizieren, deren Komponenten über mehrere Spalten in einer Zeile verteilt sind. Die Scanergebnisse enthalten strukturelle Informationen, z. B. die Zeile, die das Ergebnis enthält, und den Namen der Spalte. Ergebnisse überschreiten nicht die Zellengrenzen einer Tabelle. |
RecordLocation |
Strukturierte Dateien im strukturierten Parsing-Modus scannen
Wenn Sie eine strukturierte Datei wie eine Avro-, CSV- oder TSV-Datei scannen, versucht Sensitive Data Protection, die Datei im Scanmodus für strukturiertes Parsen zu scannen. Dieser Scanmodus bietet eine bessere Erkennungsqualität als das binäre Scannen, da im strukturierten Parsing-Modus nach Korrelationen zwischen Zeilen und Spalten in den strukturierten Daten gesucht wird.
Ergebnisse werden mit zusätzlichen Metadaten zurückgegeben, die den Speicherort des Ergebnisses angeben, einschließlich der fieldId.
In den folgenden Fällen kann Sensitive Data Protection jedoch in den binären Scanmodus zurückkehren, der die Verbesserungen des strukturierten Parsing-Modus nicht enthält:
- Die Datei oder der Header ist beschädigt.
- Die Konfiguration des Inspektionsjobs hat Größenbeschränkungen, z. B.
bytesLimitPerFileundbytesLimitPerFilePercent, die zu klein sind. Wenn das Limit fürbytesLimitPerFilebeispielsweise nicht groß genug ist, um einen vollständigen Blockheader und mindestens eine Zeile mit gültigen Daten zu enthalten, scannt Sensitive Data Protection diese Datei möglicherweise im binären Scanmodus.
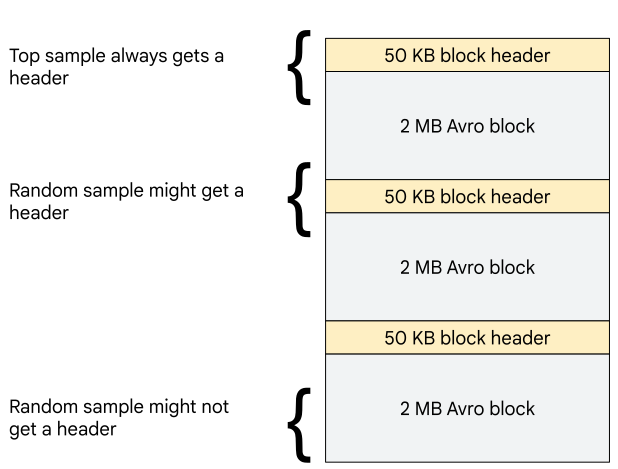
Die Auswahl der gescannten Daten hängt davon ab, ob die Stichprobenerhebung am Anfang der Datei oder an einer zufälligen Position beginnen soll.
Angenommen, Sie haben eine Avro-Datei mit 50-KB-Blockheadern und 2-MB-Datenblöcken. Im Allgemeinen hilft es, die Stichprobe von oben zu beginnen, um sicherzustellen, dass der Blockheader immer in der Stichprobe enthalten ist, die Sensitive Data Protection verwendet. Wenn Sie die Stichprobenerhebung an einer zufälligen Position in der Datei beginnen und die Stichprobengröße kleiner als ein Datenblock ist, besteht die Möglichkeit, dass der Blockheader nicht in der Stichprobe enthalten ist. In diesem Beispiel wird durch Erhöhen der Stichprobengröße (angegeben durch bytesLimitPerFile oder bytesLimitPerFilePercent) auf 2,05 MB verhindert, dass die Prüfung in den binären Parsing-Modus zurückkehrt.