


Nesta página, descrevemos as transações no Spanner e apresentamos as interfaces de transação de leitura e gravação, somente leitura e DML particionada do Spanner.
Uma transação no Spanner é um conjunto de leituras e gravações. Todas as operações em uma transação são atômicas, ou seja, todas são bem-sucedidas ou todas falham.
Uma sessão é usada para realizar transações em um banco de dados do Spanner. Uma sessão representa um canal de comunicação lógico com o serviço de banco de dados do Spanner. As sessões podem executar uma ou várias transações por vez. Para mais informações, consulte Sessões.
Tipos de transação
O Spanner é compatível com os seguintes tipos de transação, cada um projetado para padrões específicos de interação de dados:
Leitura e gravação: essas transações são usadas para operações de leitura e gravação, seguidas por uma confirmação. Eles podem adquirir bloqueios. Se falharem, será necessário tentar de novo. Embora estejam confinados a um único banco de dados, eles podem modificar dados em várias tabelas desse banco de dados.
Somente leitura: essas transações garantem a consistência dos dados em várias operações de leitura, mas não permitem modificações de dados. Elas são executadas em um carimbo de data/hora determinado pelo sistema para consistência ou em um carimbo de data/hora anterior configurado pelo usuário. Ao contrário das transações de leitura e gravação, elas não exigem uma operação de commit ou bloqueios. No entanto, elas podem ser pausadas para aguardar a conclusão das operações de gravação em andamento.
DML particionada: esse tipo de transação executa instruções DML como operações de DML particionada. Ele é otimizado para executar instruções DML em grande escala, mas com restrições para garantir que a instrução seja idempotente e particionável de uma forma que permita que ela seja executada independentemente de outras partições. Para várias gravações que não precisam de uma transação atômica, use gravações em lote. Para mais informações, consulte Modificar dados usando gravações em lote.
Transações de leitura e gravação
Uma transação de leitura e gravação consiste em zero ou mais leituras ou instruções de consulta seguidas por uma solicitação de confirmação. A qualquer momento antes da solicitação de commit, o cliente pode enviar uma solicitação de reversão para cancelar a transação.
Isolamento serializável
Usando o nível de isolamento serializável padrão com simultaneidade pessimista, as transações de leitura e gravação leem, modificam e gravam dados de forma atômica. Esse tipo de transação é externamente consistente.
Ao usar transações de leitura e gravação, recomendamos que você minimize o tempo em que uma transação fica ativa. Durações de transação mais curtas resultam em bloqueios mantidos por menos tempo, o que aumenta a probabilidade de uma confirmação bem-sucedida e reduz a contenção. Isso ocorre porque bloqueios de longa duração podem levar a impasses e cancelamentos de transações. O Spanner tenta manter os bloqueios de leitura ativos enquanto a transação continuar realizando leituras e não for encerrada por commit ou reverter. Se o cliente permanecer inativo por longos períodos, o Spanner poderá liberar os bloqueios da transação e abortar a transação.
Para executar uma operação de gravação que depende de uma ou mais operações de leitura, use uma transação de leitura/gravação:
- Se você precisar confirmar uma ou mais operações de gravação atomicamente, execute essas gravações na mesma transação de leitura e gravação. Por exemplo, se você transferir US$ 200 da conta A para a conta B, realize as duas operações de gravação (diminuindo US $200 da conta A e aumentando US $200 da conta B) e as leituras dos saldos iniciais da conta na mesma transação.
- Se você quiser dobrar o saldo da conta A, execute as operações de leitura e gravação na mesma transação. Isso garante que o sistema leia o saldo antes de dobrá-lo e atualizá-lo.
- Se as operações de gravação dependerem das operações de leitura, execute ambas na mesma transação de leitura e gravação, mesmo que as gravações não sejam executadas. Por exemplo, se você quiser transferir US $200 da conta A para a conta B somente se o saldo de A for maior que US $500, inclua a leitura do saldo de A e as operações de gravação condicional na mesma transação, mesmo que a transferência não ocorra.
Para realizar operações de leitura, use um único método de leitura ou uma transação somente leitura:
- Se você estiver realizando apenas operações de leitura e puder expressar a operação de leitura usando um método de leitura única, use o método de leitura única ou uma transação somente leitura. Ao contrário das transações de leitura e gravação, as leituras únicas não adquirem bloqueios.
Como alternativa, também é possível configurar o isolamento serializável para usar a simultaneidade otimista. O controle de simultaneidade otimista pressupõe que os conflitos são raros. As leituras e consultas, mesmo em uma transação de leitura e gravação, prosseguem sem adquirir bloqueios. Com o isolamento serializável, as leituras são validadas no momento da confirmação. Isso garante que nenhuma outra transação confirmada simultaneamente tenha modificado os dados lidos anteriormente pela transação.
Isolamento de leitura repetível
No Spanner, o isolamento de leitura repetível é implementado usando uma técnica conhecida como isolamento de snapshot. O isolamento de leitura repetível garante que todas as operações de leitura em uma transação sejam consistentes com o banco de dados como ele existia no início da transação. Ele também garante que as gravações simultâneas nos mesmos dados só sejam bem-sucedidas se não houver conflitos.
Com a simultaneidade otimista padrão, as gravações não adquirem bloqueios até o momento da confirmação. Se houver um conflito com os dados gravados ou devido a eventos temporários no Spanner, como a reinicialização de um servidor, o Spanner ainda poderá cancelar as transações. Como as leituras em transações de leitura/gravação não adquirem bloqueios no isolamento de leitura repetível, não há diferença entre executar operações somente leitura em uma transação somente leitura ou de leitura/gravação.
Use a simultaneidade pessimista
com leitura repetível para adquirir bloqueios exclusivos para dados lidos com uma cláusula FOR UPDATE
ou a dica lock_scanned_ranges=exclusive e para dados gravados por consultas
DML. Essa semântica é mais semelhante ao comportamento de bloqueio do
isolamento de leitura repetível em outros bancos de dados. Com a simultaneidade pessimista,
todas as leituras são exibidas no snapshot. Portanto, as transações podem ser canceladas se transações
simultâneas atualizarem os dados lidos. No entanto, ele impede que transações simultâneas
atualizem os dados bloqueados desde o momento em que os bloqueios são adquiridos até o momento da confirmação, o que pode reduzir possíveis conflitos de gravação-gravação.
Considere usar transações de leitura e gravação em isolamento de leitura repetível nos seguintes cenários:
- A carga de trabalho tem alta demanda de leitura e poucos conflitos de gravação.
- O aplicativo está enfrentando gargalos de desempenho devido a atrasos de concorrência de bloqueio e cancelamentos de transações causados por transações mais antigas e de maior prioridade que prejudicam as transações mais recentes e de menor prioridade para evitar possíveis impasses (wound-wait).
- O aplicativo não exige as garantias mais rígidas fornecidas pelo nível de isolamento serializável.
Considere usar o isolamento de leitura repetível com simultaneidade pessimista para
cargas de trabalho em que as instruções FOR UPDATE e DML adquirem bloqueios.
Ao realizar uma operação de gravação que depende de uma ou mais operações de leitura,
pode ocorrer distorção de gravação no isolamento de leitura repetível. A distorção de gravação surge de um
tipo específico de atualização simultânea, em que cada atualização é aceita
de forma independente, mas o efeito combinado viola a integridade dos dados do aplicativo.
Portanto, faça leituras que façam parte da seção crítica de uma transação com uma cláusula FOR UPDATE ou uma dica lock_scanned_ranges=exclusive para evitar distorções de gravação. Para mais informações, consulte
Conflitos de leitura e gravação e correção
e o exemplo discutido em
Semântica de leitura e gravação.
Interface
As bibliotecas de cliente do Spanner fornecem uma interface para executar um corpo de trabalho em uma transação de leitura e gravação, com novas tentativas de cancelamento de transações. Uma transação pode exigir várias novas tentativas antes de ser confirmada.
Várias situações podem causar o cancelamento de transações. Por exemplo, se duas transações tentarem modificar dados simultaneamente, poderá ocorrer um deadlock. Nesses casos, o Spanner cancela uma transação para permitir que a outra prossiga. Com menos frequência, eventos temporários no Spanner também podem causar cancelamentos de transações.
Todas as transações de leitura/gravação fornecem as propriedades ACID de bancos de dados relacionais.
Como as transações são atômicas, uma transação cancelada não afeta o
banco de dados. As bibliotecas de cliente do Spanner tentam realizar essas transações novamente de forma automática. Se você não usar as bibliotecas de cliente, tente realizar a transação novamente para melhorar as taxas de sucesso. Cada nova tentativa que resulta em um erro ABORTED
aumenta a prioridade de bloqueio da transação. Para manter essa prioridade de bloqueio, tente novamente
a transação na mesma sessão. Se você usar
sessões multiplexadas, também defina
TransactionOptions.ReadWrite.multiplexed_session_previous_transaction_id
como o ID da transação cancelada ao iniciar a nova tentativa. Além disso,
os drivers de cliente do Spanner incluem uma lógica interna de nova tentativa de transação
que mascara erros temporários ao executar novamente a transação.
Se você usar sessões multiplexadas, as bibliotecas de cliente do Spanner vão enviar o ID da transação cancelada com cada nova tentativa. Isso permite que a transação repetida mantenha a prioridade de bloqueio, mesmo que outras transações compartilhem a mesma sessão.
Ao usar uma transação em uma biblioteca de cliente do Spanner, você define o corpo da transação como um objeto de função. Essa função encapsula as leituras e gravações realizadas em uma ou mais tabelas do banco de dados. A biblioteca de cliente do Spanner executa essa função repetidamente até que a transação seja confirmada ou encontre um erro que não possa ser repetido.
Esse loop de repetição é separado das configurações de tempo limite e repetição para RPCs individuais, e a duração padrão dele depende da biblioteca de cliente. Para limitar o tempo total de uma transação, incluindo novas tentativas, consulte Configurar o tempo limite da transação.
Exemplo
Suponha que você tenha uma coluna MarketingBudget na
tabela Albums:
CREATE TABLE Albums (
  SingerId        INT64 NOT NULL,
  AlbumId         INT64 NOT NULL,
  AlbumTitle      STRING(MAX),
  MarketingBudget INT64
) PRIMARY KEY (SingerId, AlbumId);
O departamento de marketing pede que você transfira US $200.000 do orçamento de Albums
(2, 2) para Albums (1, 1), mas apenas se o dinheiro estiver disponível no orçamento desse álbum. Use uma transação de leitura/gravação com bloqueio para essa operação,
porque a transação pode realizar gravações dependendo do resultado de uma leitura.
Os exemplos de biblioteca de cliente a seguir mostram como executar uma transação de leitura e gravação usando o nível de isolamento serializável padrão:
C++
C#
Go
Java
Node.js
PHP
Python
Ruby
Para exemplos de como executar uma transação de leitura e gravação usando o isolamento de leitura repetível, consulte Usar o nível de isolamento de leitura repetível.
Semântica
Nesta seção, descrevemos a semântica das transações de leitura e gravação no Spanner.
Propriedades
O isolamento serializável é o nível de isolamento padrão no Spanner. No isolamento serializável, o Spanner oferece aos clientes as garantias mais rigorosas de controle de simultaneidade para transações, a consistência externa. Uma transação de leitura/gravação executa um conjunto de leituras e gravações de forma atômica. As gravações podem prosseguir sem serem bloqueadas por transações somente leitura. O carimbo de data/hora em que as transações de leitura e gravação são executadas corresponde ao tempo decorrido. A ordem de serialização corresponde à ordem do carimbo de data/hora.
Devido a essas propriedades, como desenvolvedor de aplicativos, você se concentra na exatidão de cada transação por si só, sem se preocupar em como proteger a execução dela contra outras transações que podem ser executadas ao mesmo tempo.
Também é possível executar transações de leitura e gravação usando o isolamento de leitura repetível. O isolamento de leitura repetível garante que todas as operações de leitura em uma transação vejam um snapshot forte e consistente do banco de dados como ele existia no início da transação. Para mais informações, consulte Isolamento de leitura repetível.
Transações de leitura e gravação com isolamento serializável
Depois de confirmar uma transação que contém uma série de leituras e gravações no isolamento serializável padrão, o seguinte se aplica:
- A transação retorna valores que refletem um snapshot consistente no carimbo de data/hora de confirmação da transação.
- As linhas ou intervalos vazios permanecem vazios no momento da confirmação.
- A transação confirma todas as gravações no carimbo de data/hora de confirmação da transação.
- Nenhuma transação pode ver as gravações até que a transação seja confirmada.
Os drivers de cliente do Spanner incluem uma lógica de repetição de transação que mascara erros temporários ao executar novamente a transação e validar os dados que o cliente observa.
O efeito é que todas as leituras e gravações parecem ter ocorrido em um único momento, tanto da perspectiva da própria transação quanto da perspectiva de outros leitores e gravadores no banco de dados do Spanner. Isso significa que as leituras e gravações ocorrem no mesmo carimbo de data/hora. Para ver um exemplo, consulte Capacidade de serialização e consistência externa.
Transações de leitura e gravação com isolamento de leitura repetível
Depois de confirmar uma transação com isolamento de leitura repetível, o seguinte se aplica:
- A transação retorna valores que refletem um snapshot consistente do banco de dados. O snapshot normalmente é estabelecido durante a primeira operação de transação, que pode não ser igual ao carimbo de data/hora de confirmação.
- Como a leitura repetível é implementada usando o isolamento de snapshot, a transação confirma todas as gravações no carimbo de data/hora de confirmação da transação somente se o conjunto de gravações não tiver mudado entre o carimbo de data/hora do snapshot da transação e o carimbo de data/hora de confirmação.
- As outras transações não veem as gravações até que a transação seja confirmada.
Isolamento para transações de leitura e gravação com operações somente leitura
Quando uma transação de leitura e gravação executa apenas operações de leitura, ela oferece garantias de consistência semelhantes às de uma transação somente leitura. Todas as leituras na transação retornam dados de um carimbo de data/hora consistente, incluindo a confirmação de linhas inexistentes.
Uma diferença é quando uma transação de leitura e gravação é confirmada sem executar uma operação de gravação. Nesse cenário, não há garantia de que os dados lidos na transação permaneceram inalterados no banco de dados entre a operação de leitura e a confirmação da transação.
Para garantir a atualização de dados e validar que eles não foram modificados desde a última recuperação, é necessária uma leitura subsequente. Essa nova leitura pode ser realizada em outra transação de leitura e gravação ou com uma leitura forte.
Para otimizar a eficiência, se uma transação estiver realizando exclusivamente leituras, use uma transação somente leitura em vez de uma transação de leitura e gravação, especialmente ao usar o isolamento serializável.
Como a serialização e a consistência externa diferem da leitura repetível
Por padrão, o Spanner oferece garantias transacionais fortes, incluindo capacidade de serialização e consistência externa. Essas propriedades garantem que os dados permaneçam consistentes e que as operações ocorram em uma ordem previsível, mesmo em um ambiente distribuído.
A serialização garante que todas as transações pareçam ser executadas uma após a outra em uma única ordem sequencial, mesmo que sejam processadas simultaneamente. O Spanner faz isso atribuindo carimbos de data/hora de confirmação às transações, refletindo a ordem em que foram confirmadas.
O Spanner oferece uma garantia ainda mais forte, conhecida como consistência externa. Isso significa que não apenas as transações são confirmadas em uma ordem refletida pelos carimbos de data/hora de confirmação, mas esses carimbos também se alinham com o tempo real. Isso permite comparar carimbos de data/hora de commit com o tempo real, fornecendo uma visualização consistente e ordenada globalmente dos seus dados.
Em essência, se uma transação Txn1 for confirmada antes de outra transação Txn2 em
tempo real, o carimbo de data/hora de confirmação de Txn1 será anterior ao carimbo de data/hora de confirmação
de Txn2.
Veja o exemplo a seguir.
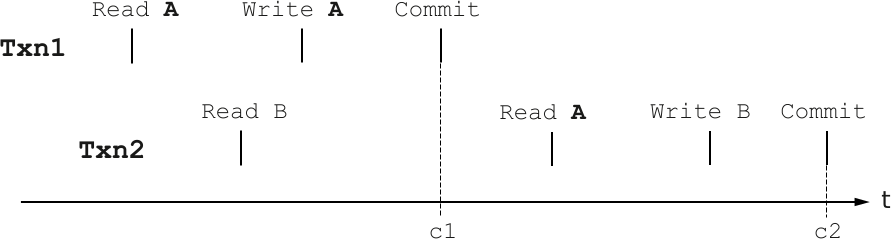
Nesse cenário, durante o cronograma t:
- A transação
Txn1lê os dadosA, prepara uma gravação emAe, em seguida, faz o commit. - A transação
Txn2começa depois queTxn1é iniciada. Ele lê os dadosBe, em seguida, os dadosA.
Mesmo que Txn2 tenha começado antes da conclusão de Txn1, Txn2 observa as mudanças
feitas por Txn1 em A. Isso ocorre porque Txn2 lê A depois que Txn1 confirma
a gravação em A.
Embora Txn1 e Txn2 possam se sobrepor no tempo de execução, os carimbos de data/hora de confirmação, c1 e c2, respectivamente, aplicam uma ordem de transação linear. Isso
significa que:
- Todas as leituras e gravações em
Txn1parecem ter ocorrido em um único momento,c1. - Todas as leituras e gravações em
Txn2parecem ter ocorrido em um único momento,c2. - É importante ressaltar que
c1é anterior ac2para gravações confirmadas, mesmo que as gravações tenham ocorrido em máquinas diferentes. SeTxn2realizar apenas leituras,c1será anterior ou simultâneo ac2.
Essa ordenação forte significa que, se uma operação de leitura subsequente observar os
efeitos de Txn2, ela também vai observar os efeitos de Txn1. Essa propriedade é verdadeira para todas as transações confirmadas.
Por outro lado, se você usar o isolamento de leitura repetível, o seguinte cenário vai ocorrer para as mesmas transações:
Txn1começa lendo os dadosA, criando o próprio snapshot do banco de dados naquele momento.- Em seguida,
Txn2começa, lendo os dadosBe estabelecendo o próprio snapshot. - Em seguida,
Txn1modifica os dadosAe confirma as mudanças. Txn2tenta ler os dadosA. Como está operando em um snapshot anterior,Txn2não vê a atualização queTxn1acabou de fazer emA.Txn2lê o valor mais antigo.Txn2modifica os dadosBe faz commits.
Nesse cenário, cada transação opera no próprio snapshot consistente do
banco de dados, tirado no momento em que a transação começa. Essa sequência pode
levar a uma anomalia de distorção de gravação se a gravação em B por Txn2 depender logicamente
do valor lido em A. Em essência, Txn2 fez as atualizações
com base em informações desatualizadas, e a gravação subsequente pode violar uma
invariante no nível do aplicativo. Para evitar que esse cenário ocorra, use SELECT...FOR UPDATE para isolamento de leitura repetível ou crie restrições de verificação no esquema.
Garantias de leitura e gravação em caso de falha na transação
Se uma chamada para executar uma transação falhar, as garantias de leitura e gravação que você tem dependem do erro que causou a falha na chamada de commit subjacente.
O Spanner pode executar as operações de uma transação várias vezes internamente. Se uma tentativa de execução falhar, o erro retornado vai especificar as condições que ocorreram e indicar as garantias que você recebe. No entanto, se o Spanner repetir a transação, os efeitos colaterais das operações (por exemplo, alterações em sistemas externos ou em um estado do sistema fora de um banco de dados do Spanner) poderão ocorrer várias vezes.
Quando uma transação do Spanner falha, as garantias que você recebe para leituras e gravações dependem do erro específico encontrado durante a operação de confirmação.
Por exemplo, uma mensagem de erro como "Linha não encontrada" ou "A linha já existe" indica um problema durante a gravação de mutações em buffer. Isso pode ocorrer se, por exemplo, uma linha que o cliente está tentando atualizar não existir. Nesses cenários:
- As leituras são consistentes: todos os dados lidos durante a transação são consistentes até o ponto do erro.
- As gravações não são aplicadas: as mutações que a transação tentou fazer não são confirmadas no banco de dados.
- Consistência de linha: a não existência (ou estado atual) da linha que acionou o erro é consistente com as leituras realizadas na transação.
É possível cancelar operações de leitura assíncronas no Spanner a qualquer momento sem afetar outras operações em andamento na mesma transação. Essa flexibilidade é útil se uma operação de nível superior for cancelada ou se você decidir interromper uma leitura com base nos resultados iniciais.
No entanto, é importante entender que solicitar o cancelamento de uma leitura não garante o encerramento imediato dela. Após uma solicitação de cancelamento, a operação de leitura ainda pode:
- Conclusão: a leitura pode terminar o processamento e retornar resultados antes que o cancelamento entre em vigor.
- Falha por outro motivo: a leitura pode ser encerrada devido a um erro diferente, como uma interrupção.
- Retornar resultados incompletos: a leitura pode retornar resultados parciais, que são validados como parte do processo de confirmação da transação.
O cancelamento de uma operação de commit cancela toda a transação, a menos que ela já tenha sido confirmada ou tenha falhado por outro motivo.
Atomicidade, consistência, durabilidade
Além do isolamento, o Spanner oferece as outras garantias de propriedade ACID:
- Atomicidade: uma transação é considerada atômica se todas as operações de TI forem concluídas com sucesso ou nenhuma delas. Se alguma operação em uma transação falhar, toda a transação será revertida para o estado original, garantindo a integridade de dados.
- Consistência: uma transação precisa manter a integridade das regras e restrições do banco de dados. Depois que uma transação é concluída, o banco de dados precisa estar em um estado válido, de acordo com as regras predefinidas.
- Durabilidade: depois que uma transação é confirmada, as mudanças são armazenadas permanentemente no banco de dados e persistem em caso de falhas do sistema, interrupções de energia ou outras interrupções.
Desempenho
Nesta seção, descrevemos os problemas que afetam o desempenho das transações de leitura e gravação.
Controle de simultaneidade de bloqueio
Por padrão, o Spanner permite que vários clientes interajam com o mesmo banco de dados simultaneamente no nível de isolamento serializável padrão. Para manter a consistência dos dados nessas transações simultâneas, o Spanner tem um mecanismo de bloqueio que usa bloqueios compartilhados e exclusivos. Esses bloqueios de leitura são adquiridos apenas para transações serializáveis, mas não para transações que usam isolamento de leitura repetível.
Quando uma transação serializável executa uma operação de leitura, o Spanner adquire bloqueios de leitura compartilhados nos dados relevantes. Esses bloqueios compartilhados permitem que outras operações de leitura simultâneas acessem os mesmos dados. Essa simultaneidade é mantida até que a transação se prepare para confirmar as alterações.
No isolamento serializável, durante a fase de confirmação, conforme as gravações são aplicadas, a transação tenta fazer upgrade dos bloqueios para bloqueios exclusivos. Para isso, o Spanner faz o seguinte:
- Bloqueia novas solicitações de bloqueio de leitura compartilhada nos dados afetados.
- Aguarda a liberação de todos os bloqueios de leitura compartilhados nos dados.
- Depois que todos os bloqueios de leitura compartilhados são liberados, ele coloca um bloqueio exclusivo, concedendo acesso único aos dados durante a gravação.
Por outro lado, nem o isolamento serializável do Spanner com simultaneidade otimista nem o isolamento de leitura repetível com simultaneidade otimista adquirem bloqueios durante a execução da transação. Ao confirmar, a transação adquire bloqueios exclusivos para os dados gravados. A transação pode ter que esperar por bloqueios se uma transação simultânea também estiver confirmando gravações nos mesmos dados.
No isolamento de leitura repetível com simultaneidade pessimista, os bloqueios exclusivos são
adquiridos para os dados lidos por consultas que usam FOR UPDATE ou a
dica lock_scanned_ranges=exclusive e para dados gravados com consultas DML.
Portanto, não é necessário adquirir mais bloqueios no momento da confirmação.
Observações sobre bloqueios:
- Granularidade: o Spanner aplica bloqueios na granularidade de linha e coluna. Isso significa que, se a transação
T1mantiver um bloqueio na colunaAda linhaalbumid, a transaçãoT2ainda poderá gravar simultaneamente na colunaBda mesma linhaalbumidsem conflito. Gravações sem leituras:
- Quando não há leituras na transação, o Spanner pode não exigir um bloqueio exclusivo para gravações sem leituras. Em vez disso, ele pode usar um bloqueio compartilhado de gravação. Isso ocorre porque a ordem de aplicação para gravações sem leituras é determinada pelos carimbos de data/hora de confirmação, permitindo que vários gravadores operem no mesmo item simultaneamente sem conflitos. Um bloqueio exclusivo só é necessário se a transação ler primeiro os dados que pretende gravar.
- No isolamento de leitura repetível, as transações geralmente adquirem bloqueios exclusivos para células gravadas no momento da confirmação.
Índices secundários para pesquisas de linha: no isolamento serializável, ao realizar leituras em uma transação de leitura e gravação, o uso de índices secundários pode melhorar significativamente o desempenho. Ao usar índices secundários para limitar as linhas verificadas a um intervalo menor, o Spanner bloqueia menos linhas na tabela, permitindo uma maior modificação simultânea de linhas fora desse intervalo específico.
Acesso exclusivo a recursos externos: os bloqueios internos do Spanner são projetados para garantir a consistência dos dados no próprio banco de dados do Spanner. Não as use para garantir acesso exclusivo a recursos fora do Spanner. O Spanner pode cancelar transações por vários motivos, incluindo otimizações internas do sistema, como movimentação de dados entre recursos de computação. Se uma transação for repetida (explicitamente pelo código do aplicativo ou implicitamente por bibliotecas de cliente, como o driver JDBC do Spanner), os bloqueios só serão garantidos durante a tentativa de confirmação bem-sucedida.
Estatísticas de bloqueio: para diagnosticar e investigar conflitos de bloqueio no seu banco de dados, use a ferramenta de introspecção Estatísticas de bloqueio.
Detecção de impasses
O Spanner detecta quando várias transações podem estar em deadlock
e força todas as transações, exceto uma, a serem canceladas. Considere este cenário:
Txn1 mantém um bloqueio no registro A e está aguardando um bloqueio no registro B, enquanto
Txn2 mantém um bloqueio no registro B e está aguardando um bloqueio no registro A. Para
resolver isso, uma das transações precisa ser cancelada, liberando o bloqueio e
permitindo que a outra continue.
O Spanner usa o algoritmo padrão de wound-wait para detecção de deadlock. Em segundo plano, o Spanner rastreia a idade de cada transação que solicita bloqueios conflitantes. Ele permite que transações mais antigas cancelem as mais recentes. Uma transação mais antiga é aquela em que a leitura, consulta ou confirmação mais antiga ocorreu antes.
Ao priorizar transações mais antigas, o Spanner garante que todas as transações acabem adquirindo bloqueios depois de se tornarem antigas o suficiente para ter prioridade mais alta. Por exemplo, uma transação mais antiga que precisa de um bloqueio compartilhado de gravação pode interromper uma transação mais recente que tenha um bloqueio compartilhado de leitura.
Execução distribuída
O Spanner pode executar transações em dados que abrangem vários servidores, mas esse recurso tem um custo de desempenho em comparação com transações de servidor único.
Quais tipos de transações podem ser distribuídos? O Spanner pode distribuir a responsabilidade pelas linhas do banco de dados entre vários servidores. Normalmente, uma linha e as linhas da tabela intercalada correspondente são exibidas pelo mesmo servidor, assim como duas linhas na mesma tabela com chaves próximas. O Spanner pode realizar transações em linhas em servidores diferentes. No entanto, como regra geral, as transações que afetam muitas linhas colocalizadas são mais rápidas e baratas do que aquelas que afetam muitas linhas espalhadas pelo banco de dados ou por uma tabela grande.
As transações mais eficientes no Spanner incluem apenas as leituras e gravações que precisam ser aplicadas de forma atômica. As transações são mais rápidas quando todas as leituras e gravações acessam dados na mesma parte do espaço de chave.
Transações somente leitura
Além de bloquear transações de leitura e gravação, o Spanner oferece transações somente leitura.
Use uma transação somente leitura quando precisar executar mais de uma leitura no mesmo carimbo de data/hora. Se for possível expressar sua leitura usando um dos métodos de leitura única do Spanner, use esse método. O desempenho da utilização de uma chamada de leitura única é comparável ao de uma única leitura feita em uma transação somente leitura.
Se você estiver lendo uma grande quantidade de dados, use partições para ler os dados em paralelo.
Como as transações somente leitura não gravam, elas não mantêm bloqueios e não bloqueiam outras transações. As transações somente leitura estão de acordo com um prefixo consistente do histórico de confirmações da transação. Portanto, o aplicativo sempre recebe dados consistentes.
Interface
O Spanner fornece uma interface para executar um corpo de trabalho no contexto de uma transação somente leitura, com novas tentativas de cancelamento de transações.
Exemplo
O exemplo a seguir mostra como usar uma transação somente leitura para receber dados consistentes para duas leituras no mesmo carimbo de data/hora:
C++
C#
Go
Java
Node.js
PHP
Python
Ruby
Semântica
Nesta seção, descrevemos a semântica das transações somente leitura.
Transações somente leitura de snapshot
Quando uma transação somente leitura é executada no Spanner, ela realiza todas as leituras em um único momento lógico. Isso significa que tanto a transação somente leitura quanto qualquer outro leitor e gravador simultâneo veem um snapshot consistente do banco de dados naquele momento específico.
Essas transações somente leitura de snapshot oferecem uma abordagem mais simples para leituras consistentes em comparação com o bloqueio de transações de leitura e gravação. Geralmente, estes são os motivos:
- Sem bloqueios: as transações somente leitura não adquirem bloqueios. Em vez disso, elas operam selecionando um carimbo de data/hora do Spanner e executando todas as leituras nessa versão histórica dos dados. Como elas não usam bloqueios, não bloqueiam transações simultâneas de leitura/gravação.
- Sem cancelamentos: essas transações nunca são canceladas. Embora possam falhar se o carimbo de data/hora de leitura escolhido for coletado como lixo, a política de coleta de lixo padrão do Spanner normalmente é generosa o suficiente para que a maioria dos aplicativos não encontre esse problema.
- Sem commits ou reversões: as transações somente leitura não exigem chamadas para
sessions.commitousessions.rollbacke são impedidas de fazer isso.
Para executar uma transação de snapshot, o cliente define um limite de carimbo de data/hora, que instrui o Spanner sobre como selecionar um carimbo de data/hora de leitura. Os tipos de limites de carimbo de data/hora incluem:
- Leituras fortes: garantem que você verá os efeitos de todas as transações confirmadas antes do início da leitura. Todas as linhas em uma única leitura são consistentes. No entanto, as leituras fortes não são repetíveis, embora retornem um carimbo de data/hora, e a leitura novamente nesse mesmo carimbo de data/hora seja repetível. Duas transações consecutivas de leitura forte podem produzir resultados diferentes devido a gravações simultâneas. As consultas em fluxo de alterações precisam usar esse limite. Para mais detalhes, consulte TransactionOptions.ReadOnly.strong.
- Desatualização exata: essa opção executa leituras em um carimbo de data/hora especificado por você, seja como um carimbo de data/hora absoluto ou como uma duração de desatualização em relação ao horário atual. Ele garante que você observe um prefixo consistente do histórico de transações globais até esse carimbo de data/hora. A leitura aguarda até que todas as transações conflitantes que possam ser confirmadas no carimbo de data/hora de leitura ou antes dele sejam concluídas. Embora seja um pouco mais rápido do que os modos de desatualização limitada, ele pode retornar dados mais antigos. Para mais detalhes, consulte TransactionOptions.ReadOnly.read_timestamp e TransactionOptions.ReadOnly.exact_staleness.
- Desatualização limitada: o Spanner seleciona o carimbo de data/hora mais recente que permite que a réplica disponível mais próxima exiba a leitura sem bloqueio, dentro de um limite de desatualização definido por você. Todas as linhas retornadas são consistentes. Assim como as leituras fortes, as leituras desatualizadas limitadas não são repetíveis, porque leituras diferentes podem ser executadas em carimbos de data/hora diferentes, mesmo com o mesmo limite. Essas leituras operam em duas fases (negociação de carimbo de data/hora e, em seguida, a leitura) e geralmente são um pouco mais lentas do que as leituras desatualizadas exatas, mas costumam retornar resultados mais recentes. Esse modo está disponível apenas para transações de uso único somente leitura, porque a negociação de carimbo de data/hora requer saber com antecedência quais linhas a leitura acessa. Para mais detalhes, consulte TransactionOptions.ReadOnly.max_staleness e TransactionOptions.ReadOnly.min_read_timestamp.
As leituras de desatualização exata e limitada são executadas na réplica disponível mais próxima. Se essa réplica não estiver atualizada com o carimbo de data/hora de leitura, ela precisará se comunicar com a réplica líder antes de disponibilizar a leitura. As leituras desatualizadas limitadas têm menos probabilidade de precisar dessa comunicação do líder, porque o Spanner escolhe um carimbo de data/hora que a réplica já pode exibir.
Transações de DML particionada
É possível usar a DML particionada para executar
instruções UPDATE e DELETE em grande escala sem encontrar limites de transação
ou bloquear uma tabela inteira. Para isso, o Spanner particiona o espaço de chaves e executa as instruções DML em cada partição em uma transação de leitura e gravação separada.
Para usar a DML não particionada, execute instruções em transações de leitura e gravação que você cria explicitamente no código. Para mais detalhes, consulte Como usar a DML.
Interface
O Spanner fornece a interface TransactionOptions.partitionedDml para executar uma única instrução DML particionada.
Exemplos
O exemplo de código a seguir atualiza a coluna MarketingBudget da tabela Albums.
C++
Use a função ExecutePartitionedDml() para executar uma instrução DML particionada.
C#
Use o método ExecutePartitionedUpdateAsync() para executar uma instrução DML particionada.
Go
Use o método PartitionedUpdate() para executar uma instrução DML particionada.
Java
Use o método executePartitionedUpdate() para executar uma instrução DML particionada.
Node.js
Use o método runPartitionedUpdate() para executar uma instrução DML particionada.
PHP
Use o método executePartitionedUpdate() para executar uma instrução DML particionada.
Python
Use o método execute_partitioned_dml() para executar uma instrução DML particionada.
Ruby
Use o método execute_partitioned_update() para executar uma instrução DML particionada.
O exemplo de código a seguir exclui linhas da tabela Singers com base na coluna SingerId.
C++
C#
Go
Java
Node.js
PHP
Python
Ruby
Semântica
Nesta seção, descrevemos a semântica da DML particionada.
Noções básicas sobre a execução de DML particionada
Só é possível executar uma instrução DML particionada por vez, seja usando um método de biblioteca de cliente ou a Google Cloud CLI.
As transações particionadas não são compatíveis com confirmações ou reversões. O Spanner executa e aplica a instrução DML imediatamente. Se você cancelar a operação ou se ela falhar, o Spanner vai cancelar todas as partições em execução e não vai iniciar as restantes. No entanto, o Spanner não reverter as partições que já foram executadas.
Estratégia de aquisição de bloqueio de DML particionada
Para reduzir a disputa por bloqueio, a DML particionada adquire bloqueios de leitura apenas em linhas que
correspondem à cláusula WHERE. Transações menores e independentes usadas para cada
partição também mantêm bloqueios por menos tempo.
Carimbos de data/hora de leitura antigos e coleta de lixo de versões
O Spanner realiza a coleta de lixo de versões para coletar dados excluídos ou
substituídos e recuperar o armazenamento. Por padrão, os dados com mais de uma hora são
reivindicados. O Spanner não pode realizar leituras em carimbos de data/hora anteriores ao VERSION_RETENTION_PERIOD configurado, que, por padrão, é de uma hora, mas pode ser configurado para até uma semana. Quando as leituras ficam muito antigas durante a execução, elas
falham e retornam o erro FAILED_PRECONDITION.
Consultas em fluxo de alterações
Um fluxo de alterações é um objeto de esquema que pode ser configurado para monitorar modificações de dados em um banco de dados inteiro, em tabelas específicas ou em um conjunto definido de colunas em um banco de dados.
Quando você cria um fluxo de alterações, o Spanner define uma
função com valor de tabela (TVF, na sigla em inglês) do SQL correspondente. É possível usar essa TVF para consultar os
registros de alteração no fluxo de alterações associado com o
método
sessions.executeStreamingSql. O nome da TVF é gerado com base no nome do fluxo de alterações e sempre
começa com READ_.
Todas as consultas em TVFs de fluxo de alterações precisam ser executadas usando a API sessions.executeStreamingSql em uma transação somente leitura de uso único com um timestamp_bound somente leitura forte. A TVF do fluxo de alterações permite
especificar start_timestamp e end_timestamp para o período. Todos os registros de alteração dentro do período de armazenamento podem ser acessados usando essa timestamp_bound forte somente leitura. Todos os outros
TransactionOptions são
inválidos para consultas de fluxo de alterações.
Além disso, se
TransactionOptions.read_only.return_read_timestamp
estiver definido como true, a
mensagem Transaction que descreve
a transação retornará um valor especial de 2^63 - 2 em vez de um carimbo de data/hora de leitura
válido. Descarte esse valor especial e não o use em consultas
subsequentes.
Para mais informações, consulte Fluxo de trabalho de consulta de fluxos de alterações.
Transações inativas
Uma transação é considerada inativa se não tiver leituras ou consultas SQL pendentes
e não tiver iniciado uma nos últimos 10 segundos. O Spanner pode cancelar
transações inativas para evitar que elas mantenham bloqueios indefinidamente. Se uma transação
ociosa for cancelada, a confirmação vai falhar e retornar um erro ABORTED.
Executar periodicamente uma consulta pequena, como SELECT 1, dentro da transação
pode evitar que ela fique inativa.
A seguir
- Saiba mais sobre os níveis de isolamento do Spanner.