


本頁面說明 Spanner 中的交易,並介紹 Spanner 的讀寫、唯讀和分區 DML 交易介面。
Spanner 中的交易是一組讀取和寫入作業。交易中的所有作業都是不可分割的,也就是說,所有作業都會成功或全部失敗。
工作階段用於在 Spanner 資料庫中執行交易。工作階段代表與 Spanner 資料庫服務的邏輯通訊管道。工作階段一次可以執行一或多筆交易。詳情請參閱「工作階段」。
交易類型
Spanner 支援下列交易類型,每種都適用於特定資料互動模式:
讀寫:這類交易用於讀取和寫入作業,接著會執行修訂。他們可能會取得鎖。如果失敗,則需要重試。雖然只能在單一資料庫中執行,但可以修改該資料庫中多個資料表的資料。
唯讀:這類交易可確保多項讀取作業的資料一致性,但不允許修改資料。為了確保一致性,系統會根據系統決定的時間戳記,或使用者設定的過去時間戳記執行查詢。與讀寫交易不同,唯讀交易不需要提交作業或鎖定。不過,這類作業可能會暫停,等待進行中的寫入作業完成。
分區 DML:這類交易會以分區 DML 作業的形式執行 DML 陳述式。這項功能經過最佳化,可大規模執行 DML 陳述式,但設有限制,確保陳述式具有冪等性且可分區,以便獨立於其他分區執行。如果需要執行大量寫入作業,但不需要原子交易,建議使用批次寫入。詳情請參閱「使用批次寫入修改資料」。
讀寫交易
讀寫交易包含零或多個讀取或查詢陳述式,後面接著修訂要求。在提交要求前,用戶端隨時可以傳送復原要求來取消交易。
可序列化隔離
使用預設的可序列化隔離等級和悲觀並行,讀寫交易會以不可分割的方式讀取、修改及寫入資料。這類交易具有外部一致性。
使用讀寫交易時,建議盡量縮短交易的有效時間。交易時間越短,鎖定時間就越短,進而提高提交成功的機率,並減少爭用。這是因為長時間鎖定可能會導致死結和交易中止。只要交易持續執行讀取作業,且未透過提交或復原終止,Spanner 就會嘗試保持讀取鎖定狀態。如果用戶端長時間處於閒置狀態,Spanner 可能會釋出交易鎖定並取消交易。
如要執行依賴一或多項讀取作業的寫入作業,請使用讀寫交易:
- 如須以不可分割的方式提交一或多項寫入作業,請在同一個讀寫交易中執行這些寫入作業。舉例來說,如果您將 $200 元從帳戶 A 轉移至帳戶 B,請在同一筆交易中執行兩項寫入作業 (將帳戶 A 減少 $200 元,並將帳戶 B 增加 $200 元),以及讀取初始帳戶餘額。
- 如要將帳戶 A 的餘額加倍,請在同一筆交易中執行讀取和寫入作業。這樣可確保系統先讀取餘額,再將餘額加倍並更新。
- 如果寫入作業取決於讀取作業,請在同一個讀寫交易中執行這兩項作業,即使寫入作業未執行也一樣。舉例來說,如果只有在 A 帳戶餘額大於 $500 美元時,才要從 A 帳戶轉移 $200 美元至 B 帳戶,請在同一筆交易中加入 A 帳戶餘額的讀取作業和條件式寫入作業,即使轉移作業未發生也一樣。
如要執行讀取作業,請使用單一讀取方法或唯讀交易:
- 如果您只執行讀取作業,且可以使用單一讀取方法表示讀取作業,請使用單一讀取方法或唯讀交易。與讀寫交易不同,單一讀取不會取得鎖定。
或者,您也可以將可序列化隔離設為使用開放式並行。樂觀並行控制假設衝突很少發生。即使在讀寫交易中,讀取和查詢作業也不會取得鎖定。使用可序列化隔離時,系統會在提交時驗證讀取作業。這可確保沒有其他並行提交的交易修改了交易先前讀取的資料。
可重複讀取隔離
在 Spanner 中,可重複讀取隔離是使用快照隔離技術實作。可重複讀取隔離可確保交易中的所有讀取作業,都與交易開始時的資料庫一致。此外,這項機制也保證,只有在沒有衝突的情況下,對同一資料的並行寫入作業才會成功。
根據預設的樂觀並行,寫入作業在提交前不會取得鎖定。如果寫入的資料發生衝突,或 Spanner 內部發生暫時性事件 (例如伺服器重新啟動),Spanner 仍可能取消交易。由於讀寫交易中的讀取作業不會在可重複讀取隔離中取得鎖定,因此在唯讀交易或讀寫交易中執行唯讀作業沒有差別。
使用悲觀並行和可重複讀取,為使用 FOR UPDATE 子句或 lock_scanned_ranges=exclusive 提示讀取的資料,以及 DML 查詢寫入的資料,取得專屬鎖定。這些語意與其他資料庫中可重複讀取隔離的鎖定行為更相似。採用悲觀並行模式時,所有讀取作業都會在快照中執行,因此如果並行交易更新了讀取資料,交易可能會取消。不過,從取得鎖定到提交期間,並行交易無法更新鎖定的資料,這可能會減少潛在的寫入衝突。
在下列情況下,建議使用可重複讀取隔離等級的讀寫交易:
- 工作負載以讀取為主,寫入衝突較少。
- 應用程式效能出現瓶頸,原因是較舊、優先順序較高的交易會中斷較新、優先順序較低的交易,以防止潛在死結 (wound-wait),導致鎖定爭用和交易中止,進而造成延遲。
- 應用程式不需要可序列化隔離等級提供的更嚴格保證。
如果工作負載中的 FOR UPDATE 和 DML 陳述式會取得鎖定,建議使用可重複讀取隔離層級,並搭配悲觀並行模式。
執行依賴一或多個讀取作業的寫入作業時,在可重複讀取隔離層級下,可能會發生寫入偏斜。寫入偏斜是由特定類型的並行更新引起,其中每個更新都會獨立接受,但其合併效果會違反應用程式資料完整性。因此,請務必使用 FOR UPDATE 子句或 lock_scanned_ranges=exclusive 提示,執行屬於交易關鍵區段的讀取作業,避免寫入偏斜。詳情請參閱「讀寫衝突和正確性」,以及「讀寫語意」中討論的範例。
介面
Spanner 用戶端程式庫提供介面,可在讀寫交易中執行工作主體,並在交易中止時重試。交易可能需要多次重試才能提交。
有幾種情況會導致交易取消。舉例來說,如果兩筆交易同時嘗試修改資料,就可能發生死結。在這種情況下,Spanner 會取消其中一項交易,讓另一項交易繼續進行。Spanner 內的暫時性事件也可能導致交易中止,但這種情況較少發生。
所有讀寫交易都具備關聯式資料庫的 ACID 屬性。由於交易不可分割,因此取消的交易不會影響資料庫。Spanner 用戶端程式庫會自動重試這類交易。如果不使用用戶端程式庫,請自行重試交易,提高成功率。每次重試導致 ABORTED 錯誤時,交易的鎖定優先順序就會提高。如要保留這個鎖定優先順序,請在同一個工作階段中重試交易。如果您使用多工工作階段,請在開始重試時,將 TransactionOptions.ReadWrite.multiplexed_session_previous_transaction_id 設為已取消交易的 ID。此外,Spanner 用戶端驅動程式包含內部交易重試邏輯,可透過重新執行交易來遮蓋暫時性錯誤。
如果您使用多工工作階段,Spanner 用戶端程式庫會在每次重試時傳送已取消交易的 ID。這樣一來,即使其他交易共用同一個工作階段,重試的交易仍可保留鎖定優先順序。
在 Spanner 用戶端程式庫中使用交易時,您會將交易主體定義為函式物件。這個函式會封裝對一或多個資料庫資料表執行的讀取和寫入作業。Spanner 用戶端程式庫會重複執行這個函式,直到交易成功提交或發生無法重試的錯誤。
這個重試迴圈與個別 RPC 的逾時和重試設定分開,預設時間長度取決於用戶端程式庫。如要限制交易總時間 (包括重試),請參閱「設定交易逾時」。
範例
假設Albums 資料表中有 MarketingBudget 欄:
CREATE TABLE Albums (
  SingerId        INT64 NOT NULL,
  AlbumId         INT64 NOT NULL,
  AlbumTitle      STRING(MAX),
  MarketingBudget INT64
) PRIMARY KEY (SingerId, AlbumId);
行銷部門要求您將 Albums
(2, 2) 的預算挪出 $200,000 美元給 Albums (1, 1),但前提是該專輯的預算有這筆金額。這項作業應使用鎖定讀寫交易,因為交易可能會根據讀取結果執行寫入作業。
下列用戶端程式庫範例說明如何使用預設的可序列化隔離等級,執行讀寫交易:
C++
C#
Go
Java
Node.js
PHP
Python
小茹
如需使用可重複讀取隔離執行讀寫交易的範例,請參閱「使用可重複讀取隔離等級」。
語意
本節說明 Spanner 中讀寫交易的語意。
屬性
可序列化隔離是 Spanner 的預設隔離等級。在可序列化隔離模式下,Spanner 為用戶端提供最嚴格的交易並行控制保證,即外部一致性。讀寫交易會以不可分割的方式執行一組讀取和寫入作業。寫入作業可以繼續進行,不會受到唯讀交易的阻礙。讀寫交易執行的時間戳記與經過時間相符。序列化順序與這個時間戳記順序相符。
由於有這些屬性,做為應用程式開發商,您可以著重在每個交易自身的正確性,不須擔心如何保護自己的執行作業,以免遭到同時間執行的其他交易覆寫。
您也可以使用可重複讀取的隔離層級,執行讀寫交易。可重複讀取隔離可確保交易中的所有讀取作業,都能看到交易開始時資料庫的一致強式快照。詳情請參閱「可重複讀取隔離」。
採用可序列化隔離機制的讀寫交易
在預設的可序列化隔離中,成功提交包含一系列讀取和寫入的交易後,系統會套用下列規則:
- 交易傳回的值會反映交易修訂時間戳記的一致快照。
- 空白列或範圍在提交時仍會保持空白。
- 交易會在交易的修訂版本時間戳記修訂所有寫入作業。
- 在交易提交之前,任何交易都無法查看寫入內容。
Spanner 用戶端驅動程式包含交易重試邏輯,可重新執行交易並驗證用戶端觀察到的資料,藉此遮蓋暫時性錯誤。
無論是從交易本身的角度,還是從 Spanner 資料庫的其他讀取器和寫入器的角度來看,所有讀取和寫入作業都像是在單一時間點發生。這表示讀取和寫入作業會在相同的時間戳記發生。如需範例,請參閱「可序列化和外部一致性」。
讀寫交易,採用可重複讀取隔離
成功提交具有可重複讀取隔離層級的交易後,系統會執行下列操作:
- 交易傳回的值會反映資料庫的一致快照。快照通常是在第一個交易作業期間建立,可能與修訂版本時間戳記不同。
- 由於可重複讀取是使用快照隔離功能實作,因此只有在交易快照時間戳記和修訂時間戳記之間,寫入集未變更時,交易才會在交易的修訂時間戳記修訂所有寫入。
- 其他交易在提交前,不會看到寫入作業。
讀寫交易與唯讀作業的隔離
如果讀寫交易只執行讀取作業,則提供的一致性保證與唯讀交易類似。交易中的所有讀取作業都會傳回一致時間戳記的資料,包括確認不存在的資料列。
其中一項差異是,當讀寫交易在未執行寫入作業的情況下提交時,在這種情況下,無法保證在讀取作業和交易提交之間,交易中讀取的資料在資料庫中保持不變。
為確保資料更新間隔,並驗證資料自上次擷取後未經修改,必須進行後續讀取。這項重新讀取作業可在另一個讀寫交易中執行,也可透過強式讀取執行。
為達到最佳效率,如果交易只執行讀取作業,請使用唯讀交易,而非讀寫交易,尤其是在使用可序列化隔離時。
可序列化和外部一致性與可重複讀取的差異
根據預設,Spanner 提供強大的交易保證,包括可序列化和外部一致性。這些屬性可確保資料保持一致,且作業會按照可預測的順序進行,即使在分散式環境中也是如此。
可序列化性可確保所有交易看起來都是依序執行,即使是同時處理也一樣。Spanner 會為交易指派修訂時間戳記,反映交易修訂的順序,藉此達到這個目的。
Spanner 提供更強大的保證,稱為「外部一致性」。這表示交易不僅會按照修訂版本時間戳記反映的順序修訂,這些時間戳記也會與實際時間一致。這樣一來,您就能比較修訂版本時間戳記與實際時間,取得一致且全域排序的資料檢視畫面。
基本上,如果交易 Txn1 在即時交易 Txn2 之前提交,則 Txn1 的提交時間戳記會早於 Txn2 的提交時間戳記。
請見如下範例:
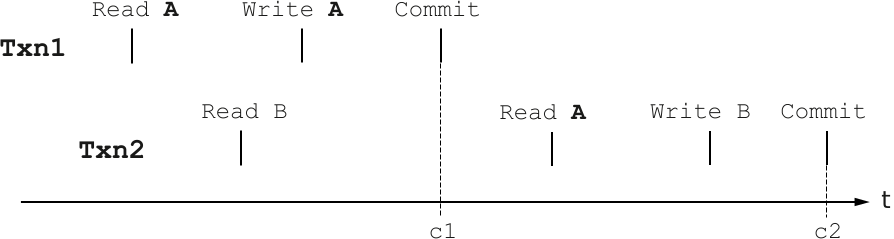
在這個情境中,t期間:
- 交易
Txn1讀取資料A,暫存寫入A,然後成功修訂。 - 交易
Txn2會在Txn1開始後啟動。它會先讀取資料B,然後讀取資料A。
即使 Txn2 在 Txn1 完成前就已啟動,Txn2 仍會觀察 Txn1 對 A 所做的變更。這是因為 Txn2 在 Txn1 將寫入內容提交至 A 後,讀取 A。
雖然 Txn1 和 Txn2 的執行時間可能重疊,但其提交時間戳記 (分別為 c1 和 c2) 會強制執行線性交易順序。這表示:
Txn1內的所有讀取和寫入作業,似乎都發生在單一時間點c1。Txn2內的所有讀取和寫入作業,似乎都發生在單一時間點c2。- 重要的是,對於已提交的寫入作業,
c1早於c2,即使寫入作業發生在不同的機器上也是如此。如果Txn2僅執行讀取作業,則c1會早於或與c2同時執行。
這種強大的排序功能表示,如果後續的讀取作業觀察到 Txn2 的效果,也會觀察到 Txn1 的效果。這項屬性適用於所有成功提交的交易。
另一方面,如果您使用可重複讀取隔離,則相同交易會發生以下情況:
Txn1會先讀取資料A,並在該時刻建立自己的資料庫快照。Txn2隨即開始讀取資料B,並建立自己的快照。- 接著,
Txn1修改資料A,並成功修訂變更。 Txn2嘗試讀取資料A。重要的是,由於Txn2是在較早的快照上運作,因此不會看到Txn1剛對A進行的更新。Txn2讀取舊值。Txn2修改資料B並提交。
在這種情況下,每筆交易都會在資料庫的一致快照上運作,快照是在交易開始時擷取。如果 Txn2 對 B 的寫入作業在邏輯上依賴從 A 讀取的值,則這個序列可能會導致寫入偏斜異常。基本上,Txn2 是根據過時資訊進行更新,後續寫入作業可能會違反應用程式層級不變量。為避免這種情況發生,建議您使用 SELECT...FOR UPDATE 進行可重複讀取隔離,或在結構定義中建立檢查限制。
交易失敗時的讀寫保證
如果執行交易的呼叫失敗,您擁有的讀取和寫入保證取決於基礎修訂呼叫失敗時發生的錯誤。
Spanner 可能會在內部多次執行交易作業。如果執行失敗,傳回的錯誤會指定發生的條件,並指出您收到的保證。不過,如果 Spanner 重試交易,其作業產生的任何副作用 (例如變更外部系統或 Spanner 資料庫以外的系統狀態) 可能會發生多次。
Spanner 交易失敗時,讀取和寫入作業的保證取決於修訂作業期間發生的特定錯誤。
舉例來說,「找不到資料列」或「資料列已存在」等錯誤訊息,表示在寫入緩衝異動時發生問題。舉例來說,如果用戶端嘗試更新的資料列不存在,就可能發生這種情況。在這些情況下:
- 讀取作業一致:交易期間讀取的任何資料,在發生錯誤前都保證一致。
- 不套用寫入作業:交易嘗試的異動不會提交至資料庫。
- 資料列一致性:觸發錯誤的資料列不存在 (或現有狀態),與交易內執行的讀取作業一致。
您隨時可以取消 Spanner 中的非同步讀取作業,不會影響同一交易中其他進行中的作業。如果取消較高層級的作業,或決定根據初始結果中止讀取,這項彈性功能就非常實用。
不過,請務必瞭解,要求取消讀取作業不保證會立即終止。取消要求後,讀取作業仍可能:
- 成功完成:讀取作業可能會在取消生效前完成處理並傳回結果。
- 因其他原因失敗:讀取作業可能因其他錯誤而終止,例如取消。
- 傳回不完整的結果:讀取作業可能會傳回部分結果,這些結果會在交易提交程序中進行驗證。
取消修訂作業會取消整個交易,除非交易已修訂或因其他原因失敗。
完整性、一致性、耐用性
除了隔離之外,Spanner 還提供其他 ACID 屬性保證:
- 不可分割性:如果交易的所有作業都順利完成,或完全沒有完成,則視為不可分割。如果交易中的任何作業失敗,整個交易就會復原至原始狀態,確保資料完整性。
- 一致性:交易必須維護資料庫規則和限制的完整性。交易完成後,資料庫應處於有效狀態,並遵守預先定義的規則。
- 耐用性:提交交易後,變更會永久儲存在資料庫中,即使發生系統故障、停電或其他中斷情形,變更仍會保留。
效能
本節說明會影響讀寫交易效能的問題。
鎖定並行控制
根據預設,Spanner 允許在預設的可序列化隔離層級中,多個用戶端同時與同一個資料庫互動。為了在這些並行交易中維持資料一致性,Spanner 採用鎖定機制,同時使用共用鎖定和獨占鎖定。這些讀取鎖定只會針對可序列化交易取得,不會針對使用可重複讀取隔離的交易取得。
可序列化交易執行讀取作業時,Spanner 會取得相關資料的共用讀取鎖定。這些共用鎖定可讓其他並行讀取作業存取相同資料。這項並行作業會持續進行,直到交易準備提交變更為止。
在可序列化隔離中,寫入作業會在修訂階段套用,交易則會嘗試將鎖定升級為獨占鎖定。為此,Spanner 會執行下列操作:
- 封鎖受影響資料的所有新共用讀取鎖定要求。
- 等待該資料的所有現有共用讀取鎖定釋出。
- 清除所有共用讀取鎖定後,系統會設定專屬鎖定,在寫入期間授予資料的唯一存取權。
相較之下,Spanner 的可序列化隔離搭配開放式並行,以及可重複讀取隔離搭配開放式並行,都不會在交易執行期間取得鎖定。提交時,交易會取得寫入資料的專屬鎖定。如果並行交易也將寫入內容提交至相同資料,則交易可能需要等待鎖定。
在悲觀並行可重複讀取隔離模式中,系統會針對使用 FOR UPDATE 或 lock_scanned_ranges=exclusive 提示的查詢所讀取的資料,以及使用 DML 查詢寫入的資料,取得獨占鎖。因此,在提交時不需要取得其他鎖定。
鎖定的相關注意事項:
- 精細程度:Spanner 會在資料列和資料欄層級套用鎖定。也就是說,如果交易
T1持有資料列albumid的資料欄A鎖定,交易T2仍可同時寫入同一資料列albumid的資料欄B,不會發生衝突。 寫入但不讀取:
- 如果交易中沒有讀取作業,Spanner 可能不需要對沒有讀取作業的寫入作業進行獨占鎖定。而是使用寫入者共用鎖定。這是因為不含讀取的寫入作業套用順序是由修訂版本時間戳記決定,因此多個寫入器可以同時對同一個項目執行作業,不會發生衝突。只有在交易先讀取要寫入的資料時,才需要獨占鎖定。
- 在可重複讀取隔離模式中,交易通常會在提交時取得寫入儲存格的專屬鎖定。
資料列查詢的次要索引:在可序列化隔離中,在讀寫交易中執行讀取時,使用次要索引可大幅提升效能。使用次要索引將掃描的資料列限制在較小的範圍內,Spanner 鎖定的資料表資料列就會減少,進而提高該特定範圍外資料列的並行修改量。
外部資源專屬存取權:Spanner 的內部鎖定機制旨在確保 Spanner 資料庫本身的資料一致性。請勿使用這些機制,確保 Spanner 外部資源的專屬存取權。Spanner 可能會因各種原因而取消交易,包括內部系統最佳化,例如跨運算資源移動資料。如果重試交易 (由應用程式程式碼明確重試,或由 Spanner JDBC 驅動程式等用戶端程式庫隱含重試),則只有在成功嘗試修訂期間,才能保證鎖定。
鎖定統計資料:如要診斷及調查資料庫中的鎖定衝突,請使用鎖定統計資料自我檢查工具。
鎖死偵測
Spanner 會偵測多筆交易是否可能發生死結,並強制終止其中一筆交易以外的所有交易。請考慮以下情境:Txn1 持有記錄 A 的鎖定,並等待記錄 B 的鎖定,而 Txn2 持有記錄 B 的鎖定,並等待記錄 A 的鎖定。如要解決這個問題,其中一項交易必須取消,釋出鎖定,讓另一項交易繼續進行。
Spanner 使用標準的 wound-wait 演算法偵測死結。Spanner 會在背景追蹤每個要求衝突鎖定的交易時間長度。可讓較舊的交易取消較新的交易。較舊的交易是指最早讀取、查詢或提交的時間較早。
Spanner 會優先處理較舊的交易,確保每筆交易在達到一定時間後,都能取得鎖定。舉例來說,如果較舊的交易需要寫入者共用鎖定,則可取消持有讀取者共用鎖定的較新交易。
分散式執行
Spanner 可以在多個伺服器上執行資料交易,但與單一伺服器交易相比,這項功能會產生效能成本。
哪些類型的交易可能會分散?Spanner 可將資料庫資料列的責任分配給多部伺服器。一般來說,資料列及其對應的交錯資料表資料列會由同一部伺服器提供,同一資料表中具有相近索引鍵的兩個資料列也是如此。Spanner 可以在不同伺服器的資料列之間執行交易。不過,一般來說,影響許多共置資料列的交易,會比影響分散在資料庫或大型資料表中許多資料列的交易更快、更便宜。
Spanner 中最有效率的交易,只包含應以不可分割方式套用的讀取和寫入作業。如果所有讀取和寫入作業都存取鍵空間相同部分的資料,交易速度最快。
唯讀交易
除了鎖定讀寫交易外,Spanner 還提供唯讀交易。
當您需要在同一個時間戳記執行超過一個讀取作業時,請使用唯讀交易。如果您可以使用 Spanner 的單一讀取方法之一來表示讀取作業,則應改用該單一讀取方法。使用這種單一讀取呼叫的效能,與在唯讀交易中進行單一讀取的效能應大致相等。
如果您要讀取大量資料,建議使用分區平行讀取資料。
由於唯讀交易不會寫入,因此不會保留鎖定,也不會封鎖其他交易。唯讀交易會觀察交易修訂記錄中一致的前置字串,讓應用程式永遠取得一致的資料。
介面
Spanner 提供介面,可在唯讀交易的環境中執行工作,並在交易取消時重試。
範例
以下範例說明如何使用唯讀交易,在相同時間戳記取得兩次讀取的一致資料:
C++
C#
Go
Java
Node.js
PHP
Python
小茹
語意
本節說明唯讀交易的語意。
快照唯讀交易
在 Spanner 中執行唯讀交易時,系統會在單一邏輯時間點執行所有讀取作業。這表示唯讀交易和任何其他並行讀取器和寫入器,都會在該特定時刻看到一致的資料庫快照。
相較於鎖定讀寫交易,這些快照唯讀交易提供更簡單的方法,可確保讀取作業的一致性。原因如下:
- 不鎖定:唯讀交易不會取得鎖定。而是選取 Spanner 時間戳記,並對該歷來版本的資料執行所有讀取作業。由於不使用鎖定,因此不會封鎖並行讀寫交易。
- 不中止:這類交易絕不會中止。如果所選讀取時間戳記遭到垃圾收集,則可能會失敗,但 Spanner 的預設垃圾收集政策通常足夠寬鬆,因此大多數應用程式不會遇到這個問題。
- 不提交或復原:唯讀交易不需要呼叫
sessions.commit或sessions.rollback,且實際上會禁止呼叫。
如要執行快照交易,用戶端會定義時間戳記繫結,指示 Spanner 如何選取讀取時間戳記。時間戳記繫結類型包括:
- 強讀取:這類讀取可確保您能看到讀取開始前提交的所有交易效果。單一讀取作業中的所有資料列都保持一致。不過,強式讀取無法重複執行,但強式讀取會傳回時間戳記,且在相同時間戳記再次讀取時可重複執行。由於並行寫入,兩個連續的強式唯讀交易可能會產生不同的結果。變更串流的查詢必須使用這個繫結。詳情請參閱 TransactionOptions.ReadOnly.strong。
- 確切過時:這個選項會以您指定的時間戳記執行讀取作業,可以是絕對時間戳記,也可以是相對於目前時間的過時時間長度。這可確保您觀察到截至該時間戳記為止,全球交易記錄的一致前置字串。讀取作業會等待任何可能在讀取時間戳記或之前修訂的衝突交易完成。雖然速度比有界限過時模式稍快,但可能會傳回較舊的資料。詳情請參閱 TransactionOptions.ReadOnly.read_timestamp 和 TransactionOptions.ReadOnly.exact_staleness。
- 有界過時:Spanner 會在您定義的過時限制內,選取最新的時間戳記,讓最接近的可用副本提供讀取服務,而不會遭到封鎖。傳回的所有資料列都一致。與強式讀取一樣,有界限過時讀取無法重複,因為即使界限相同,不同的讀取作業也可能在不同的時間戳記執行。這類讀取作業分為兩個階段 (時間戳記協商,然後讀取),通常比精確過時讀取作業稍慢,但通常會傳回較新的結果。這種模式僅適用於單次使用的唯讀交易,因為時間戳記協商必須事先知道讀取作業存取的資料列。詳情請參閱 TransactionOptions.ReadOnly.max_staleness 和 TransactionOptions.ReadOnly.min_read_timestamp。
精確和有界限的過時讀取都會在最接近的可用副本執行。如果該副本未趕上讀取時間戳記,則必須先與領導者副本通訊,才能提供讀取。有界限過時讀取較不需要與領導者通訊,因為 Spanner 會挑選副本已可提供的時間戳記。
分區 DML 交易
您可以使用分區 DML 執行大規模 UPDATE 和 DELETE 陳述式,不會遇到交易限制或鎖定整個資料表。Spanner 的做法是將鍵空間分區,並在個別讀寫交易中,對每個分區執行 DML 陳述式。
如要使用非分區 DML,請在程式碼中明確建立的讀寫交易中執行陳述式。詳情請參閱「使用 DML」。
介面
Spanner 提供 TransactionOptions.partitionedDml 介面,用於執行單一分區 DML 陳述式。
範例
下列程式碼範例會更新 Albums 資料表的 MarketingBudget 資料欄。
C++
您可以使用 ExecutePartitionedDml() 函式執行分區 DML 陳述式。
C#
您可以使用 ExecutePartitionedUpdateAsync() 方法執行分區 DML 陳述式。
Go
您可以使用 PartitionedUpdate() 方法執行分區 DML 陳述式。
Java
您可以使用 executePartitionedUpdate() 方法執行分區 DML 陳述式。
Node.js
您可以使用 runPartitionedUpdate() 方法執行分區 DML 陳述式。
PHP
您可以使用 executePartitionedUpdate() 方法執行分區 DML 陳述式。
Python
您可以使用 execute_partitioned_dml() 方法執行分區 DML 陳述式。
小茹
您可以使用 execute_partitioned_update() 方法執行分區 DML 陳述式。
下列程式碼範例會根據 SingerId 資料欄,從 Singers 資料表刪除資料列。
C++
C#
Go
Java
Node.js
PHP
Python
小茹
語意
本節說明分區 DML 的語意。
瞭解分區 DML 執行
無論是使用用戶端程式庫方法或 Google Cloud CLI,一次只能執行一個分區 DML 陳述式。
分區交易不支援修訂或復原。Spanner 會立即執行並套用 DML 陳述式。如果您取消作業,或作業失敗,Spanner 會取消所有執行中的分區,且不會啟動任何剩餘的分區。不過,Spanner 不會復原已執行的分區。
分區 DML 鎖定擷取策略
為減少鎖定爭用情形,分區 DML 只會對符合 WHERE 子句的資料列取得讀取鎖定。每個分區使用的獨立交易較小,因此鎖定時間也較短。
舊讀取時間戳記和版本垃圾收集
Spanner 會執行版本垃圾收集,收集已刪除或覆寫的資料,並回收儲存空間。根據預設,系統會回收超過一小時的資料。Spanner 無法讀取早於設定 VERSION_RETENTION_PERIOD 的時間戳記,預設值為一小時,但最多可設為一週。如果讀取作業在執行期間過舊,就會失敗並傳回 FAILED_PRECONDITION 錯誤。
變更串流查詢
變更串流是一種結構定義物件,可設定用來監控整個資料庫、特定資料表,或資料庫中定義的一組資料欄的資料修改。
建立變更串流時,Spanner 會定義對應的 SQL 資料表值函式 (TVF)。您可以使用這個 TVF,透過 sessions.executeStreamingSql 方法查詢相關聯變更串流中的變更記錄。TVF 的名稱是根據變更串流的名稱產生,且一律以 READ_ 開頭。
變更串流 TVF 的所有查詢都必須使用 sessions.executeStreamingSql API,在單次使用的唯讀交易中執行,並具有強式唯讀 timestamp_bound。異動串流 TVF 可讓您指定時間範圍的 start_timestamp 和 end_timestamp。您可以使用這個強大的唯讀 timestamp_bound,存取保留期限內的所有變更記錄。所有其他 TransactionOptions 對變更串流查詢均無效。
此外,如果 TransactionOptions.read_only.return_read_timestamp 設為 true,則描述交易的 Transaction 訊息會傳回 2^63 - 2 的特殊值,而非有效的讀取時間戳記。請捨棄這個特殊值,不要用於後續查詢。
詳情請參閱「變更串流查詢工作流程」。
閒置交易
如果交易沒有未完成的讀取或 SQL 查詢,且在過去 10 秒內未啟動任何讀取或 SQL 查詢,則視為閒置。Spanner 可以取消閒置交易,避免交易無限期保留鎖定。如果閒置交易遭到取消,提交作業就會失敗,並傳回 ABORTED 錯誤。在交易中定期執行小型查詢 (例如 SELECT 1),可避免交易閒置。
後續步驟
- 進一步瞭解 Spanner 隔離等級。