


借助 Knowledge Catalog 上下文集,您可以将数据架构、语义定义和经过验证的查询句式打包到有边界的特定领域知识容器中。您可以使用这些容器,让 Gemini Enterprise 和自定义代理等自主 AI 应用以经过验证的领域知识为依据。
本文档面向希望了解上下文集如何为 AI 智能体构建领域知识的数据架构师、治理主管和 AI 工程师。如需立即创建和填充上下文集,请参阅管理上下文集。
什么是上下文集?
上下文集是一种专用的 Knowledge Catalog 条目组 (type="context-set"),它是元数据条目和知识文档的逻辑容器。每个上下文集都封装了一组自成一体的语义信息和数据资产引用,适用于特定的分析领域和 AI 智能体。
在此容器中,知识被整理为条目,这些条目代表具体的业务概念、数据资产或文档(例如指南、HowTo 和参考资料)。这些条目通过方面进行丰富,这些方面是模块化元数据属性,用于存储业务术语、SQL 模板和 Markdown 文档等特定详细信息。
下图展示了 AI 智能体如何查询上下文集,包括其根索引、网域条目、切面和引用的数据资产:
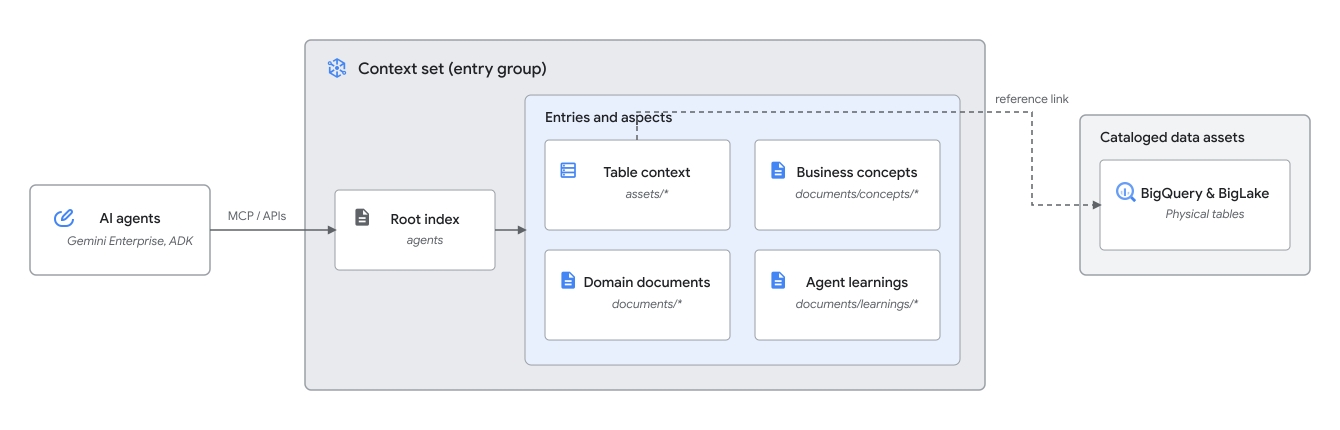
如果强制智能体搜索整个企业目录,不仅会增加延迟、浪费提示词元,还可能导致回答出现幻觉。而上下文集则可以建立封闭的、限定于特定领域的知识容器,让智能体能够以极高的精确度进行查询。
由于上下文集充当管理容器,因此您可以按项目所有权整理元数据,并一次性对所有捆绑条目应用 Identity and Access Management (IAM) 访问权限控制政策,而无需单独配置权限。如需详细了解条目组、条目和切面,请参阅元数据管理简介。
AI 智能体接地要求
随着组织部署自主 AI 智能体(例如 Gemini Enterprise、Antigravity 和自定义智能体开发套件智能体)来编排数据工作流并生成分析,智能体需要可靠的建立依据:
- 语义定义:特定列或指标在业务术语中意味着什么?
- 经过验证的查询句式:领域专家如何成功查询和联接这些表?
- 运营规则:哪些业务政策、例外条件和标准运营规程 (SOP) 用于管理这些数据?
如何填充上下文集
您可以通过运行自主丰富任务来分析架构、查询日志和知识信号,从而填充上下文集中的条目。如需了解详情,请参阅创建丰富任务。
由于上下文集是一种专用条目组 (type="context-set"),因此您还可以使用 Google Cloud CLI、客户端库或 Dataplex API 以编程方式创建和更新其条目。如需了解详情,请参阅管理条目并注入自定义来源。
上下文集条目类型和结构
上下文集中的条目使用文档 (projects/dataplex-types/locations/global/entryTypes/document) 或查询模板 (projects/dataplex-types/locations/global/entryTypes/query-template) 系统条目类型、分层条目 ID 以及基于其存储的知识的元数据方面。以下部分介绍了条目结构以及为 AI 智能体提供依据的核心条目类别。
自动丰富代理条目结构
当扩充任务填充上下文集时,扩充代理会使用文档系统条目类型 (projects/dataplex-types/locations/global/entryTypes/document) 以及必需的 document 和 overview 切面创建其生成的条目。智能体会使用斜杠分隔 (/) 的条目 ID 将这些生成的条目整理成渐进式披露层次结构,并使用 document.type 字段区分每个条目的角色:
| 条目类别 | 条目 ID 格式 | 生成来源和附加的元数据 |
|---|---|---|
| 上下文集根索引 | agents (固定系统 ID) |
|
| 目录索引 |
|
|
| 数据资产 |
|
|
| 业务概念 | documents/concepts/CONCEPT_ID(智能体生成的标识名) |
|
| 智能体自主学习 | documents/learnings/LEARNING_SLUG(智能体生成的标识名) |
|
| 网域文档 |
|
|
下图展示了丰富上下文集 (thelook-context) 如何在 agents 根索引 (context-set) 下组织其条目。导航目录层级 (knowledge-base-index) 将表上下文条目(table-context,附带 SQL 查询计数)分组到 assets/bigquery/cymbal-style/thelook/* 下,并将网域指南 (knowledge-base) 和业务术语 (concept) 分组到 documents/* 下:

除了由丰富任务生成的 Document 条目之外,上下文集还可以包含通过 Google Cloud CLI、客户端库或 Dataplex API 以编程方式创建的独立 Query Template (projects/dataplex-types/locations/global/entryTypes/query-template) 条目。当扩充任务在包含经过认证的查询模板条目的上下文集上运行时,扩充代理会保留这些条目,而不会修改或删除它们。如需了解详情,请参阅本文档的“查询模板”部分。
数据资源
数据资产条目(document.type: "table-context",位于 assets/bigquery/PROJECT_ID/DATASET_ID/TABLE_ID)会捕获特定表的网域专用说明、列注意事项、联接提示和经过验证的 SQL 示例,而不会覆盖 BigQuery 中物理表的说明。每个数据资产条目都通过有向 reference 条目链接 (projects/dataplex-types/locations/global/entryLinkTypes/reference) 链接到其目标目录资产。
资源表示形式示例:
name: projects/cymbal-style/locations/us-central1/entryGroups/online-apparel-store/entries/assets/bigquery/cymbal-style/store/orders
entryType: projects/dataplex-types/locations/global/entryTypes/document
aspects:
  dataplex-types.global.document:
    type: "table-context"
  dataplex-types.global.overview:
    content: "## Orders table context\nJoin `store.orders` to `store.returns` on `order_id` when calculating net sales..."
业务概念
业务概念条目(document.type: "concept",位于 documents/concepts/CONCEPT_ID)定义了标准化的业务术语、领域指标、首字母缩写词和计算公式。
主要功能包括:
- 术语一致性:消除业务部门和分析团队之间的术语歧义。
- KPI 公式:提供特定领域关键绩效指标 (KPI) 的数学公式和逻辑。
- 有针对性的素材资源关联:使用
reference条目链接关联到相关表格,以便智能体了解概念的应用场景。
例如,在电子商务上下文集中,documents/concepts/net-items-sold 处的条目指定了确切的净售出单位数计算。当智能体收到询问“售出商品净数量”的提示时,它会参考概念条目来应用经过验证的计算,而不是自行创建 SQL 逻辑。
资源表示形式示例:
name: projects/cymbal-style/locations/us-central1/entryGroups/online-apparel-store/entries/documents/concepts/net-items-sold
entryType: projects/dataplex-types/locations/global/entryTypes/document
aspects:
  dataplex-types.global.document:
    type: "concept"
  dataplex-types.global.overview:
    content: "Calculates the absolute number of items sold minus customer returns in a given time period."
文档和自学规则
文档条目(documents/* 下的 document.type: "knowledge-base" 或 "learning")以结构化 Markdown(document 和 overview 切面)存储叙述性和程序性上下文。
主要功能包括:
- 标准操作程序 (SOP):直接在目录中捕获 SOP、Runbook 核对清单和新手入门指南。
- 合规性政策:记录合规性政策、监管限制(例如 GDPR 或 HIPAA 处理规则)和例外情况标准。
- 智能体自学:捕获从下游智能体对话轨迹中提取的隐性规则和消除歧义 (
documents/learnings/LEARNING_SLUG)。
例如,服装上下文集包含 documents/policies/return-policy-rules,用于指示代理在计算标准退货率时如何排除已完成的销售和运输途中损坏的商品。
资源表示形式示例:
name: projects/cymbal-style/locations/us-central1/entryGroups/online-apparel-store/entries/documents/policies/return-policy-rules
entryType: projects/dataplex-types/locations/global/entryTypes/document
aspects:
  dataplex-types.global.document:
    type: "knowledge-base"
  dataplex-types.global.overview:
    content: "## Return Policy Rules\nItems marked FINAL_SALE or DAMAGED_IN_TRANSIT are excluded from return rates..."
查询模板
您还可以将 queries 方面附加到数据资产条目,或在上下文集中以编程方式创建专用查询模板 (projects/dataplex-types/locations/global/entryTypes/query-template) 条目,以存储映射到自然语言问题(dataplex-types.global.query-template 方面)的经过验证的参数化 SQL 查询。
主要功能包括:
- 预先验证的查询:存储映射到分析
intent和示例自然语言问题 (nlQuery) 的已验证联接路径、过滤条件和聚合模式。 - 运行时参数化:支持带类型参数占位符(例如
@season和@limit),并提供说明和示例值 (sampleValues),以便动态执行代理。 - 多引擎支持:指定目标
sourceType(例如BIGQUERY、SPANNER、ALLOYDB、CLOUD_SQL或LOOKER)和可选的sourceDialect(GOOGLE_SQL、POSTGRESQL、MYSQL或LOOKER_QUERY)。
资源表示形式示例:
name: projects/cymbal-style/locations/us-central1/entryGroups/online-apparel-store/entries/queries/top-categories-by-season
entryType: projects/dataplex-types/locations/global/entryTypes/query-template
aspects:
  dataplex-types.global.query-template:
    intent: "Identify top-performing product categories by revenue for a given season."
    nlQuery: "Which ecommerce product categories performed best in winter?"
    query: "SELECT category, SUM(revenue) FROM store.orders WHERE fiscal_season = @season GROUP BY category ORDER BY 2 DESC LIMIT @limit"
    sourceType: "BIGQUERY"
    sourceDialect: "GOOGLE_SQL"
    parameters:
      - name: "season"
        type: "STRING"
        sampleValues:
          - "WINTER"
      - name: "limit"
        type: "NUMBER"
        sampleValues:
          - "5"
示例:在线服装店上下文集
为了展示上下文集中的条目如何协同工作,我们以一家在线服装零售商为例,该零售商为商店商品策划人员部署了一个 AI 助理。如果没有限定上下文,智能体可能会查询原始暂存表,或者在统计热门商品时未扣除客户退货,导致统计结果不准确。
为了让代理能够提供依据,数据监管员创建并丰富了一个名为 online-apparel-store 的上下文集:
EntryGroup: projects/cymbal-style/locations/us-central1/entryGroups/online-apparel-store
(EntryGroup.type = "context-set")
│
├── agents (document.type = "context-set")
│     Root directory index for AI agents consulting the context set
│
├── assets/bigquery/cymbal-style/store/* (document.type = "table-context")
│   ├── assets/bigquery/cymbal-style/store/orders
│   │     Linked using entryLinkTypes/reference -> @bigquery .../tables/orders
│   ├── assets/bigquery/cymbal-style/store/products
│   │     Linked using entryLinkTypes/reference -> @bigquery .../tables/products
│   └── assets/bigquery/cymbal-style/store/returns
│         Linked using entryLinkTypes/reference -> @bigquery .../tables/returns
│
├── documents/concepts/* (document.type = "concept")
│   ├── documents/concepts/net-items-sold
│   │     Formula: SUM(orders.quantity) - SUM(returns.quantity)
│   └── documents/concepts/bestseller
│         Definition: Any clothing item with >= 500 net units sold within a 30-day window
│
├── documents/policies/* (document.type = "knowledge-base")
│   └── documents/policies/return-policy-rules
│         Markdown SOP: Exclude items marked 'FINAL_SALE' or 'DAMAGED_IN_TRANSIT' from standard return rates
│
└── documents/learnings/* (document.type = "learning")
    └── documents/learnings/winter-season-date-filter
          Learned rule: Filter winter season queries using fiscal_season = 'WINTER'
智能体如何解析提示
当商品策划人员询问智能体“不包括因损坏而退货的商品,我们最畅销的 5 款冬季夹克是什么?”时,智能体会通过上下文集解析提示:
根索引和概念查找:智能体读取
agents根索引,并检查documents/concepts/net-items-sold和documents/concepts/bestseller,以确认必须从总订单数量中减去退货商品。SOP 和学习强制执行:智能体读取
documents/policies/return-policy-rules和documents/learnings/winter-season-date-filter,并添加过滤条件WHERE return_reason != 'DAMAGED_IN_TRANSIT'和fiscal_season = 'WINTER'。表上下文和联接验证:使用
assets/bigquery/cymbal-style/store/*处的数据资产条目及其指向底层@bigquery表的reference条目链接,代理使用经过验证的外键联接store.orders、store.products和store.returns,并运行 SQL 查询。
架构能力
上下文集为企业数据环境提供了多项核心功能:
封闭式执行边界:通过将上下文限定在一组精选资产和语义条目中,智能体可以在封闭式沙盒中运行。此边界可消除无关的目录噪声,有助于确保确定性评估,并最大限度地减少 token 使用量。
快速上传和批量索引编制:团队可以将一组概念、查询和文档作为一个原子操作进行上传和索引编制,从而与持续集成和部署 (CI/CD) 流水线集成。
零复制打包:Context 可设置软件包元数据和关系,而无需复制或移动底层数据存储区,从而避免冗余存储费用和数据同步延迟。
智能体咨询模式
下游智能体通过 Model Context Protocol (MCP) 或直接通过 Knowledge Catalog API 使用上下文集。如需了解详情,请参阅检索数据资产的上下文。
为了优化响应延迟时间并最大限度地减少 token 消耗,智能体遵循渐进式披露咨询层次结构:
根索引和搜索查询匹配:代理会检查
agents根索引以及附加到数据资产条目的任何queries方面。如果经过验证的 SQL 示例与用户的意图匹配,代理会调整查询并直接运行。这种匹配方式可提供快速响应,同时最大限度地降低查询错误的风险。表上下文和架构组装:如果没有完全匹配的查询示例,智能体会读取数据资产条目 (
assets/*) 及其schema方面,以了解实体关系并构建多表 SQL 语句。文档和概念咨询:对于不明确的极端情况(例如会计日历截止日期或争议排除),代理会阅读概念 (
documents/concepts/*)、学习 (documents/learnings/*) 和知识库 (documents/*) 条目,以应用业务规则。如果上下文集条目中的定义与业务术语库术语中的定义冲突,则使用方智能体会优先考虑上下文集定义。
在生成式 AI 应用中使用上下文
生成式 AI 应用使用精选上下文集来理解企业领域语义、浏览复杂架构并生成可靠的 SQL,而不会出现幻觉。应用通常通过两种主要模式使用这些上下文集:
动态上下文发现:在对话式或自助式分析环境中,用户会使用自然语言提出临时问题。应用会动态评估用户的意图,以识别并从 Knowledge Catalog 中检索最相关的上下文集,并将检索到的领域知识注入到活跃提示中。
如需在 Knowledge Catalog 上下文中锚定 Gemini Enterprise 应用,请在 Gemini Enterprise 应用中以联合查询模式配置 BigQuery 数据连接器,并验证 Gemini Enterprise 助理设置中的启用 Knowledge Catalog 切换开关是否已开启。如需了解详情,请参阅连接到 BigQuery 和连接到 Knowledge Catalog。
如果用户有权访问多个包含类似表的 Google Cloud 项目,请在自定义技能或 Gemini Enterprise 的其他 LLM 系统指令字段中指定目标项目 ID 和数据集名称,以便将查询范围限定为预期数据集。如需了解详情,请参阅配置助理。
预配置的上下文集:对于专用智能体应用,您可以在智能体的系统指令或工具配置中指定其条目组资源名称 (
projects/PROJECT_ID/locations/LOCATION/entryGroups/CONTEXT_SET_ID),从而为智能体预配置显式上下文集引用。然后,智能体可以读取entries/agents根索引,并使用ListEntries、LookupEntry或lookupContext直接从该上下文集中检索条目,而无需进行广泛的目录搜索。随着周期性丰富工作流不断优化上下文集,智能体也会自动提升质量。为了优化这些丰富和自学习功能,我们建议在 Gemini Enterprise 应用中指定 Gemini 3.8 Flash 或更高版本的模型。如需详细了解模型选择步骤,请参阅在 Agent Studio 中设计代理中的“使用 flow builder 创建代理”部分。
上下文集与相关构造的比较
如需为您的架构选择合适的元数据结构,请将 Knowledge Catalog 上下文集与相关平台功能进行比较:
| Construct | 主要目的 | 范围和结构 | 打包内容 | 何时使用 |
|---|---|---|---|---|
| Knowledge Catalog 上下文集 | 在封闭的网域沙盒中为分析型 AI 智能体建立依据。 | 限定于业务网域的有界条目组 (type="context-set")。 |
数据资产条目(包含架构和 SQL 查询切面)、业务概念、Markdown SOP 和自学规则。 | 在基于 BigQuery 和湖仓一体资产构建或接地分析 AI 智能体(例如 Gemini Enterprise 或 ADK 智能体)时使用。 |
| 上下文图表 | 直观呈现并遍历整个组织的实时语义拓扑。 | 开放式交互图谱,涵盖所有已编入目录的条目和条目链接。 | 物理数据资产、业务术语库、数据产品、上下文集和沿袭边缘。 | 在新对话中以交互方式发现资产并跟踪多跃点关系时使用。 |
| 数据库上下文集 (QueryData) | 针对操作型数据库优化自然语言转 SQL (NL2SQL) 的转换。 | 专为事务数据库架构量身定制的条目组 (type="context-set")。 |
适用于 AlloyDB for PostgreSQL、Cloud SQL 和 Spanner 的黄金 SQL 查询模板、架构元数据和过滤分面。 | 当直接在运营型事务数据库上建立对话式 SQL 体验时,请使用此选项。 |
| 数据产品 | 在组织团队之间共享和治理物理数据资产。 | 具有数据协定、SLA 和数据平面访问权限控制的受治理资产包。 | 具体的 BigQuery 表、视图、Cloud Storage 存储桶和数据流。 | 在打包精选数据集并向跨团队使用者授予数据平面访问权限时使用。 |
上下文集与上下文图表的比较
上下文图和上下文集是两个独立的结构,在 Knowledge Studio 架构中扮演着不同的角色:
上下文图:整个组织的实时、全面的语义拓扑。它将底层数据资产、业务术语库术语和互动轨迹关联起来。您可以在 Knowledge Studio 中以交互方式探索和遍历此开放图谱。如需了解详情,请参阅在 Knowledge Studio 中探索数据资产。
情境集:一个有界限、经过精选的打包单元。它会提取特定领域的知识子集,并将其密封打包到条目组 (
type="context-set") 中,供下游 AI 智能体通过 Model Context Protocol (MCP) 进行查询。上下文集在更广泛的上下文图中充当一个紧密、高密度的子图。如需了解详情,请参阅 Knowledge Catalog 中的 MCP 服务器简介。
Knowledge Catalog 上下文集与数据库上下文集的比较
Knowledge Catalog 和 Google Cloud 操作型数据库都使用术语“上下文集”来指代为生成式 AI 模型提供依据的精选信息。
虽然这两种变体都采用相同的基础架构(它们以原生方式存储为 Knowledge Catalog 上下文集,即具有 type="context-set" 的可扩展条目组,并使用标准 Knowledge Catalog API),但它们针对的是企业数据堆栈的不同层:
- 数据库上下文集 (QueryData):专为运营型事务数据库(例如 AlloyDB for PostgreSQL、Cloud SQL 和 Spanner)而构建。这些上下文集针对 SQL 配置进行了深度优化。它们捆绑了黄金查询模板、架构元数据和过滤分面,专用上下文工程智能体会评估这些内容,以在操作运行时改进自然语言到 SQL (NL2SQL) 的转换。
- Knowledge Catalog 上下文集 (Knowledge Studio):专为分析数据资产(例如 BigQuery、数据湖仓一体和 Knowledge Catalog 数据产品)而构建。这些上下文集将更广泛的多模态知识打包到多个条目类别中,包括数据资产条目、业务概念、Markdown 文档 Wiki 和自学规则。这些数据通过 Knowledge Studio 丰富工作流进行整理,并通过 Model Context Protocol (MCP) 提供给下游分析智能体。
上下文集与数据产品的比较
了解上下文集如何与 Knowledge Catalog 数据产品交互,有助于您建立清晰的数据和 AI 治理边界。如需了解详情,请参阅数据产品简介。
数据产品管理底层资源:数据产品安全地捆绑 BigQuery 表、存储桶和流等具体资源,为数据共享、数据协定和数据平面访问权限控制建立主要单元。
上下文集捆绑了对话语义:上下文集不授予数据访问权限,而是捆绑了 AI 智能体和人类理解数据所需的领域知识,例如概念、查询模板和文档。数据管家可以通过在数据产品的
additional_context引用中声明上下文集,将其与数据产品关联。
企业安全与治理
上下文集与 Google Cloud 安全和治理控制措施集成,有助于保护敏感的企业元数据:
上下文集 IAM 角色:由于上下文集通常包含敏感的语义信息,因此访问权限由应用于项目或直接应用于
context-set条目组的专用 IAM 角色控制。此控件可让您按地理区域和网域所有权整理精选知识。如需了解详情,请参阅管理上下文集中的“所需角色”部分。零复制底层数据安全性:向代理授予对上下文集的访问权限后,代理可以读取语义元数据和查询模板,但不会绕过对底层表的访问权限控制。如需对 BigQuery 运行 SQL 查询或读取 Cloud Storage 中的文件,运行查询的身份必须对这些底层资源拥有所需的数据平面 IAM 权限。
人机协同治理:当自主 Knowledge Studio 扩充任务从操作日志中提取新概念、SOP 或查询模板时,这些提案会作为可审核的变更请求进行暂存。数据监管者在批准对生产上下文集的更改之前,会检查差异比较和评估分数。如需详细了解提案审核,请参阅评估和批准丰富提案。
用户管理的执行身份:填充上下文集的自动化丰富任务在用户代管式服务账号下运行,该服务账号由 Dataplex Service Agent 通过 Service Account Token Creator (
roles/iam.serviceAccountTokenCreator) 角色模拟。
预览范围和边界
在预览版期间,上下文集在以下范围内运行:
单区域范围:单区域上下文集(例如
us-central1)必须与其打包的素材资源所在的区域保持一致。多区域(例如us或eu)和global上下文集可以引用兼容区域中的资产;为多区域或global上下文集配置丰富化任务时,您需要为该任务选择一个执行区域。每个上下文集只能关联一个丰富化任务:每个上下文集只能关联一个丰富化任务。
跨上下文集引用:不支持从一个上下文集内引用另一个上下文集中的条目子集。
编写和使用界面:您可以通过 Google Cloud 控制台中的 Knowledge Studio 或以编程方式作为条目组 (
type="context-set") 来创建和管理上下文集。您可以通过 Knowledge Studio 扩充工作流或以编程方式管理条目来填充上下文集。下游 AI 智能体可以使用 Knowledge Catalog API(ListEntries和LookupEntry)和 Model Context Protocol (MCP) 以编程方式发现和查询上下文集。如需了解详情,请参阅 Knowledge Catalog 中的 MCP 服务器简介。共享配额:由于上下文集本质上是专用条目组 (
type="context-set"),因此它们会与标准 Knowledge Catalog 条目组使用和共享相同的资源配额。如需了解详情,请参阅配额和限制。
价格
上下文集存储为标准 Knowledge Catalog 条目组以及自定义条目和切面。空的上下文集条目组或未经批准的丰富化批处理更改请求不会产生元数据存储费用。在上下文集中创建条目时(例如,当您批准丰富化变更请求或直接创建条目时),标准 Knowledge Catalog 元数据存储费用将应用于托管条目组的项目。
在预览版期间,运行丰富任务和暂存未经批准的批量更改请求免费。当扩充任务使用可选的客户管理资源(例如用于知识信号或评估集的 Cloud Storage 存储桶,以及用于自学习的 BigQuery Agent Analytics 跟踪表)时,您的项目将产生标准使用费,包括 BigQuery 查询处理和 Cloud Storage 暂存读写。