


Présentation de l'UDM
Ce document offre un aperçu du modèle de données unifié (UDM). Pour en savoir plus sur les champs UDM, y compris une description de chacun d'eux, consultez la liste des champs UDM. Pour en savoir plus sur le mappage de l'analyseur, consultez Champs UDM importants pour le mappage de l'analyseur.
L'UDM est une structure de données standard de Google Security Operations qui stocke des informations sur les données reçues des sources. On l'appelle également le schéma. Google SecOps stocke les données d'origine qu'il reçoit dans deux formats : le journal brut d'origine et un enregistrement UDM structuré. L'enregistrement UDM est une représentation structurée du journal d'origine.
Si un analyseur existe pour le type de journal spécifié, le journal brut est utilisé pour créer un enregistrement UDM. Les clients peuvent également transformer les journaux bruts au format UDM structuré avant d'envoyer les données à Google SecOps à l'aide de l'API Ingestion.
Voici quelques avantages de l'UDM :
- Stocke le même type d'enregistrement de différents fournisseurs en utilisant la même sémantique.
- Il est plus facile d'identifier les relations entre les utilisateurs, les hôtes et les adresses IP, car les données sont normalisées dans le schéma UDM standard.
- Les règles sont plus faciles à écrire, car elles peuvent être indépendantes de la plate-forme.
- Prise en charge plus facile des types de journaux provenant de nouveaux appareils.
Bien que vous puissiez rechercher des événements à l'aide d'une recherche de journaux bruts, une recherche UDM est plus rapide et plus précise en raison de sa spécificité. Google SecOps collecte les données de journaux brutes et stocke les détails du journal des événements dans le schéma UDM. L'UDM fournit un framework complet de milliers de champs pour décrire et catégoriser divers types d'événements, par exemple les événements de processus de point de terminaison et les événements de communication réseau.
Structure UDM
Les événements UDM sont composés de plusieurs sections. La première section de chaque événement UDM est la section des métadonnées. Il fournit une description de base de l'événement, y compris l'horodatage de l'événement et l'horodatage de son ingestion dans Google SecOps. Il inclut également les informations produit, la version et la description. L'analyseur d'ingestion classe chaque événement en fonction d'un type d'événement prédéfini, indépendamment du journal du produit spécifique. Les champs de métadonnées suffisent pour commencer rapidement à rechercher des données.
En plus de la section des métadonnées, d'autres sections décrivent des aspects supplémentaires de l'événement. Si une section n'est pas nécessaire, elle n'est pas incluse, ce qui permet d'économiser de la mémoire.
principal: entité à l'origine de l'activité dans l'événement. Les sections qui font référence à la source (src) et à la destination (target) sont également incluses.intermediary: systèmes par lesquels transitent les événements, comme un serveur proxy ou un relais SMTP.observer: systèmes tels que les analyseurs de paquets qui surveillent passivement le trafic.
Formater un événement UDM
Pour formater un événement UDM afin qu'il soit prêt à être envoyé à Google, vous devez suivre les étapes suivantes :
- Spécifiez le type d'événement : le type d'événement que vous sélectionnez détermine les champs que vous devez également inclure dans l'événement.
- Spécifiez le code temporel de l'événement.
- Spécifier des noms (entités) : chaque événement doit inclure au moins un nom décrivant un appareil ou un utilisateur participant à l'événement.
- Facultatif : Spécifiez le résultat de sécurité : spécifiez les résultats de sécurité en incluant des détails sur les risques et les menaces détectés par un système de sécurité. Incluez les actions spécifiques prises pour atténuer ces risques et menaces.
- Renseignez les autres informations requises et facultatives sur l'événement à l'aide des champs d'événement UDM.
Spécifier le type d'événement
Vous devez toujours spécifier le type d'événement pour chaque événement envoyé au format UDM. Spécifiez cette valeur à l'aide de l'une des valeurs possibles disponibles pour metadata.event_type. Il s'agit de valeurs telles que PROCESS_OPEN, FILE_CREATION, USER_CREATION et NETWORK_DNS (pour obtenir la liste complète, consultez Metadata.event_type). Pour chaque type d'événement, vous devez également renseigner un ensemble d'autres champs et valeurs avec les informations liées à l'événement d'origine.
Pour en savoir plus sur les champs à inclure pour chaque type d'événement, consultez Champs obligatoires et facultatifs pour chaque type d'événement.
L'exemple suivant montre comment spécifier PROCESS_OPEN comme type d'événement à l'aide de la notation textuelle Proto3 :
metadata {
    event_type: PROCESS_OPEN
}
Spécifier le code temporel de l'événement
Vous devez spécifier le code temporel GMT pour tout événement envoyé au format UDM à l'aide de Metadata.event_timestamp. Le tampon doit être encodé à l'aide de l'une des normes suivantes :
- Pour JSON, utilisez le format RFC 3339.
- Code temporel proto3
L'exemple suivant montre comment spécifier le code temporel au format RFC 3339. Dans cet exemple, yyyy-mm-ddThh:mm:ss+hh:mm : année, mois, jour, heure, minute, seconde et décalage par rapport à l'heure UTC. Le décalage par rapport à l'heure UTC est de moins huit heures, ce qui correspond à l'heure PST.
metadata {
  event_timestamp: "2019-09-10T20:32:31-08:00"
}
Spécifier des noms (entités)
Définissez un ou plusieurs noms pour chaque événement UDM. Les noms représentent des participants ou des entités, tels que l'utilisateur qui effectue l'activité, la cible de l'action ou l'appareil de sécurité observant l'événement (par exemple, un proxy de messagerie ou un routeur). Les noms représentent également des objets tels que des URL ou des pièces jointes.
Un événement UDM doit comporter un ou plusieurs des noms suivants :
principal : représente l'entité agissante ou l'appareil à l'origine de l'activité décrite dans l'événement. Le compte principal doit inclure au moins un détail de la machine (nom d'hôte, adresses MAC, adresses IP, port, identifiants spécifiques au produit, comme un GUID de machine CrowdStrike) ou un détail de l'utilisateur (par exemple, un nom d'utilisateur), et éventuellement des détails sur le processus. Il ne doit PAS inclure les champs suivants : "email", "files", "registry keys" ou "values".
Si toutes les activités se déroulent sur une seule machine, décrivez uniquement cette machine dans le bloc principal. Ne dupliquez pas les détails de la machine dans target ou src.
L'exemple suivant montre comment les champs principal peuvent être renseignés :
principal {
  hostname: "jane_win10"
  asset_id: "Sophos.AV:C070123456-ABCDE"
      ip: "10.0.2.10"
      port: 60671
      user {  userid: "john.smith" }
}
Cet exemple fournit des détails sur l'appareil et l'utilisateur qui a été l'acteur principal de l'événement. Il inclut également un identifiant d'élément spécifique au fournisseur (de Sophos), qui est un identifiant unique généré par le produit de sécurité tiers.
target : représente l'appareil ou l'objet référencé par l'événement. Dans une connexion de pare-feu entre l'appareil A et l'appareil B, A est le compte principal et B est la cible. Pour une injection de processus où le processus C injecte dans le processus D, C est le principal et D est la cible.

Principal et cible dans l'UDM
L'exemple suivant illustre la façon dont les champs d'une cible sont renseignés :
target {
   ip: "198.51.100.31"
   port: 80
}
Incluez toutes les autres informations disponibles dans le bloc target, telles que le nom d'hôte, les adresses IP ou adresses MAC supplémentaires et les identifiants d'éléments propriétaires.
principal et target (et d'autres noms) peuvent faire référence à des acteurs sur la même machine. Par exemple, si le processus A (principal) exécuté sur la machine X agit sur le processus B (cible) également sur la machine X, vous décrivez les deux dans leurs blocs respectifs.
src : représente l'objet source sur lequel l'action est effectuée et son contexte, tel que la machine sur laquelle il réside. Par exemple, si l'utilisateur U copie le fichier A de la machine X vers le fichier B de la machine Y, spécifiez à la fois le fichier A et la machine X dans le bloc src.
intermediary : contient des détails sur un ou plusieurs appareils ayant traité l'activité décrite dans l'événement. Cela inclut des informations sur les appareils tels que les serveurs proxy et les relais SMTP.
observer : représente un appareil qui n'est pas un intermédiaire direct, mais qui surveille l'activité et en rend compte. Cela inclut des appareils tels que des analyseurs de paquets ou des outils d'analyse des failles basés sur le réseau.
about : stocke les détails de tous les objets référencés par l'événement qui ne correspondent pas à
participant,src,target,intermediaryouobserver. Utilisez-le pour suivre des éléments tels que :- Pièces jointes aux e-mails
- Domaines/URL/IP intégrés dans le corps de l'e-mail
- DLL chargées lors d'un événement
PROCESS_LAUNCH
Les sections d'entité des événements UDM incluent des informations sur les différents participants (appareils, utilisateurs, objets tels que des URL, des fichiers, etc.) décrits dans l'événement. L'UDM Google Security Operations impose des exigences obligatoires pour renseigner les champs de nom. Ces exigences sont décrites dans la section Champs obligatoires et facultatifs pour chaque type d'événement UDM. L'ensemble des champs d'entité à remplir diffère selon le type d'événement.
Spécifier le résultat de sécurité
Vous pouvez éventuellement spécifier des résultats de sécurité en renseignant les champs SecurityResult, y compris des détails sur les risques et les menaces de sécurité détectés par le système de sécurité, ainsi que les mesures prises pour atténuer ces risques et menaces. Voici quelques exemples de types d'événements liés à la sécurité qui nécessitent de renseigner les champs SecurityResult :
Un pare-feu proxy de sécurité de messagerie a détecté deux pièces jointes infectées (SOFTWARE_MALICIOUS). Il les a mis en quarantaine et désinfectés (QUARANTINE, ALLOW_WITH_MODIFICATION), puis a transféré l'e-mail désinfecté.
Un système SSO a facilité une tentative de connexion qui a entraîné une erreur
AUTH_VIOLATIONet a été bloquée (BLOCK).Un bac à sable de détection des logiciels malveillants a détecté un logiciel espion (
SOFTWARE_MALICIOUS) dans une pièce jointe cinq minutes après que le système a distribué (ALLOW) l'e-mail dans la boîte de réception de l'utilisateur.
Exemples de recherches UDM
Cette section fournit des exemples de recherches UDM qui illustrent certaines des fonctionnalités, capacités et syntaxes de base de la recherche UDM.
Exemple : Rechercher les connexions Microsoft Windows 4624 réussies
La recherche suivante liste les événements de connexion réussie Microsoft Windows 4624, ainsi que la date et l'heure de génération des événements, en fonction de seulement deux champs UDM :
metadata.event_type = "USER_LOGIN" AND metadata.product_event_type = "4624"
Exemple : Rechercher toutes les connexions réussies
La recherche suivante liste tous les événements de connexion réussis, quel que soit le fournisseur ou l'application :
metadata.event_type = "USER_LOGIN" AND security_result.action = "ALLOW" AND
target.user.userid != "SYSTEM" AND target.user.userid != /.*$/
Exemple : Rechercher les connexions utilisateur réussies
L'exemple suivant montre comment rechercher userid "fkolzig" et déterminer quand l'utilisateur associé à cet ID utilisateur s'est connecté. Vous pouvez effectuer cette recherche à l'aide de la section "Cible". La section "target" inclut des sous-sections et des champs décrivant la cible. Par exemple, la cible dans ce cas est un utilisateur et possède un certain nombre d'attributs associés, mais la cible peut également être un fichier, un paramètre de registre ou un élément. Cet exemple recherche "fkolzig" à l'aide du champ target.user.userid.
metadata.event_type = "USER_LOGIN" AND metadata.product_event_type = "4624" AND
target.user.userid = "fkolzig"
Exemple : rechercher dans vos données réseau
L'exemple suivant recherche dans les données réseau les événements RDP avec un target.port de 3389 et un principal.ip de 35.235.240.5.
Il inclut également un champ UDM de la section "network", la direction des données (network.direction).
metadata.product_event_type = "3" AND target.port = 3389 AND network.direction =
"OUTBOUND" and principal.ip = "35.235.240.5"
Exemple : Rechercher un processus spécifique
Pour examiner les processus créés sur vos serveurs, recherchez les instances de la commande net.exe et recherchez ce fichier spécifique dans son chemin d'accès attendu. Le champ que vous recherchez est target.process.file.full_path. Pour cette recherche, vous incluez la commande spécifique émise dans le champ target.process.command_line. Vous pouvez également ajouter un champ dans la section "about" (à propos), qui correspond à la description du code d'événement Microsoft Sysmon 1 (ProcessCreate).
Voici la recherche UDM :
metadata.product_event_type = "1" AND target.process.file.full_path =
"C:\Windows\System32\net.exe"
Vous pouvez éventuellement ajouter les champs de recherche UDM suivants :
principal.user.userid: identifiez l'utilisateur qui émet la commande.principal.process.file.md5: identifiez le hachage MD5.principal.process.command_line: ligne de commande.
Exemple : Rechercher les connexions utilisateur réussies associées à un service spécifique
L'exemple suivant recherche les connexions des utilisateurs (metadata.event_type est USER_LOGIN) associés au service marketing (target.user.department est marketing) de votre entreprise. Bien que target.user.department ne soit pas directement lié aux événements de connexion des utilisateurs, il est toujours présent dans les données LDAP ingérées concernant vos utilisateurs.
metadata.event_type = "USER_LOGIN" AND target.user.department = "Marketing"
Objets logiques : événement et entité
Le schéma UDM décrit tous les attributs disponibles qui stockent des données. Chaque enregistrement UDM indique s'il décrit un événement ou une entité. Les données sont stockées dans différents champs selon que l'enregistrement décrit un événement ou une entité, et selon la valeur définie dans le champ metadata.event_type ou metadata.entity_type.
- Événement UDM : stocke les données d'une action qui s'est produite dans l'environnement. Le journal des événements d'origine décrit l'action telle qu'elle a été enregistrée par l'appareil, comme le pare-feu et le proxy Web.
- Entité UDM : représentation contextuelle d'éléments tels que des éléments, des utilisateurs et des ressources de votre environnement. Il est obtenu à partir d'une source de données source de vérité.
Voici deux représentations visuelles générales du modèle de données d'événement et du modèle de données d'entité.

Figure : Modèle de données d'événement
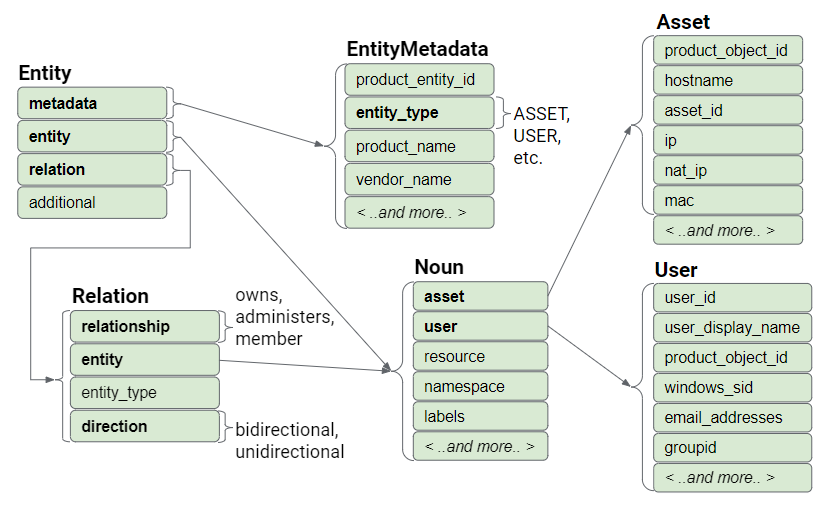
Figure : Modèle de données d'entité
Structure d'un événement UDM
L'événement UDM contient plusieurs sections qui stockent chacune un sous-ensemble des données d'un seul enregistrement. Les sections sont les suivantes :
- métadonnées
- principal
- cible
- src
- observateur
- intermédiaire
- à propos de
- réseau
- security_result
extensions
Figure : Modèle de données d'événement
La section metadata stocke le code temporel, définit le event_type et décrit l'appareil.
Les sections principal, target, src, observer et intermediary stockent des informations sur les objets impliqués dans l'événement. Un objet peut être un appareil, un utilisateur ou un processus. La plupart du temps, seul un sous-ensemble de ces sections est utilisé. Les champs qui stockent les données sont déterminés par le type d'événement et le rôle que chaque objet joue dans l'événement.
La section network stocke les informations liées à l'activité réseau, telles que les communications par e-mail et les communications réseau.
- Données d'e-mail : informations contenues dans les champs
to,from,cc,bccet d'autres champs d'e-mail. - Données HTTP : telles que
method,referral_urletuseragent.
La section security_result stocke une action ou une classification enregistrée par un produit de sécurité, tel qu'un produit antivirus.
Les sections about et extensions stockent des informations supplémentaires sur les événements spécifiques au fournisseur qui ne sont pas capturées par les autres sections. La section extensions est un ensemble de paires clé/valeur de forme libre.
Chaque événement UDM stocke les valeurs d'un événement de journal brut d'origine. Selon le type d'événement, certains attributs sont obligatoires, tandis que d'autres sont facultatifs. Les attributs obligatoires et facultatifs sont déterminés par la valeur metadata.event_type. Google SecOps lit metadata.event_type et effectue une validation de champ spécifique à ce type d'événement après la réception des journaux.
Si aucune donnée n'est stockée dans une section de l'enregistrement UDM, par exemple la section des extensions, cette section n'apparaît pas dans l'enregistrement UDM.
Les champs de métadonnées
Cette section décrit les champs requis dans un événement UDM.
Le champ event_timestamp
Les événements UDM doivent inclure des données pour metadata.event_timestamp, qui correspond au code temporel GMT de l'événement. La valeur doit être encodée à l'aide de l'une des normes suivantes : RFC 3339 ou code temporel Proto3.
Les exemples suivants montrent comment spécifier le code temporel au format RFC 3339, yyyy-mm-ddThh:mm:ss+hh:mm (année, mois, jour, heure, minute, seconde et décalage par rapport à l'heure UTC). Le décalage par rapport à l'heure UTC est de moins huit heures, ce qui correspond à l'heure PST.
metadata {
  "event_timestamp": "2019-09-10T20:32:31-08:00"
}

metadata {
  event_timestamp: "2021-02-23T04:00:00.000Z"
}
Vous pouvez également spécifier la valeur au format epoch.
metadata {
event_timestamp: {
  "seconds": 1588180305
 }
}
Le champ event_type
Le champ le plus important de l'événement UDM est metadata.event_type.
Cette valeur identifie le type d'action effectuée et est indépendante du fournisseur, du produit ou de la plate-forme. Exemples de valeurs : PROCESS_OPEN, FILE_CREATION, USER_CREATION et NETWORK_DNS. Pour obtenir la liste complète, consultez le document Liste des champs UDM.
La valeur metadata.event_type détermine les champs obligatoires et facultatifs supplémentaires qui doivent être inclus dans l'enregistrement UDM. Pour savoir quels champs inclure pour chaque type d'événement, consultez le guide d'utilisation de l'UDM.
Les attributs principal, target, src, intermediary, observer et about
Les attributs principal, target, src, intermediary et observer décrivent les éléments impliqués dans l'événement. Chacun stocke des informations sur les objets impliqués dans l'activité, telles qu'elles ont été enregistrées par le journal brut d'origine. Il peut s'agir de l'appareil ou de l'utilisateur qui a effectué l'activité, ou de l'appareil ou de l'utilisateur qui en est la cible. Il peut également décrire un appareil de sécurité qui a observé l'activité, comme un proxy de messagerie ou un routeur réseau.
Voici les attributs les plus couramment utilisés :
principal: objet ayant effectué l'activité.src: objet qui lance l'activité, s'il est différent du compte principal.target: objet sur lequel l'action est effectuée.
Chaque type d'événement nécessite qu'au moins un de ces champs contienne des données.
Les champs auxiliaires sont les suivants :
intermediary: tout objet ayant servi d'intermédiaire dans l'événement. Il peut s'agir d'objets tels que des serveurs proxy et des serveurs de messagerie.observer: tout objet qui n'interagit pas directement avec le trafic en question. Il peut s'agir d'un outil d'analyse des failles ou d'un analyseur de paquets.about: tout autre objet ayant joué un rôle dans l'événement (facultatif).
Attributs des comptes principaux
Représente l'entité ou l'appareil à l'origine de l'activité. Le compte principal doit inclure au moins un détail de la machine (nom d'hôte, adresse MAC, adresse IP, identifiants spécifiques au produit, tels qu'un GUID de machine CrowdStrike) ou un détail de l'utilisateur (par exemple, un nom d'utilisateur), et éventuellement inclure des détails sur le processus. Il ne doit inclure aucun des champs suivants : e-mail, fichiers, clés de registre ou valeurs.
Si l'événement se produit sur une seule machine, celle-ci n'est décrite que dans l'attribut principal. Il n'est pas nécessaire de décrire la machine dans les attributs "target" ou "src".
L'extrait JSON suivant illustre comment l'attribut principal peut être renseigné.
"principal": {
  "hostname": "jane_win10",
  "asset_id" : "Sophos.AV:C070123456-ABCDE",
    "ip" : "10.10.2.10",
    "port" : 60671,
    "user": {  "userid" : "john.smith" }
}
Cet attribut décrit tout ce que l'on sait sur l'appareil et l'utilisateur qui ont été l'acteur principal de l'événement. Cet exemple inclut l'adresse IP, le numéro de port et le nom d'hôte de l'appareil. Il inclut également un identifiant d'élément spécifique au fournisseur, Sophos, qui est un identifiant unique généré par le produit de sécurité tiers.
Attributs cibles
Représente un appareil cible référencé par l'événement ou un objet sur l'appareil cible. Par exemple, dans une connexion de pare-feu de l'appareil A à l'appareil B, l'appareil A est capturé en tant que principal et l'appareil B en tant que cible.
Pour une injection de processus par le processus C dans le processus cible D, le processus C est le principal et le processus D est la cible.

Figure : Compte principal et cible
L'exemple suivant montre comment le champ cible peut être renseigné.
target {
   ip: "192.0.2.31"
   port: 80
}
Si des informations supplémentaires sont disponibles dans le journal brut d'origine, telles que le nom d'hôte, des adresses IP supplémentaires, des adresses MAC et des identifiants d'éléments propriétaires, elles doivent également être incluses dans les champs "target" et "principal".
Le principal et la cible peuvent représenter des acteurs sur la même machine. Par exemple, le processus A (principal) exécuté sur la machine X peut agir sur le processus B (cible) également sur la machine X.
Attribut src
Représente un objet source sur lequel le participant agit, ainsi que le contexte de l'appareil ou du processus pour l'objet source (la machine sur laquelle réside l'objet source). Par exemple, si l'utilisateur U copie le fichier A sur la machine X vers le fichier B sur la machine Y, le fichier A et la machine X sont spécifiés dans la partie src de l'événement UDM.
Attribut "Intermédiaire"
Représente les détails d'un ou de plusieurs appareils intermédiaires traitant l'activité décrite dans l'événement. Il peut s'agir d'informations sur des appareils tels que des serveurs proxy et des serveurs de relais SMTP.
Attribut "observer"
Représente un appareil d'observation qui n'est pas un intermédiaire direct, mais qui observe l'événement en question et en rend compte. Il peut s'agir d'un analyseur de paquets ou d'un outil d'analyse des failles basé sur le réseau.
Attribut "about"
Cet objet stocke des détails sur un objet référencé par l'événement qui n'est pas décrit dans les champs principal, src, target, intermediary ou observer. Par exemple, il peut capturer les éléments suivants :
- Pièces jointes à l'e-mail.
- Domaines, URL ou adresses IP intégrés dans le corps de l'e-mail.
- DLL chargées lors d'un événement PROCESS_LAUNCH.
Attribut security_result
Cette section contient des informations sur les risques et les menaces de sécurité détectés par un système de sécurité, ainsi que sur les mesures prises pour les atténuer.
Voici les types d'informations qui seraient stockés dans l'attribut security_result :
- Un proxy de sécurité de messagerie a détecté une tentative d'hameçonnage (
security_result.category = MAIL_PHISHING) et a bloqué (security_result.action = BLOCK) l'e-mail. - Un pare-feu proxy de sécurité de messagerie a détecté deux pièces jointes infectées (
security_result.category = SOFTWARE_MALICIOUS), les a mises en quarantaine et les a désinfectées (security_result.action = QUARANTINE or security_result.action = ALLOW_WITH_MODIFICATION), puis a transféré l'e-mail désinfecté. - Un système SSO autorise une connexion (
security_result.category = AUTH_VIOLATION) qui a été bloquée (security_result.action = BLOCK). - Un bac à sable de détection des logiciels malveillants a détecté un logiciel espion (
security_result.category = SOFTWARE_MALICIOUS) dans une pièce jointe cinq minutes après la distribution du fichier (security_result.action = ALLOW) à l'utilisateur dans sa boîte de réception.
L'attribut de réseau
Les attributs réseau stockent des données sur les événements liés au réseau et des détails sur les protocoles dans les sous-messages. Cela inclut l'activité, comme les e-mails envoyés et reçus, et les requêtes HTTP.
Attribut d'extensions
Les champs de cet attribut stockent des métadonnées supplémentaires sur l'événement capturé dans le journal brut d'origine. Il peut contenir des informations sur les failles ou des informations supplémentaires liées à l'authentification.
Structure d'une entité UDM
Un enregistrement d'entité UDM stocke des informations sur n'importe quelle entité d'une organisation.
Si le metadata.entity_type est USER, l'enregistrement stocke les informations sur l'utilisateur sous l'attribut entity.user. Si le metadata.entity_type est ASSET, l'enregistrement stocke des informations sur un asset, tel qu'un poste de travail, un ordinateur portable, un téléphone et une machine virtuelle.
Figure : Modèle de données d'événement
Les champs de métadonnées
Cette section contient les champs obligatoires dans une entité UDM, par exemple :
collection_timestamp: date et heure de collecte de l'enregistrement.entity_type: type d'entité, tel qu'un élément, un utilisateur ou une ressource.
Attribut d'entité
Les champs sous l'attribut d'entité stockent des informations sur l'entité spécifique, telles que le nom d'hôte et l'adresse IP s'il s'agit d'un élément, ou windows_sid et l'adresse e-mail s'il s'agit d'un utilisateur. Notez que le nom du champ est entity, mais que le type de champ est "Noun" (Nom). Un nom est une structure de données couramment utilisée qui stocke des informations à la fois dans des entités et des événements.
- Si la valeur de
metadata.entity_typeest USER, les données sont stockées sous l'attributentity.user. - Si le
metadata.entity_typeest ASSET, les données sont stockées sous l'attributentity.asset.
Attribut de relation
Les champs de l'attribut de relation stockent des informations sur les autres entités auxquelles l'entité principale est associée. Par exemple, si l'entité principale est un utilisateur et qu'un ordinateur portable lui a été attribué. L'ordinateur portable est une entité associée.
Les informations sur l'ordinateur portable sont stockées sous la forme d'un enregistrement entity avec metadata.entity_type = ASSET. Les informations sur l'utilisateur sont stockées sous la forme d'un enregistrement entity avec metadata.entity_type = USER.
L'enregistrement de l'entité utilisateur capture également la relation entre l'utilisateur et l'ordinateur portable, à l'aide des champs sous l'attribut relation. Le champ relation.relationship stocke la relation que l'utilisateur entretient avec l'ordinateur portable, à savoir que l'utilisateur possède l'ordinateur portable. Le champ relation.entity_type stocke la valeur ASSET, car l'ordinateur portable est un appareil.
Les champs de l'attribut relations.entity stockent des informations sur l'ordinateur portable, telles que le nom d'hôte et l'adresse MAC. Notez à nouveau que le nom du champ est entity et que le type de champ est un nom. Un Noun est une structure de données couramment utilisée.
Les champs de l'attribut relation.entity stockent des informations sur l'ordinateur portable.
Le champ relation.direction stocke la directionnalité de la relation entre l'utilisateur et l'ordinateur portable, en particulier si la relation est bidirectionnelle ou unidirectionnelle.
Vous avez encore besoin d'aide ? Obtenez des réponses de membres de la communauté et de professionnels Google SecOps.