


Parser-Erweiterungen entwickeln
In diesem Dokument wird erläutert, wie Sie Parser-Erweiterungen erstellen, um Felder aus Logrohdaten zu extrahieren und sie in der Google Security Operations-Plattform den Ziel-UDM-Feldern (Unified Data Model) zuzuordnen.
In diesem Dokument wird der Prozess zum Erstellen von Parser-Erweiterungen beschrieben:
- Parser-Erweiterungen erstellen
- Voraussetzungen und Einschränkungen.
- Quellfelder in den unformatierten Logdaten identifizieren
- Wählen Sie die entsprechenden UDM-Zielfelder aus.
Wählen Sie den geeigneten Ansatz für die Definition der Parser-Erweiterung aus:
Beim Definieren einer Parser-Erweiterung wird die Parsing-Logik entworfen, um Rohlogdaten zu filtern, die Daten zu transformieren und sie den UDM-Zielfeldern zuzuordnen. Google SecOps bietet zwei Ansätze zum Erstellen von Parser-Erweiterungen:
- Erstellen Sie Parser-Erweiterungen mit dem No-Code-Ansatz (Datenfelder zuordnen).
- Erstellen Sie Parser-Erweiterungen mit dem Code-Snippet-Ansatz.
Beispiele für die Erstellung von Parsererweiterungen für verschiedene Logformate und Szenarien. Beispiele ohne Code mit JSON und Code-Snippets für komplexe Logik oder Nicht-JSON-Formate (CSV, XML, Syslog).
Parser-Erweiterungen erstellen
Parser-Erweiterungen bieten eine flexible Möglichkeit, die Funktionen vorhandener Standard- und benutzerdefinierter Parser zu erweitern. Parser-Erweiterungen bieten eine flexible Möglichkeit, die Funktionen vorhandener Standard- oder benutzerdefinierter Parser zu erweitern, ohne sie zu ersetzen. Mit den Erweiterungen können Sie die Parser-Pipeline anpassen, indem Sie neue Parsing-Logik hinzufügen, Felder extrahieren und transformieren sowie UDM-Feldzuordnungen aktualisieren oder entfernen.
Eine Parsererweiterung ist nicht dasselbe wie ein benutzerdefinierter Parser. Sie können einen benutzerdefinierten Parser für Logtypen erstellen, die keinen Standardparser haben, oder Parser-Updates deaktivieren.
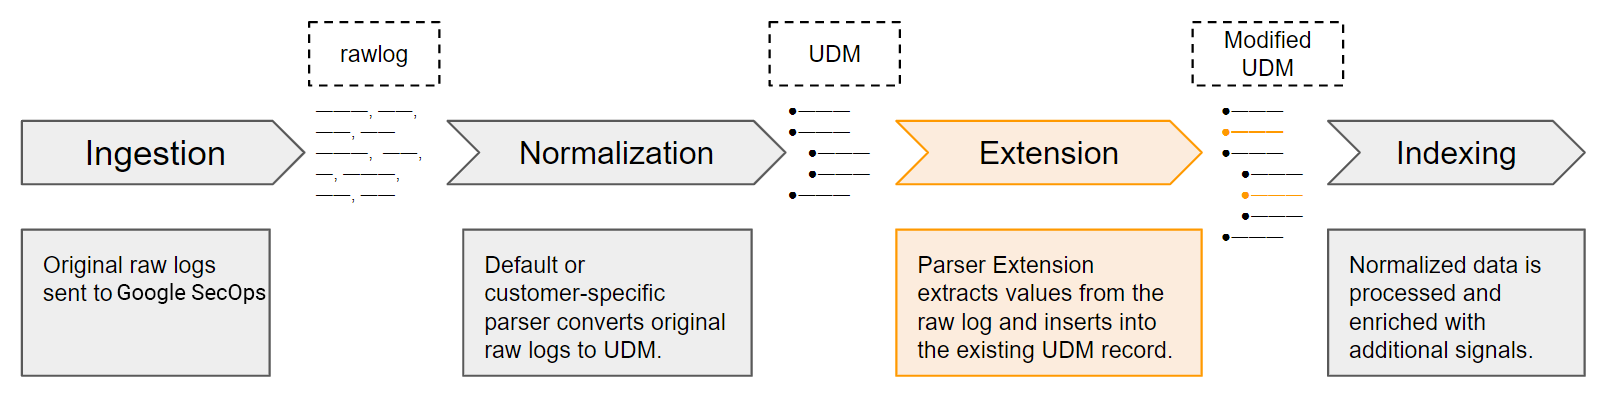
Parser-Extraktions- und Normalisierungsprozess
Google SecOps empfängt die ursprünglichen Logdaten als Rohlogs. Standard- und benutzerdefinierte Parser extrahieren und normalisieren wichtige Logfelder in strukturierte UDM-Felder in UDM-Einträgen. Dies ist nur ein Teil der ursprünglichen Rohlogdaten. Sie können Parser-Erweiterungen definieren, um Logwerte zu extrahieren, die nicht von Standard-Parsern verarbeitet werden. Nach der Aktivierung werden Parser-Erweiterungen Teil des Datenextraktions- und Normalisierungsprozesses von Google SecOps.
Neue Parser-Erweiterungen definieren
Standardparser enthalten vordefinierte Zuordnungsanweisungen, die angeben, wie wichtige Sicherheitswerte extrahiert, transformiert und normalisiert werden. Sie können neue Parsererweiterungen erstellen, indem Sie Zuordnungsanweisungen entweder mit dem No-Code-Ansatz (Datenfelder zuordnen) oder dem Code-Snippet-Ansatz definieren:
No-Code-Ansatz
Der No-Code-Ansatz eignet sich am besten für einfache Extraktionen aus Rohlogs im nativen JSON-, XML- oder CSV-Format. Sie können damit Rohprotokoll-Quellfelder angeben und entsprechende UDM-Zielfelder zuordnen.
Beispiel: JSON-Logdaten mit bis zu 10 Feldern mithilfe einfacher Gleichheitsvergleiche extrahieren.
Code-Snippet-Ansatz
Mit dem Code-Snippet-Ansatz können Sie Anweisungen definieren, um Werte aus dem Rohlog zu extrahieren und zu transformieren und sie UDM-Feldern zuzuweisen. Code-Snippets verwenden dieselbe Logstash-ähnliche Syntax wie der Standard- oder benutzerdefinierte Parser.
Dieser Ansatz gilt für alle unterstützten Logformate. Es eignet sich am besten für die folgenden Szenarien:
- Komplexe Datenextraktionen oder komplexe Logik.
- Unstrukturierte Daten, die Grok-basierte Parser erfordern.
- Nicht-JSON-Formate wie CSV und XML.
In Code-Snippets werden Funktionen verwendet, um bestimmte Daten aus den Rohprotokolldaten zu extrahieren. Beispiele: Grok, JSON, KV und XML.
In den meisten Fällen empfiehlt es sich, den Datenabgleichsansatz zu verwenden, der im Standard- oder benutzerdefinierten Parser verwendet wurde.
Neu extrahierte Werte in UDM-Felder zusammenführen
Nach der Aktivierung werden neu extrahierte Werte gemäß vordefinierten Zusammenführungsprinzipien in die dafür vorgesehenen UDM-Felder im entsprechenden UDM-Eintrag zusammengeführt. Beispiel:
Vorhandene Werte überschreiben: Extrahierte Werte überschreiben vorhandene Werte in den Ziel-UDM-Feldern.
Die einzige Ausnahme sind wiederkehrende Felder. Hier können Sie die Parser-Erweiterung so konfigurieren, dass neue Werte angehängt werden, wenn Daten in ein wiederkehrendes Feld im UDM-Eintrag geschrieben werden.
Parser-Erweiterung hat Vorrang: Datenzuordnungsanweisungen in einer Parser-Erweiterung haben Vorrang vor denen im Standard- oder benutzerdefinierten Parser für diesen Logtyp. Wenn es einen Konflikt bei den Zuordnungsanweisungen gibt, überschreibt die Parsererweiterung den Standardwert.
Wenn der Standardparser beispielsweise ein Rohlogfeld dem UDM-Feld
event.metadata.descriptionzuordnet und die Parsererweiterung ein anderes Rohlogfeld demselben UDM-Feld zuordnet, überschreibt die Parsererweiterung den vom Standardparser festgelegten Wert.
Auswahl für wiederkehrende Felder
Sowohl bei der Methode „Datenfelder zuordnen (No-Code)“ als auch bei der Methode „Code-Snippet schreiben“ können Sie festlegen, wie die Parser-Erweiterung Werte in wiederkehrenden Feldern speichert (Felder, die ein Array von Werten unterstützen, z. B. principal.ip). Verwenden Sie im Bereich Erweiterung (Erweiterungsdefinition) das Feld Wiederkehrende Felder, das die Optionen Werte anhängen und Werte ersetzen bietet.
Verhalten beim Anfügen im Vergleich zum Ersetzen
In einigen UDM-Feldern wird ein Array mit Werten gespeichert, z. B. im Feld principal.ip. Mit der Auswahl Wiederkehrende Felder können Sie festlegen, wie Ihre Parser-Erweiterung neu extrahierte Daten in einem wiederkehrenden Feld speichert:
Werte anhängen:
Die Parser-Erweiterung hängt den neu extrahierten Wert an das Array der vorhandenen Werte im UDM-Feld an.
Werte ersetzen:
Die Parsererweiterung ersetzt das Array der vorhandenen Werte im UDM-Feld durch den neu extrahierten Wert.
Eine Parsererweiterung kann Daten nur dann einem wiederkehrenden Feld zuordnen, wenn sich das wiederkehrende Feld auf der niedrigsten Ebene der Hierarchie befindet. Beispiel:
- Das Zuordnen von Werten zu
udm.principal.ipwird unterstützt, da sich das wiederkehrende Feldipauf der untersten Ebene der Hierarchie befindet undprincipalkein wiederkehrendes Feld ist. - Das Zuordnen von Werten zu
udm.intermediary.hostnamewird nicht unterstützt, daintermediaryein wiederkehrendes Feld ist und sich nicht auf der niedrigsten Ebene der Hierarchie befindet.
In der folgenden Tabelle finden Sie Beispiele dafür, wie sich die Konfiguration der Auswahl für wiederkehrende Felder auf den generierten UDM-Eintrag auswirkt.
| Auswahl Wiederkehrende Felder | Beispielprotokoll | Konfiguration der Parsererweiterung | Generiertes Ergebnis |
|---|---|---|---|
| Werte anhängen | {"protoPayload":{"@type":"type.AuditLog","authenticationInfo":{"principalEmail":" |
Vorbedingungsfeld: protoPayload.requestMetadata.callerIp
Vorbedingungswert: " "
Vorbedingungsoperator: NOT_EQUALS
Rohdatenfeld: protoPayload.requestMetadata.callerIp
Zielfeld: event.idm.read_only_udm.principal.ip
|
metadata:{event_timestamp:{}.....}principal:{Ip:"1.1.1.1, 2.2.2.2"}
            }
} |
| Werte anhängen | {"protoPayload":{"@type":"type.AuditLog","authenticationInfo":{"principalEmail":" |
Vorbedingung 1:
Vorbedingungsfeld: protoPayload.requestMetadata.callerIp
Vorbedingungswert: " "
Vorbedingungsoperator: NOT_EQUALS
Rohdatenfeld: protoPayload.requestMetadata.callerIp
Zielfeld: event.idm.read_only_udm.principal.ip
Voraussetzung 2:
|
Ereignisse, die vom vordefinierten Parser vor dem Anwenden der Erweiterung generiert wurden.
metadata:{event_timestamp:{} ... principal:{ip:"1.1.1.1"}}}
Ausgabe nach Anwendung der Erweiterung.
|
| Werte ersetzen | {"protoPayload":{"@type":"type..AuditLog","authenticationInfo":{"principalEmail":" |
Vorbedingungsfeld: protoPayload.authenticationInfo.principalEmail
Vorbedingungswert: " "
Vorbedingungsoperator: NOT_EQUALS
Rohdatenfeld: protoPayload.authenticationInfo.principalEmail
Zielfeld: event.idm.read_only_udm.principal.ip
|
UDM-Ereignisse, die vom vordefinierten Parser generiert wurden, bevor die Erweiterung angewendet wurde.timestamp:{} idm:{read_only_udm:{metadata:{event_timestamp:{} ... principal:{ip:"1.1.1.1"}}}
UDM-Ausgabe nach Anwendung der Erweiterung
|
Beschränkungen
- Eine Parsererweiterung pro Logtyp: Sie können nur eine Parsererweiterung pro Logtyp erstellen.
- Nur ein Ansatz für Datenzuordnungsanweisungen: Sie können eine Parsererweiterung entweder mit dem No-Code- oder dem Code-Snippet-Ansatz erstellen, aber nicht mit beiden Ansätzen zusammen.
- Logbeispiele für die Validierung: Logbeispiele aus den letzten 30 Tagen sind erforderlich, um eine UDM-Parsererweiterung zu validieren. Weitere Informationen finden Sie unter Aktiven Parser für den Logtyp sicherstellen.
- Fehler im Basisparser: Fehler im Basisparser können in Parsererweiterungen nicht identifiziert oder behoben werden.
- Umgang mit wiederkehrenden Feldern: Sie können in einer bestimmten Erweiterung nur eine Methode (Anhängen oder Ersetzen) verwenden. Seien Sie vorsichtig, wenn Sie ganze wiederkehrende Objekte ersetzen, um unbeabsichtigten Datenverlust zu vermeiden.
Additional.fieldswird als Satz von Schlüssel/Wert-Paaren interpretiert, nicht als wiederkehrendes Feld: Daher können Sie sowohl die UDM-Zuordnungen des Parsers als auch die UDM-Ausgaben der Erweiterung nahtlos kombinieren, indem Sie die entsprechenden Schlüssel/Wert-Paare dem Satz hinzufügen.- Eindeutige Ereignisse: Parsererweiterungen können keine Logs mit mehreren eindeutigen Ereignissen in einem einzelnen Eintrag verarbeiten, z. B. Google Drive-Arrays.
- XML und No-Code: Der No-Code-Modus wird für XML nicht unterstützt. Verwenden Sie stattdessen die Methode mit dem Code-Snippet.
- Parser-Syntax im Vergleich zu YARA-L-Erkennungsregeln: Aufnahme-Parser und Parser-Erweiterungen verwenden Logstash Grok und die Konfigurationssyntax mit Filtern (z. B.
grok,mutate,json,dateundbase64) bei der Aufnahme, um Rohlogs in das Unified Data Model (UDM) zu parsen. Parser können keine YARA-L-Syntax, Ergebnisblöcke oder Generatorfunktionen (z. B.yield) verwenden. YARA-L 2.0 ist ausschließlich eine Abfragesprache für die Erkennungs-Engine, die nachgelagert für normalisierte UDM-Ereignisse zur Bedrohungswarnung ausgewertet wird. Sie kann keine Rohlogs parsen, UDM-Felder mutieren oder eingehenden Log-Traffic verwerfen. - Standardmäßig nur Weiterleitung: Parser-Erweiterungen werden standardmäßig nur auf neu aufgenommene Logs ab dem Zeitpunkt der Aktivierung angewendet. Wenn es aus geschäftlichen Gründen dringend erforderlich ist, historische Protokolle mit aktualisierten Zuordnungen neu zu parsen, können Sie über den Support von Google Cloud eine Backend-Aufgabe zur Protokollwiedergabe anfordern. Weitere Informationen finden Sie unter Verlaufsdaten neu parsen (Log-Wiedergabe).
- Aufnahmelabels in der Parserlogik nicht zugänglich: Parsererweiterungen können keine Aufnahmelabels (
metadata.ingestion_labels) lesen, um Werte UDM-Feldern zuzuordnen, da Parser in einer Sandbox-Ausführungsumgebung ausgeführt werden, in der nur der Rohtext des Logs sichtbar ist. - Reservierte Keywords beim No-Code-Ansatz: Wenn die Logs eines der folgenden reservierten Keywords enthalten, verwenden Sie den Code-Snippet-Ansatz anstelle des No-Code-Ansatzes:
collectionTimestampcreateTimestampenableCbnForLoopeventfilenamemessagenamespaceoutputonErrorCounttimestamptimezone
- Vorhandene Zuordnungen entfernen: Sie können vorhandene UDM-Feldzuordnungen nur mit dem Code-Snippet-Ansatz entfernen.
- Kein Entfernen der Zuordnung eines Hostnamen-UDM-Felds mithilfe einer Erweiterung: Sie können die Zuordnung eines Hostnamen-UDM-Felds (z. B.
principal.hostname) nicht mithilfe einer Erweiterung aufheben (entfernen).
Parser-Konzepte
In den folgenden Dokumenten werden wichtige Parser-Konzepte erläutert:
Vorbereitung
Voraussetzungen für das Erstellen von Parsererweiterungen:
- Für den Logtyp muss ein aktiver Standard- oder benutzerdefinierter Parser vorhanden sein.
- Google SecOps muss die Rohlogs mit einem Standard- oder benutzerdefinierten Parser aufnehmen und normalisieren können.
- Achten Sie darauf, dass der aktive Standard- oder benutzerdefinierte Parser für Ihren Ziel-Logtyp in den letzten 30 Tagen Roh-Logdaten aufgenommen hat. Diese Daten sollten eine Stichprobe der Felder enthalten, die Sie extrahieren oder zum Filtern der Logeinträge verwenden möchten. Sie wird verwendet, um Ihre neuen Anweisungen für den Datenabgleich zu validieren.
Jetzt starten
Führen Sie vor dem Erstellen einer Parser-Erweiterung die folgenden Schritte aus:
-
Achten Sie darauf, dass ein aktiver Parser für den Logtyp vorhanden ist. Wenn noch kein Parser vorhanden ist, erstellen Sie einen benutzerdefinierten Parser.
Felder identifizieren, die aus den Rohlogs extrahiert werden sollen:
Identifizieren Sie die Felder, die Sie aus den Rohlogs extrahieren möchten.
Geeignete UDM-Felder auswählen:
Wählen Sie die entsprechenden UDM-Felder aus, um die extrahierten Rohlogfelder zuzuordnen.
Wählen Sie einen Ansatz zum Definieren von Parser-Erweiterungen aus:
Wählen Sie einen der beiden Erweiterungsansätze (Datenabgleichsansätze) aus, um die Parsererweiterung zu erstellen.
Voraussetzungen prüfen
Achten Sie darauf, dass ein aktiver Parser für den Logtyp vorhanden ist, den Sie erweitern möchten, wie in den folgenden Abschnitten beschrieben:
Aktiven Parser für den Logtyp prüfen
Achten Sie darauf, dass für den Logtyp, den Sie erweitern möchten, ein aktiver Standard- oder benutzerdefinierter Parser vorhanden ist.
Suchen Sie in diesen Listen nach Ihrem Logtyp:
Unterstützte Logtypen mit einem Standardparser.
- Wenn es für den Logtyp einen Standardparser gibt, prüfen Sie, ob der Parser aktiv ist.
- Wenn es für den Logtyp keinen Standardparser gibt, muss ein benutzerdefinierter Parser für den Logtyp vorhanden sein.
Unterstützte Logtypen ohne Standardparser.
- Wenn es für den Logtyp keinen Standardparser gibt, muss ein benutzerdefinierter Parser für den Logtyp vorhanden sein.
Benutzerdefinierten Parser für den Logtyp erstellen
So prüfen Sie, ob ein benutzerdefinierter Parser für einen Logtyp vorhanden ist:
- Wählen Sie in der Navigationsleiste Einstellungen > Datenverwaltung > Parser aus. Wenn Sie eine reine SIEM-Plattform verwenden, rufen Sie die Einstellungen > Parser auf.
Suchen Sie in der Tabelle Parser nach dem Logtyp, den Sie erweitern möchten.
- Wenn für diesen Logtyp noch kein Standard- oder benutzerdefinierter Parser vorhanden ist, klicken Sie auf Neuen Parser hinzufügen (oder Parser erstellen) und folgen Sie der Anleitung unter Benutzerdefinierten Parser basierend auf Zuordnungsanweisungen erstellen.
- Wenn für diesen Logtyp bereits ein benutzerdefinierter Parser vorhanden ist, muss der Parser aktiv sein.
Achten Sie darauf, dass der Parser für den Logtyp aktiv ist.
So prüfen Sie, ob ein Parser für einen Logtyp aktiv ist:
- Wählen Sie in der Navigationsleiste Einstellungen > Datenverwaltung > Parser aus. Wenn Sie eine reine SIEM-Plattform verwenden, rufen Sie die Einstellungen > Parser auf.
Suchen Sie in der Tabelle Parser nach dem Logtyp, den Sie erweitern möchten.
Wenn der Parser für den Logtyp nicht aktiv ist, aktivieren Sie ihn:
- Informationen zu Standardparsern finden Sie unter Updates für vordefinierte Parser verwalten.
- Informationen zu benutzerdefinierten Parsern finden Sie unter Benutzerdefinierte Parser konfigurieren.
Felder identifizieren, die aus den Rohlogs extrahiert werden sollen
Analysieren Sie das Rohlog, aus dem Sie Daten extrahieren möchten, um die Felder zu identifizieren, die nicht vom Standardparser (oder benutzerdefinierten Parser) extrahiert werden. Achten Sie darauf, wie der Standard- oder benutzerdefinierte Parser Rohlogfelder extrahiert und den entsprechenden UDM-Feldern zuordnet.
Wenn Sie die Felder ermitteln möchten, die Sie aus den Rohlogs extrahieren möchten, können Sie die Suchtools verwenden:
Rufen Sie Prüfung > SIEM-Suche auf, um auf das Suchtool zuzugreifen. Geben Sie vor Ihrer Suchanfrage raw= ein. Weitere Informationen finden Sie unter Rohlogs suchen.
Wenn Sie auf das Legacy-Suchtool zugreifen möchten, klicken Sie oben auf der Seite SIEM-Suche auf Zur Legacy-Suche. Weitere Informationen finden Sie unter Legacy-Methode: Suchprompt für Rohlogs verwenden.
Weitere Informationen zum Suchen in den Rohlogs finden Sie hier:
Geeignete UDM-Felder auswählen
Nachdem Sie die spezifischen Zielfelder für die Extraktion identifiziert haben, können Sie sie den entsprechenden UDM-Zielfeldern zuordnen. Erstellen Sie eine klare Zuordnung zwischen den Feldern der Rohprotokollquelle und den entsprechenden UDM-Zielfeldern. Sie können Daten jedem UDM-Feld zuordnen, das die Standarddatentypen oder wiederkehrende Felder unterstützt.
Das richtige UDM-Feld auswählen
Die folgenden Ressourcen können den Prozess vereinfachen:
- Mit den wichtigsten UDM-Konzepten vertraut machen
- Datenabgleich des vorhandenen Parsers nachvollziehen
- Verwenden Sie das UDM-Suchtool, um potenzielle UDM-Felder zu finden, die Ihren Quellfeldern entsprechen.
- Der Leitfaden Wichtige UDM-Felder für die Parser-Datenzuordnung enthält eine Zusammenfassung und Erläuterung der am häufigsten verwendeten Felder des UDM-Schemas.
- Die Feldliste des einheitlichen Datenmodells enthält eine Liste aller UDM-Felder und ihrer Beschreibungen. Wiederkehrende Felder sind in den Listen mit dem Label „repeated“ gekennzeichnet.
- Wichtige UDM-Überlegungen zur Vermeidung von Fehlern
Machen Sie sich mit den wichtigsten UDM-Konzepten vertraut.
Logische Objekte: Ereignis und Entität
Das UDM-Schema beschreibt alle verfügbaren Attribute, in denen Daten gespeichert werden. Jeder UDM-Eintrag beschreibt ein Ereignis oder eine Entität. Die Daten werden in verschiedenen Feldern gespeichert, je nachdem, ob der Eintrag ein Ereignis oder eine Entität beschreibt.
- In einem UDM-Ereignisobjekt werden Daten zur Aktion gespeichert, die in der Umgebung aufgetreten ist. Im ursprünglichen Ereignisprotokoll wird die Aktion so beschrieben, wie sie vom Gerät aufgezeichnet wurde, z. B. von einer Firewall oder einem Webproxy.
- In UDM-Entitätsobjekten werden Daten zu den am UDM-Ereignis beteiligten Teilnehmern oder Entitäten gespeichert, z. B. Assets, Nutzer oder Ressourcen in Ihrer Umgebung.
UDM-Substantive: Ein Substantiv stellt einen Teilnehmer oder eine Entität in einem UDM-Ereignis dar. Ein Substantiv könnte beispielsweise das Gerät oder der Nutzer sein, das bzw. der die im Ereignis beschriebene Aktivität ausführt. Ein Substantiv kann auch das Gerät oder der Nutzer sein, das bzw. der das Ziel der im Ereignis beschriebenen Aktivität ist.
UDM-Substantiv Beschreibung principalDie Entität, die für die Initiierung der im Ereignis beschriebenen Aktion verantwortlich ist. targetDie Entität, die der Empfänger oder das Objekt der Aktion ist. In einer Firewallverbindung ist die Maschine, die die Verbindung empfängt, das Ziel. srcEine Quellentität, auf die das Hauptkonto reagiert hat. Wenn ein Nutzer beispielsweise eine Datei von einem Computer auf einen anderen kopiert, werden die Datei und der Computer, von dem sie stammt, als „src“ dargestellt. intermediaryJede Entität, die als Vermittler im Ereignis fungiert, z. B. ein Proxyserver. Sie können die Aktion beeinflussen, z. B. eine Anfrage blockieren oder ändern. observerEine Entität, die das Ereignis überwacht und meldet, aber nicht direkt mit dem Verkehr interagiert. Beispiele hierfür sind Intrusion Detection Systems für Netzwerke oder Security Information and Event Management-Systeme. aboutAlle anderen am Ereignis beteiligten Entitäten, die nicht in die vorherigen Kategorien passen. Beispiele hierfür sind E-Mail-Anhänge oder geladene DLLs während eines Prozessstarts. In der Praxis werden die Substantivobjekte „principal“ und „target“ am häufigsten verwendet. Die vorstehenden Beschreibungen stellen die empfohlene Verwendung von Substantiven dar. Die tatsächliche Nutzung kann je nach Implementierung eines Standard- oder benutzerdefinierten Basis-Parsers variieren.
Datenabgleich des vorhandenen Parsers verstehen
Es wird empfohlen, sich mit dem vorhandenen Datenabgleich vertraut zu machen, der vom Standard- oder benutzerdefinierten Parser zwischen den Quellfeldern des Rohlogs und den UDM-Zielfeldern verwendet wird.
So rufen Sie die Datenzuordnung zwischen den Quellfeldern des Rohlogs und den Ziel-UDM-Feldern auf, die im vorhandenen Standard- oder benutzerdefinierten Parser verwendet werden:
- Wählen Sie in der Navigationsleiste Einstellungen > Datenverwaltung > Parser aus. Wenn Sie eine reine SIEM-Plattform verwenden, rufen Sie die Einstellungen > Parser auf.
- Suchen Sie in der Tabelle Parser nach dem Logtyp, den Sie erweitern möchten.
Gehen Sie zu dieser Zeile und klicken Sie dann auf das Menü > Anzeigen.
Auf dem Tab Vordefiniert (oder Benutzerdefiniert) wird im Abschnitt Parser-Code die Datenzuordnung zwischen den Feldern der Rohprotokollquelle und den Ziel-UDM-Feldern angezeigt, die im vorhandenen Standardparser (oder benutzerdefinierten Parser) verwendet werden.
UDM-Lookup-Tool verwenden
Verwenden Sie das UDM-Suchtool, um UDM-Felder zu identifizieren, die mit den Feldern der Rohprotokollquelle übereinstimmen.
Google SecOps bietet das UDM-Suchtool, mit dem Sie Ziel-UDM-Felder schnell finden können. Rufen Sie Prüfung > SIEM-Suche auf, um das UDM-Suchtool zu öffnen.
In den folgenden Themen finden Sie weitere Informationen zur Verwendung des UDM-Suchtools:
- UDM-Feld suchen
- UDM-Suche eingeben
- Zeitfilter für die Suche festlegen
- Beispiele für UDM-Suchanfragen
- UDM-Suchanfragen mit Gemini generieren
Beispiel für das UDM-Lookup-Tool
Wenn Sie beispielsweise ein Quellfeld im Rohprotokoll mit dem Namen „packets“ haben, verwenden Sie das UDM-Suchtool, um potenzielle Ziel-UDM-Felder mit „packets“ im Namen zu finden:
Rufen Sie Prüfung > SIEM-Suche auf.
Klicken Sie auf der Seite SIEM-Suche auf UDM-Suche.
Das Dialogfeld UDM-Suche wird geöffnet. Das Suchtool gleicht UDM-Felder entweder nach Feldname oder Feldwert ab:
- Suche nach Feldname: Die eingegebene Textzeichenfolge wird mit Feldnamen abgeglichen, die diesen Text enthalten.
- Suche nach Feldwert: Der von Ihnen eingegebene Wert wird mit Feldern abgeglichen, die diesen Wert in ihren gespeicherten Logdaten enthalten.
Geben Sie im Dialogfeld UDM-Suche im Feld Nach UDM-Feldern/Werten suchen „packets“ ein und wählen Sie UDM-Felder aus.
Die Suchfunktion zeigt eine Liste potenzieller UDM-Felder an, die den Text „packets“ in ihren UDM-Feldnamen enthalten.
Klicken Sie nacheinander auf die einzelnen Zeilen, um die Beschreibung der einzelnen UDM-Felder aufzurufen.
Wichtige UDM-Überlegungen zur Vermeidung von Fehlern
- Ähnlich aussehende Felder: Die hierarchische Struktur des UDM kann zu Feldern mit ähnlichen Namen führen. Weitere Informationen finden Sie unter „Standardparser“. Weitere Informationen finden Sie unter Datenabgleich des vorhandenen Parsers nachvollziehen.
- Beliebige Feldzuordnung: Verwenden Sie das Objekt
additionalfür Daten, die nicht direkt einem UDM-Feld zugeordnet werden können. Weitere Informationen finden Sie unter Beliebige Feldzuordnung in UDM. - Wiederkehrende Felder: Seien Sie vorsichtig, wenn Sie mit wiederkehrenden Feldern in Code-Snippets arbeiten. Wenn Sie ein ganzes Objekt ersetzen, werden die ursprünglichen Daten möglicherweise überschrieben. Der No-Code-Ansatz bietet mehr Kontrolle über wiederkehrende Felder. Weitere Informationen finden Sie unter Auswahl für wiederkehrende Felder.
- Obligatorische UDM-Felder für UDM-Ereignistypen: Wenn Sie einem UDM-Eintrag ein UDM-
metadata.event_type-Feld zuweisen, muss für jedenevent_typeein anderer Satz zugehöriger Felder im UDM-Eintrag vorhanden sein. Weitere Informationen finden Sie unter Weitere Informationen zum Zuweisen von UDM-metadata.event_type-Feldern. - Probleme mit dem Basisparser: Parser-Erweiterungen können keine Fehler des Basisparsers beheben. Der Basisparser ist der Standard- oder benutzerdefinierte Parser, der den UDM-Eintrag erstellt hat. Ziehen Sie Optionen wie das Erweitern der Parser-Erweiterung, das Ändern des Basis-Parsers oder das Vorfiltern von Logs in Betracht.
Beliebige Feldzuordnung in UDM
Wenn Sie kein geeignetes Standard-UDM-Feld zum Speichern Ihrer Daten finden, verwenden Sie das Objekt additional, um die Daten als benutzerdefiniertes Schlüssel/Wert-Paar zu speichern. So können Sie wertvolle Informationen im UDM-Eintrag speichern, auch wenn kein passendes UDM-Feld vorhanden ist.
Ansatz zur Definition von Parser-Erweiterungen auswählen
Bevor Sie sich für einen Ansatz zur Definition von Parsererweiterungen entscheiden, müssen Sie die folgenden Abschnitte durchgearbeitet haben:
Als Nächstes müssen Sie die Seite Parser-Erweiterung öffnen und den Erweiterungsansatz auswählen, mit dem die Parser-Erweiterung definiert werden soll:
Öffnen Sie die Seite „Parser-Erweiterung“.
Auf der Seite Parser-Erweiterung können Sie die neue Parser-Erweiterung definieren.
Sie können die Seite Parser-Erweiterung über das Menü „Einstellungen“, über eine Suche nach Rohprotokollen oder über eine Legacy-Suche nach Rohprotokollen öffnen:
Über das Menü „Einstellungen“ öffnen
So öffnen Sie die Seite Parser-Erweiterung über das Menü „Einstellungen“:
Wählen Sie in der Navigationsleiste Einstellungen > Datenverwaltung > Parser aus. Wenn Sie eine reine SIEM-Plattform verwenden, rufen Sie die Einstellungen > Parser auf.
In der Tabelle Parser wird eine Liste der Standardparser nach Logtyp angezeigt.
Suchen Sie den Logtyp, den Sie erweitern möchten, und klicken Sie auf das Menü > Parser erweitern > Erweiterung erstellen.
Die Seite Parser-Erweiterung wird geöffnet.
Über die Suche nach Rohlogs öffnen
So öffnen Sie die Seite Parser-Erweiterung über die Suche nach Rohlogs:
- Rufen Sie Prüfung > SIEM-Suche auf.
- Fügen Sie im Suchfeld das Präfix
raw =zu Ihrem Suchargument hinzu und setzen Sie den Suchbegriff in Anführungszeichen. Beispiel:raw = "example.com". - Klicken Sie auf Suche ausführen. Die Ergebnisse werden im Bereich Rohe Logs angezeigt.
- Klicken Sie im Bereich Rohe Logs auf ein Log (Zeile). Der Bereich Ereignisanzeige wird angezeigt.
- Klicken Sie im Bereich Ereignisanzeige auf den Tab Rohprotokoll. Das Rohlog wird angezeigt.
Klicken Sie auf Parser verwalten > Parser erweitern > Erweiterung erstellen (oder wählen Sie Erweiterung erstellen > Weiter aus).
Die Seite Parser-Erweiterung wird geöffnet.
Über die Legacy-Suche nach Rohdaten öffnen
So öffnen Sie die Seite Parser-Erweiterung über eine Legacy-Rohprotokollsuche:
- Verwenden Sie die alte Rohprotokollsuche, um nach Einträgen zu suchen, die den zu parsenden Einträgen ähneln.
- Wählen Sie im Bereich Zeitachse ein Ereignis aus oder klicken Sie auf das Symbol für das Rohprotokoll, um das Rohprotokoll zu öffnen.
Klicken Sie auf Parser verwalten > Parser erweitern > Erweiterung erstellen (oder wählen Sie Erweiterung erstellen > Weiter aus).
Die Seite Parser-Erweiterung wird geöffnet.
Seite „Parsererweiterung“
Auf der Seite werden die Bereiche Rohprotokoll und Erweiterung (Erweiterungsdefinition) angezeigt:
Bereich Rohlog:
Hier werden Beispiel-Rohprotokolldaten für den ausgewählten Protokolltyp angezeigt. Wenn Sie die Seite über die Rohprotokollsuche geöffnet haben, sind die Beispieldaten das Ergebnis Ihrer Suche. Sie können das Beispiel über das Menü Anzeigen als (Rohdaten, JSON, CSV, XML oder Hex/ASCII) und das Kästchen Zeilenumbruch formatieren.
Prüfen Sie, ob die angezeigte Stichprobe der Rohprotokolldaten repräsentativ für die Protokolle ist, die von der Parsererweiterung verarbeitet werden.
Klicken Sie auf UDM-Ausgabe als Vorschau ansehen (oder UDM-Ausgabe einblenden), um die UDM-Ausgabe für die Beispiel-Rohlogdaten aufzurufen.
Bereich Erweiterung (Erweiterungsdefinition):
So können Sie eine Parsererweiterung mit einem von zwei Ansätzen für Zuordnungsanweisungen definieren: Datenfelder zuordnen (ohne Code) oder Code-Snippets schreiben (oder Code-Snippet schreiben). Sie können nicht beide Ansätze in derselben Parsererweiterung verwenden.
Je nach gewählter Methode können Sie entweder die Quell-Logdatenfelder angeben, die aus den eingehenden Rohlogs extrahiert und den entsprechenden UDM-Feldern zugeordnet werden sollen, oder Sie können ein Code-Snippet schreiben, um diese und weitere Aufgaben auszuführen.
Erweiterungsansatz auswählen
Wählen Sie auf der Seite Parser-Erweiterung im Bereich Erweiterung im Feld Erweiterungsmethode einen der folgenden Ansätze aus, um die Parser-Erweiterung zu erstellen:
Datenfelder zuordnen (No-Code):
Bei diesem Ansatz können Sie die Felder im Rohlog angeben und sie Ziel-UDM-Feldern zuordnen.
Dieser Ansatz funktioniert mit den folgenden Rohprotokollformaten:
- Natives JSON, natives XML oder CSV.
- Syslog-Header plus natives JSON, natives XML oder CSV. Sie können eine Anleitung zur Zuordnung von Datenfeldtypen für Rohlogs in den folgenden Formaten erstellen:
JSON,XML,CSV,SYSLOG + JSON,SYSLOG + XMLundSYSLOG + CSV.
Weitere Informationen finden Sie unter Anleitung für No-Code-Agenten (Datenfelder zuordnen) erstellen.
Code-Snippets schreiben (oder Code-Snippet schreiben):
Mit diesem Ansatz können Sie eine Logstash-ähnliche Syntax verwenden, um Anweisungen zum Extrahieren und Transformieren von Werten aus dem Rohlog anzugeben und sie UDM-Feldern im UDM-Eintrag zuzuweisen.
Code-Snippets verwenden dieselbe Syntax und dieselben Abschnitte wie Standard- oder benutzerdefinierte Parser. Weitere Informationen finden Sie unter Parser-Syntax.
Dieser Ansatz funktioniert mit allen unterstützten Datenformaten für diesen Logtyp.
Weitere Informationen finden Sie unter Anleitung zum Erstellen von Code-Snippets.
Anleitung zum Erstellen von No-Code-Anweisungen (Datenfelder zuordnen)
Mit dem No-Code-Ansatz (auch als Datenfelder zuordnen-Methode bezeichnet) können Sie die Pfade der Rohprotokollfelder angeben und sie den entsprechenden UDM-Zielfeldern zuordnen.
Bevor Sie eine Parsererweiterung mit dem No-Code-Ansatz erstellen, müssen Sie die folgenden Abschnitte durchgearbeitet haben:
- Parser-Erweiterungen erstellen
- Jetzt starten
- Wählen Sie den Erweiterungsansatz aus und dann die Option Datenfelder zuordnen.
Die nächsten Schritte zum Definieren der Parser-Erweiterung sind:
- Auswahl für wiederkehrende Felder festlegen
- Anweisung für den Datenabgleich für jedes Feld definieren
- Parser-Erweiterung einreichen und aktivieren
Datenabgleichsanweisung für jedes Feld definieren
Definieren Sie für jedes Feld, das Sie aus dem Rohlog extrahieren möchten, eine Anweisung zum Datenabgleich. In der Anweisung muss der Pfad des Ursprungsfelds im Rohlog angegeben und dem UDM-Zielfeld zugeordnet werden.
Wenn das im Bereich Rohprotokoll angezeigte Rohprotokollbeispiel einen Syslog-Header enthält, werden die Felder Syslog und Ziel angezeigt. (Einige Logformate enthalten keinen Syslog-Header, z. B. natives JSON, natives XML oder CSV.)
Google SecOps benötigt die Felder Syslog und Target, um den Syslog-Header vorzuverarbeiten und den strukturierten Teil des Logs zu extrahieren.
Definieren Sie diese Felder:
Syslog: Dies ist ein benutzerdefiniertes Muster, das einen Syslog-Header vorverarbeitet und vom strukturierten Teil eines Rohlogs trennt.
Geben Sie das Extraktionsmuster mit Grok und regulären Ausdrücken an, das den Syslog-Header und den rohen Logeintrag identifiziert. Weitere Informationen finden Sie unter Syslog-Extraktorfelder definieren.
Ziel: Variablenname im Syslog-Feld, in dem der strukturierte Teil des Logs gespeichert wird.
Geben Sie den Variablennamen im Extraktionsmuster an, in dem der strukturierte Teil des Logs gespeichert wird.
Dies ist ein Beispiel für ein Extraktionsmuster und einen Variablennamen für die Felder Syslog bzw. Target.
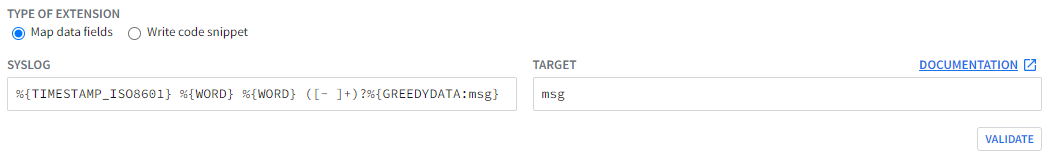
Nachdem Sie Werte in die Felder Syslog und Ziel eingegeben haben, klicken Sie auf die Schaltfläche Validieren.
Bei der Validierung wird sowohl auf Syntax- als auch auf Parsing-Fehler geprüft. Anschließend wird eine der folgenden Meldungen zurückgegeben:
- Erfolgreich: Die Felder für den Datenabgleich werden angezeigt. Definieren Sie den Rest der Parser-Erweiterung.
- Fehler: Eine Fehlermeldung wird angezeigt. Beheben Sie den Fehler, bevor Sie fortfahren.
Optional können Sie eine Vorbedingungsanweisung definieren.
Eine Vorbedingungsanweisung identifiziert eine Teilmenge der Rohlogs, die von der Parsererweiterung verarbeitet werden, indem ein statischer Wert mit einem Feld im Rohlog abgeglichen wird. Wenn ein eingehendes Rohlog die Vorbedingungskriterien erfüllt, wendet die Parsererweiterung die Zuordnungsanweisung an. Wenn die Werte nicht übereinstimmen, wendet die Parser-Erweiterung die Zuordnungsanweisung nicht an.
Füllen Sie die folgenden Felder aus:
- Vorbedingungsfeld (oder Vorbedingungsspalte für CSV): Feld-ID im Rohprotokoll, die den zu vergleichenden Wert enthält. Geben Sie entweder den vollständigen Pfad zum Feld ein, wenn das Logdatenformat JSON oder XML ist, oder die Spaltenposition, wenn das Datenformat CSV ist.
- Vorbedingungsoperator: Wählen Sie Ist gleich oder Ist nicht gleich aus.
- Vorbedingungswert: Der statische Wert, der mit dem Vorbedingungsfeld im Rohlog verglichen wird.
Ein weiteres Beispiel für eine Vorbedingungsanweisung finden Sie unter No-Code – Felder mit Vorbedingungswert extrahieren.
Ordnen Sie das Rohdatenfeld des Logs dem UDM-Zielfeld zu:
Rohdatenfeld (oder Rohdatenspalte für CSV): Geben Sie entweder den vollständigen Pfad zum Feld ein, wenn das Logdatenformat JSON (z. B.
jsonPayload.connection.dest_ip) oder XML (z. B./Event/Reason-Code) ist, oder die Spaltenposition, wenn das Datenformat CSV ist (Hinweis: Indexpositionen beginnen bei 1).Zielfeld: Geben Sie den voll qualifizierten UDM-Feldnamen ein, in dem der Wert gespeichert werden soll, z. B.
udm.metadata.collected_timestamp.seconds.
Wenn Sie weitere Felder hinzufügen möchten, klicken Sie auf Hinzufügen und geben Sie alle Details zur Zuordnungsanweisung für das nächste Feld ein.
Ein weiteres Beispiel für die Zuordnung der Felder finden Sie unter No-Code – Felder extrahieren.
Parser-Erweiterung einreichen und aktivieren
Nachdem Sie Datenabgleichsanweisungen für alle Felder definiert haben, die Sie aus dem Rohprotokoll extrahieren möchten, senden und aktivieren Sie die Parser-Erweiterung.
Klicken Sie auf Senden, um die Zuordnungsanweisung zu speichern und zu validieren.
Google SecOps validiert die Zuordnungsanweisungen:
- Wenn die Validierung erfolgreich ist, ändert sich der Status in Live und die Zuordnungsanweisungen beginnen mit der Verarbeitung eingehender Logdaten.
Wenn die Validierung fehlschlägt, ändert sich der Status zu Fehlgeschlagen und im Feld „Rohprotokoll“ wird ein Fehler angezeigt.
Dies ist ein Beispiel für einen Validierungsfehler:
  ERROR: generic::unknown: pipeline.ParseLogEntry failed: LOG_PARSING_CBN_ERROR:
  "generic::invalid_argument: pipeline failed: filter mutate (7) failed: copy failure:
  copy source field \"jsonPayload.dest_instance.region\" must not be empty
  (try using replace to provide the value before calling copy)

  "LOG: {"insertId":"14suym9fw9f63r","jsonPayload":{"bytes_sent":"492",
  "connection":{"dest_ip":"10.12.12.33","dest_port":32768,"protocol":6,
  "src_ip":"10.142.0.238","src_port":22},"end_time":"2023-02-13T22:38:30.490546349Z",
  "packets_sent":"15","reporter":"SRC","src_instance":{"project_id":"example-labs",
  "region":"us-east1","vm_name":"example-us-east1","zone":"us-east1-b"},
  "src_vpc":{"project_id":"example-labs","subnetwork_name":"default",
  "vpc_name":"default"},"start_time":"2023-02-13T22:38:29.024032655Z"},
  "logName":"projects/example-labs/logs/compute.googleapis.com%2Fvpc_flows",
  "receiveTimestamp":"2023-02-13T22:38:37.443315735Z","resource":{"labels":
  {"location":"us-east1-b","project_id":"example-labs",
    "subnetwork_id":"00000000000000000000","subnetwork_name":"default"},
    "type":"gce_subnetwork"},"timestamp":"2023-02-13T22:38:37.443315735Z"}
Lebenszyklusstatus einer Parsererweiterung
Parsererweiterungen haben die folgenden Lebenszyklusstatus:
DRAFT: Neu erstellte Parsererweiterung, die noch nicht eingereicht wurde.VALIDATING: Google SecOps validiert die Zuordnungsanweisungen anhand vorhandener Rohlogs, um sicherzustellen, dass Felder fehlerfrei geparst werden.LIVE: Die Parser-Erweiterung hat die Validierung bestanden und ist jetzt in der Produktion. Sie extrahiert und transformiert Daten aus eingehenden Rohlogs in UDM-Einträge.FAILED: Die Validierung der Parser-Erweiterung ist fehlgeschlagen.
Weitere Informationen zu den Syslog-Extraktorfeldern
Mit den Syslog-Extraktor-Feldern können Sie den Syslog-Header von einem strukturierten Log trennen. Dazu definieren Sie den Grok, den regulären Ausdruck und ein benanntes Token im Muster des regulären Ausdrucks, um die Ausgabe zu speichern.
Syslog-Extraktorfelder definieren
Die Werte in den Feldern Syslog und Ziel definieren zusammen, wie die Parsererweiterung den Syslog-Header vom strukturierten Teil eines Rohlogs trennt. Im Feld Syslog definieren Sie einen Ausdruck mit einer Kombination aus Grok- und regulärer Ausdruckssyntax. Der Ausdruck enthält einen Variablennamen, der den strukturierten Teil des Rohlogs identifiziert. Geben Sie im Feld Ziel den Variablennamen an.
Das folgende Beispiel veranschaulicht, wie diese Felder zusammenarbeiten.
Dies ist ein Beispiel für ein Rohlog:
<13>1 2022-09-14T15:03:04+00:00 fieldname fieldname - - - {"timestamp": "2021-03-14T14:54:40.842152+0000","flow_id": 1885148860701096, "src_ip": "10.11.22.1","src_port": 51972,"dest_ip": "1.2.3.4","dest_port": 55291,"proto": "TCP"}
Das Rohprotokoll enthält die folgenden Abschnitte:
Syslog-Header:
<13> 2022-09-14T15:03:04+00:00 fieldname fieldname - - -JSON-formatiertes Ereignis:
{"timestamp":
"2021-03-14T14:54:40.842152+0000","flow_id": 1885148860701096, "src_ip":
"10.11.22.1","src_port": 51972,"dest_ip": "1.2.3.4","dest_port":
55291,"proto": "TCP"}
Wenn Sie den Syslog-Header vom JSON-Teil des Rohlogs trennen möchten, verwenden Sie den folgenden Beispielausdruck im Feld Syslog:
%{TIMESTAMP_ISO8601} %{WORD} %{WORD} ([- ]+)?%{GREEDYDATA:msg}
- Dieser Teil des Ausdrucks identifiziert den Syslog-Header:
%{TIMESTAMP\_ISO8601} %{WORD} %{WORD} ([- ]+)? - Dieser Teil des Ausdrucks erfasst das JSON-Segment des Rohlogs:
%{GREEDYDATA:msg}
Dieses Beispiel enthält den Variablennamen msg. Sie wählen den Variablennamen aus.
Die Parsererweiterung extrahiert das JSON-Segment des Rohlogs und weist es der Variablen msg zu.
Geben Sie im Feld Ziel den Variablennamen msg ein. Der in der Variablen msg gespeicherte Wert wird in die Anweisungen zur Zuordnung von Datenfeldern eingegeben, die Sie in der Parser-Erweiterung erstellen.
Im Beispiel für das Rohlog wird das folgende Segment in die Datenzuordnungsanweisung eingegeben:
{"timestamp": "2021-03-14T14:54:40.842152+0000","flow_id": 1885148860701096, "src_ip": "10.11.22.1","src_port": 51972,"dest_ip": "1.2.3.4","dest_port": 55291,"proto": "TCP"}
Im Folgenden sehen Sie die ausgefüllten Felder Syslog und Ziel:
Die folgende Tabelle enthält weitere Beispiele mit Beispielprotokollen, dem Syslog-Extraktionsmuster, dem Ziel-Variablennamen und dem Ergebnis.
| Beispiel für ein Rohprotokoll | Syslog-Feld | Zielfeld | Ergebnis |
|---|---|---|---|
<13>1 2022-07-14T15:03:04+00:00 suricata suricata - - - {\"timestamp\": \"2021-03-14T14:54:40.842152+0000\",\"flow_id\": 1885148860701096,\"in_iface\": \"enp94s0\",\"event_type\": \"alert\",\"vlan\": 522,\"src_ip\": \"1.1.2.1\",\"src_port\": 51972,\"dest_ip\": \"1.2.3.4\",\"dest_port\": 55291,\"proto\": \"TCP\"}" |
%{TIMESTAMP_ISO8601} %{WORD} %{WORD} ([- ]+)?%{GREEDYDATA:msg} |
msg | field_mappings {
field: "msg"
value: "{\"timestamp\": \"2021-03-14T14:54:40.842152+0000\",\"flow_id\": 1885148860701096,\"in_iface\": \"enp94s0\",\"event_type\": \"alert\",\"vlan\": 522,\"src_ip\": \"1.1.2.1\",\"src_port\": 51972,\"dest_ip\": \"1.2.3.4\",\"dest_port\": 55291,\"proto\": \"TCP\"}"
}
|
<13>1 2022-07-14T15:03:04+00:00 suricata suricata - - - {\"timestamp\": \"2021-03-14T14:54:40.842152+0000\"} - - - {\"timestamp\": \"2021-03-14T14:54:40.842152+0000\",\"flow_id\": 1885148860701096,\"in_iface\": \"enp94s0\",\"event_type\": \"alert\",\"vlan\": 522,\"src_ip\": \"1.1.2.1\",\"src_port\": 51972,\"dest_ip\": \"1.2.3.4\",\"dest_port\": 55291,\"proto\": \"TCP\"} |
%{TIMESTAMP_ISO8601} %{WORD} %{WORD} ([- ]+)?%{GREEDYDATA:msg1} ([- ]+)?%{GREEDYDATA:msg2} |
msg2 | field_mappings {
field: "msg2"
value: "{\"timestamp\": \"2021-03-14T14:54:40.842152+0000\",\"flow_id\": 1885148860701096,\"in_iface\": \"enp94s0\",\"event_type\": \"alert\",\"vlan\": 522,\"src_ip\": \"1.1.2.1\",\"src_port\": 51972,\"dest_ip\": \"1.2.3.4\",\"dest_port\": 55291,\"proto\": \"TCP\"}"
} |
"<13>1 2022-07-14T15:03:04+00:00 suricata suricata - - - {\"timestamp\": \"2021-03-14T14:54:40.842152+0000\"} - - - {\"timestamp\": \"2021-03-14T14:54:40.842152+0000\",\"flow_id\": 1885148860701096,\"in_iface\": \"enp94s0\",\"event_type\": \"alert\",\"vlan\": 522,\"src_ip\": \"1.1.2.1\",\"src_port\": 51972,\"dest_ip\": \"1.2.3.4\",\"dest_port\": 55291,\"proto\": \"TCP\"}" |
%{TIMESTAMP_ISO8601} %{WORD} %{WORD} ([- ]+)?%{GREEDYDATA:message} ([- ]+)?%{GREEDYDATA:msg2} |
msg2 | Error - message already exists in state and not overwritable. |
Weitere Informationen zum Zuweisen von UDM-metadata.event_type-Feldern
Wenn Sie einem UDM-Eintrag ein UDM-metadata.event_type-Feld zuweisen, wird geprüft, ob die erforderlichen zugehörigen Felder im UDM-Eintrag vorhanden sind. Für jeden UDM-metadata.event_type ist ein anderer Satz zugehöriger Felder erforderlich. Ein USER_LOGIN-Ereignis ohne user ist beispielsweise nicht nützlich.
Wenn ein erforderliches zugehöriges Feld fehlt, gibt die UDM-Validierung einen Fehler zurück:
  "error": {
    "code": 400,
    "message": "Request contains an invalid argument.",
    "status": "INVALID_ARGUMENT"
  }
Ein Grok-Parser gibt einen detaillierteren Fehler zurück:
  generic::unknown:
  invalid event 0: LOG_PARSING_GENERATED_INVALID_EVENT:
  "generic::invalid_argument: udm validation failed: target field is not set"
Wenn Sie die erforderlichen Felder für ein zuzuweisendes UDM-event_type ermitteln möchten, verwenden Sie die folgenden Ressourcen. Die Einführungsleitfäden ergänzen den UDM-Nutzungsleitfaden, indem sie die mindestens erforderlichen UDM-Felder enthalten, die zum Ausfüllen eines bestimmten UDM-metadata.event_type erforderlich sind.
Google SecOps-Dokumentation: UDM-Nutzungsleitfaden – Erforderliche und optionale UDM-Felder für jeden Ereignistyp
Öffnen Sie beispielsweise das Dokument und suchen Sie nach dem Ereignistyp GROUP_CREATION.
Sie sollten die folgenden Mindest-UDM-Felder sehen, die als UDM-Objekt dargestellt werden:
  {
      "metadata": {
          "event_timestamp": "2023-07-03T13:01:10.957803Z",
          "event_type": "GROUP_CREATION"
      },
      "principal": {
          "user": {
              "userid": "pinguino"
          }
      },
      "target": {
          "group": {
              "group_display_name": "foobar_users"
          }
      }
  }
Anleitung für Code-Snippets erstellen
Mit dem Code-Snippet-Ansatz können Sie mit einer Logstash-ähnlichen Syntax definieren, wie Werte aus dem Rohlog extrahiert und transformiert und UDM-Feldern im UDM-Eintrag zugewiesen werden.
Bevor Sie eine Parsererweiterung mit dem Code-Snippet-Ansatz erstellen, müssen Sie die folgenden Abschnitte durchgearbeitet haben:
- Parser-Erweiterungen erstellen
- Jetzt starten
- Wählen Sie den Erweiterungsansatz aus und wählen Sie die Option Code-Snippets schreiben (oder Code-Snippet schreiben) aus.
Die nächsten Schritte zum Definieren der Parser-Erweiterung sind:
- Tipps und Best Practices finden Sie unter Tipps und Best Practices zum Schreiben von Anweisungen für Code-Snippets.
- Anweisung für Code-Snippet erstellen
- Anleitung zum Einreichen eines Code-Snippets
Tipps und Best Practices für das Schreiben von Anweisungen für Code-Snippets
Anweisungen für Code-Snippets können aufgrund von Problemen wie falschen Grok-Mustern, fehlgeschlagenen Umbenennungs- oder Ersetzungsvorgängen oder Syntaxfehlern fehlschlagen. Tipps und Best Practices finden Sie hier:
Anweisung für Code-Snippet erstellen
Für Code-Snippet-Anweisungen werden dieselbe Syntax und dieselben Abschnitte wie für den Standardparser (oder benutzerdefinierten Parser) verwendet:
- Section 1. Daten aus dem Rohprotokoll extrahieren.
- Section 2. Transformieren Sie die extrahierten Daten.
- Section 3. Weisen Sie einem UDM-Feld einen oder mehrere Werte zu.
- Section 4. Binden Sie UDM-Ereignisfelder an den Schlüssel
@output.
So erstellen Sie eine Parser-Erweiterung mit dem Code-Snippet-Ansatz:
- Geben Sie auf der Seite Parsererweiterung im Bereich CBN-Snippet ein Code-Snippet ein, um die Parsererweiterung zu erstellen.
- Klicken Sie auf Validieren, um die Zuordnungsanweisungen zu validieren.
Beispiele für Anweisungen in Code-Snippets
Das folgende Beispiel zeigt ein Code-Snippet.
Dies ist ein Beispiel für das Rohprotokoll (zusätzliche jsonPayload-Felder wurden aus Gründen der Übersichtlichkeit weggelassen):
  {
      "insertId": "00000000",
      "jsonPayload": {
          "packets_sent": "4"
      },
      "timestamp": "2022-05-03T01:45:00.150614953Z"
  }
Hier ist ein Beispiel für ein Code-Snippet, das den Wert in jsonPayload.packets_sent dem UDM-Feld network.sent_bytes zuordnet:
filter {
  mutate {
    replace => {
      "jsonPayload.packets_sent" => ""
    }
  }
  # Section 1. extract data from the raw JSON log
  json {
    source => "message"
    array_function => "split_columns"
    on_error => "_not_json"
  }
  if [_not_json] {
    drop {
      tag => "TAG_UNSUPPORTED"
    }
  } else {
    # Section 2. transform the extracted data
    if [jsonPayload][packets_sent] not in ["", 0] {
      mutate {
        convert => {
          "jsonPayload.packets_sent" => "uinteger"
        }
        on_error => "_exception1"
      }
      # Section 3. assign the value to a UDM field
      mutate {
        Replace => {
          "event.idm.read_only_udm.network.sent_bytes" => "jsonPayload.packets_sent"
        }
        on_error => "_exception2"
      }
      if ![_exception1] and![_exception2] {
        # Section 4. Bind the UDM fields to the @output key
        mutate {
          merge => {
            "@output" => "event"
          }
        }
      }
    }
  }
}
Anleitung für Code-Snippet einreichen
Klicken Sie auf Senden, um die Zuordnungsanweisungen zu speichern.
Google SecOps validiert die Zuordnungsanweisungen.
- Wenn die Validierung erfolgreich ist, ändert sich der Status in Live und die Zuordnungsanweisungen beginnen mit der Verarbeitung eingehender Logdaten.
- Wenn die Validierung fehlschlägt, ändert sich der Status zu Fehlgeschlagen und im Feld „Rohprotokoll“ wird ein Fehler angezeigt.
Vorhandene Parsererweiterungen verwalten
Sie können vorhandene Parser-Erweiterungen ansehen, bearbeiten, löschen und den Zugriff darauf steuern.
Vorhandene Parsererweiterung ansehen
- Wählen Sie in der Navigationsleiste Einstellungen > Datenverwaltung > Parser aus. Wenn Sie eine reine SIEM-Plattform verwenden, rufen Sie die Einstellungen > Parser auf.
- Suchen Sie in der Liste der Parser nach dem Parser (Logtyp), den Sie sich ansehen möchten.
Parser mit einer Parsererweiterung sind durch den Text
EXTENSION(oderEXTN) neben ihrem Namen gekennzeichnet. Gehen Sie zu dieser Zeile und klicken Sie auf das Menü > Parser erweitern > Erweiterung ansehen.
Der Tab Benutzerdefinierten/vordefinierten Parser ansehen > Erweiterung (oder der Tab Erweiterungen) wird angezeigt und enthält Details zur Parsererweiterung. Im Zusammenfassungsbereich wird standardmäßig die Parsererweiterung
LIVEangezeigt.
Parser-Erweiterung bearbeiten
Öffnen Sie den Tab Benutzerdefinierten/vordefinierten Parser ansehen > Erweiterung (oder den Tab Erweiterungen), wie unter Vorhandene Parsererweiterung ansehen beschrieben.
Klicken Sie auf den Button Erweiterung bearbeiten (oder Bearbeiten).
Die Seite Parser-Erweiterung wird angezeigt.
Bearbeiten Sie die Parser-Erweiterung.
Wenn Sie die Bearbeitung abbrechen und die Änderungen verwerfen möchten, klicken Sie auf Entwurf verwerfen (oder Erweiterung verwerfen).
Wenn Sie die Parser-Erweiterung löschen möchten, klicken Sie auf Fehlerhafte Erweiterung löschen (oder Erweiterung löschen).
Wenn Sie mit der Bearbeitung der Parser-Erweiterung fertig sind, klicken Sie auf Senden.
Der Validierungsprozess wird ausgeführt, um die neue Konfiguration zu validieren.
Parser-Erweiterung löschen
Öffnen Sie den Tab Benutzerdefinierten/vordefinierten Parser ansehen > Erweiterung (oder den Tab Erweiterungen), wie unter Vorhandene Parsererweiterung ansehen beschrieben.
Klicken Sie auf Erweiterung löschen.
Zugriff auf Parser-Erweiterungen steuern
Standardmäßig können Nutzer mit der Rolle Administrator auf Parser-Erweiterungen zugreifen. Sie können festlegen, wer Parser-Erweiterungen ansehen und verwalten darf. Weitere Informationen zum Verwalten von Nutzern und Gruppen oder zum Zuweisen von Rollen finden Sie unter Rollenbasierte Zugriffssteuerung.
Die neuen Rollen in Google SecOps sind in der folgenden Tabelle zusammengefasst.
| Feature | Aktion | Beschreibung |
|---|---|---|
| Parser | Löschen | Parser-Erweiterungen löschen. |
| Parser | Bearbeiten | Parser-Erweiterungen erstellen und bearbeiten |
| Parser | Ansehen | Parser-Erweiterungen ansehen. |
UDM-Feldzuordnungen mithilfe von Parsererweiterungen entfernen
Sie können Parser-Erweiterungen verwenden, um eine vorhandene UDM-Feldzuordnung zu entfernen.
- Klicken Sie auf Einstellungen > Datenverwaltung > Parser. Wenn Sie eine reine SIEM-Plattform verwenden, rufen Sie die Einstellungen > Parser auf.
- Verwenden Sie eine der folgenden Methoden, um die Seite Parser-Erweiterung aufzurufen:
- Klicken Sie bei einer vorhandenen Erweiterung auf Menü > Parser erweitern > Erweiterung ansehen.
- Klicken Sie für neue Parser-Erweiterungen auf Menü > Parser erweitern > Erweiterung erstellen.
Wählen Sie Code-Snippets schreiben (oder Code-Snippet schreiben) als Erweiterungsmethode aus, um ein benutzerdefiniertes Code-Snippet hinzuzufügen, mit dem Werte für bestimmte UDM-Felder entfernt werden.
Wenn Sie eine vorhandene Erweiterung verwenden, klicken Sie auf dem Tab Erweiterung (oder Erweiterungen) auf Erweiterung bearbeiten (oder Bearbeiten) und fügen Sie dann das Code-Snippet hinzu.
Beispiel-Snippets finden Sie unter Code-Snippet – Vorhandene Zuordnungen entfernen.
Folgen Sie der Anleitung unter Anleitung zum Einreichen eines Code-Snippets, um die Erweiterung einzureichen.
Umgang mit Zeitzonen und Formatierung von Zeitstempeln
Google SecOps standardisiert und serialisiert Zeitstempel im RFC 3339-UTC-Format mit einer Genauigkeit von Mikrosekunden (YYYY-MM-DDTHH:MM:SS.ffffffZ). Wenn Quelllogs nur eine Genauigkeit auf Sekundenebene bieten, füllt die Plattform fehlende Nachkommastellen automatisch mit nachgestellten Nullen (.000000Z) auf, um die Einheitlichkeit des Schemas zu wahren.
Wenn ein Ereigniszeitstempel vor der Aufnahmezeit (ingested_timestamp < event_timestamp) liegt, tritt die Abweichung in der Regel auf, wenn eine Quelle lokale Zeitstempel ohne ISO-Zeitzonenversatz (standardmäßig UTC) ausgibt oder eine Zeitabweichung auftritt. Sie können Zeitzonenabweichungen mit einer der folgenden Methoden beheben:
Zeitstempel in einer Parser-Erweiterung anpassen: Verwenden Sie den Filter
datein einer Code-Snippet-Parser-Erweiterung, um die Quellzeitzone anzugeben:if [raw_log] =~ /EST/ { date { match => [ "timestamp_str", "MMM dd HH:mm:ss" ] timezone => "America/New_York" target => "event.metadata.event_timestamp" } }Zeitzonenüberschreibung für Forwarder-Collector konfigurieren: Gehen Sie zu Einstellungen > Datenverwaltung > Forwarder, bearbeiten Sie den Ziel-Collector, aktivieren Sie Zeitzone überschreiben und wählen Sie im Menü Zeitzone die IANA-Zeitzone der Quelle aus (z. B.
Europe/Paris), um Zeitstempel während der Aufnahme automatisch anzupassen.
Benötigen Sie weitere Hilfe? Antworten von Community-Mitgliedern und Google SecOps-Experten erhalten