


Informazioni sulla disponibilità dei dati per la ricerca
Questo documento descrive in dettaglio il ciclo di vita dell'importazione dati, inclusi il flusso di dati end-to-end e la latenza, e il modo in cui questi fattori influiscono sulla disponibilità dei dati acquisiti di recente per le query e l'analisi.
Importa ed elabora i dati in Google SecOps
Questa sezione descrive in che modo Google SecOps importa, elabora e analizza i dati di sicurezza.
Acquisizione dei dati
La pipeline di acquisizione dei dati inizia con la raccolta dei dati di sicurezza non elaborati da fonti quali:
- Log di sicurezza dei tuoi sistemi interni
- Dati archiviati in Cloud Storage
- Il tuo Security Operations Center (SOC) e altri sistemi interni
Google SecOps trasferisce questi dati alla piattaforma utilizzando uno dei suoi metodi di importazione sicuri.
I metodi di importazione principali sono:
Importazione Google Cloud diretta
Google SecOps utilizza l'importazione Google Cloud diretta per estrarre automaticamente i log e i dati di telemetria dalla tua organizzazione Google Cloud, inclusi i log di Cloud Logging, i metadati di Cloud Asset Inventory e i risultati di Security Command Center Premium.
API di importazione
Invia i dati direttamente a Google SecOps utilizzando le sue API di importazione REST pubbliche. Utilizza questo metodo per le integrazioni personalizzate o per inviare dati come log non strutturati o eventi UDM (Unified Data Model) preformattati.
Agente Bindplane
Puoi eseguire il deployment del versatile agente Bindplane nel tuo ambiente (on-premise o in altri cloud) per raccogliere i log da un'ampia gamma di origini e inoltrarli a Google SecOps.
Feed di dati
In Google SecOps, configuri i feed di dati per estrarre i log da origini di terze parti, come bucket spazio di archiviazione sul cloud di terze parti specifici (ad esempio Amazon S3) o API di terze parti (ad esempio Okta o Microsoft 365).
Normalizzazione e arricchimento dei dati
Una volta che i dati arrivano in Google SecOps, la piattaforma li elabora attraverso le seguenti fasi:
Analisi e normalizzazione
Un parser elabora innanzitutto i dati di log non elaborati per convalidarli, estrarli e trasformarli dal formato originale al formato UDM standardizzato. Analisi e normalizzazione ti consentono di analizzare origini dati disparate (ad esempio log del firewall, dati degli endpoint, log del cloud) utilizzando un unico schema coerente. Il log non elaborato originale rimane archiviato insieme all'evento UDM.
Indicizzazione
Dopo la normalizzazione, Google SecOps indicizza i dati UDM per offrire velocità di query elevate su set di dati di grandi dimensioni, rendendo gli eventi UDM ricercabili.
Aliasing e arricchimento UDM
- Google SecOps esegue l'aliasing e l'arricchimento UDM per arricchire gli eventi UDM con un contesto prezioso, identificando e aggiungendo dati di contesto e indicatori per le entità dei log. Ad esempio, collega l'
login namedi un utente ai suoi variIP addresses,hostnameseMAC addresses. - Geolocalizzazione: Google SecOps arricchisce gli indirizzi IP con dati di geolocalizzazione.
- Google SecOps esegue l'aliasing e l'arricchimento UDM per arricchire gli eventi UDM con un contesto prezioso, identificando e aggiungendo dati di contesto e indicatori per le entità dei log. Ad esempio, collega l'
Arricchimento ECG
Google SecOps esegue l'aliasing ECG, che unisce il contesto di più origini (come IdP, CMDB e threat intelligence) per creare un profilo di entità consolidato nel grafo del contesto delle entità.
Threat intelligence: Google SecOps confronta automaticamente i dati sugli eventi con la vasta threat intelligence di Google, incluse fonti come Google Threat Intelligence e Navigazione sicura, per identificare minacce dannose note, come
domains,IP addressesefile hashes.WHOIS: Google SecOps arricchisce i nomi di dominio con le informazioni di registrazione pubblica WHOIS.
Disponibilità dei dati per l'analisi
Dopo essere stati elaborati e arricchiti, i dati UDM sono immediatamente disponibili per l'analisi:
Rilevamento in tempo reale
Il motore di rilevamento esegue automaticamente le regole personalizzate e create da Google abilitate per le regole in tempo reale sui dati in entrata in tempo reale per identificare le minacce e generare avvisi.
Ricerca e indagine
Un analista può utilizzare i metodi di ricerca per eseguire ricerche in tutti questi dati normalizzati e arricchiti. Ad esempio, utilizzando la ricerca UDM per passare da un'entità correlata all'altra (ad esempio da un
useral relativoasset, fino a undomaindannoso) ed esaminare gli avvisi.
Metodi di ricerca
Google SecOps offre diversi metodi per la ricerca dei dati, ognuno con uno scopo diverso.
Ricerca UDM
La ricerca UDM è il metodo di ricerca principale e più veloce, utilizzato per la maggior parte delle indagini.
- Cosa cerca: esegue query sugli eventi UDM normalizzati e indicizzati. Poiché tutti i dati vengono analizzati in questo formato standard, puoi scrivere una query per trovare la stessa attività (ad esempio un accesso) in tutti i tuoi diversi prodotti (ad esempio Windows, Okta, Linux).
- Come funziona: utilizzi una sintassi specifica per eseguire query su campi, operatori e valori.
Esempio:
principal.hostname = "win-server" AND target.ip = "10.1.2.3"I risultati sono in genere disponibili entro 2-15 minuti dall'importazione.
Ricerca log non elaborati
Utilizza la ricerca nei log non elaborati per trovare nel messaggio di log originale non analizzato qualcosa che potrebbe non essere stato mappato a un campo UDM. Questo metodo di ricerca è ottimizzato per ricerche ad alta velocità e in genere restituisce risultati in meno di 2 secondi per indicatori specifici come hash di file o indirizzi IP.
- Cosa cerca: analizza il testo originale non elaborato dei log prima che venissero analizzati e normalizzati. Questa opzione è utile per trovare stringhe specifiche, argomenti della riga di comando o altri artefatti che non sono campi UDM indicizzati.
- Come funziona: utilizza il prefisso
raw =. Può essere più lenta della ricerca UDM perché non esegue ricerche nei campi indicizzati. - Esempio (stringa):
raw = "PsExec.exe" - Esempio (regex):
raw = /admin\$/
Ricerca statistiche
Utilizza la ricerca di statistiche per le tendenze a lungo termine che aggregano milioni di righe di dati. Poiché la piattaforma deve eseguire analisi statistiche e raggruppamenti, i tempi di caricamento di queste query saranno più lunghi.
Ricerca in linguaggio naturale (Gemini)
La ricerca in linguaggio naturale (Gemini) ti consente di utilizzare un linguaggio semplice per porre domande, che Gemini traduce poi in una query UDM formale.
- Cosa cerca: fornisce un'interfaccia di conversazione per eseguire query sui dati UDM.
- Come funziona: digiti una domanda e Gemini genera per te la query di ricerca UDM sottostante, che puoi eseguire o perfezionare.
- Esempio: "Mostrami tutti gli accessi non riusciti dell'utente 'bob' nelle ultime 24 ore"
Ricerca SOAR
La ricerca SOAR è specifica per i componenti SOAR. Lo utilizzi per gestire gli incidenti di sicurezza, non per cercare nei log.
- Cosa cerca: cerca Case (Richieste) ed Entity (Entità) (come utenti, asset, indirizzi IP) all'interno della piattaforma SOAR.
- Come funziona: puoi utilizzare filtri di testo libero o basati su campi per trovare le segnalazioni, ad esempio, in base all'ID, al nome dell'avviso, allo stato e all'utente assegnato.
- Esempio: cerca
CaseIds:180oAlertName:Brute Force
Pipeline di acquisizione dei dati per la disponibilità della ricerca
La disponibilità dei dati end-to-end è il tempo totale che intercorre tra il momento in cui si verifica un evento e quello in cui è disponibile per la ricerca o l'esecuzione delle regole in Google SecOps. Questa latenza è la somma dei seguenti due componenti:
Ritardo di disponibilità lato origine: il tempo che intercorre tra il momento in cui si verifica un evento e quello in cui il sistema di origine rende disponibili i dati di log per l'importazione. Questo ritardo dipende dall'architettura, dall'elaborazione, dal raggruppamento in batch e dalle pianificazioni di pubblicazione delle API del sistema di origine. Google SecOps non può influenzare questo ritardo. Alcuni esempi sono i ritardi quando un sistema scrive i log in un bucket di archiviazione o li pubblica in un endpoint API.
Tempo di elaborazione di Google SecOps: il tempo necessario a Google SecOps per elaborare i dati dopo averli ricevuti. Questa durata include le fasi interne della pipeline, come importazione, analisi, normalizzazione, indicizzazione e arricchimento.
Devi considerare entrambi i componenti quando risolvi i problemi relativi alle tempistiche di visibilità dei dati.
Ritardi provenienti dall'origine dati
I seguenti fattori possono influire sul ritardo della disponibilità lato origine:
- Elaborazione batch: alcuni sistemi generano i log in batch a intervalli prestabiliti (ad esempio, ogni ora).
- Latenza dell'API: l'API di origine può presentare ritardi intrinseci nel rendere disponibili per le query i nuovi eventi.
- Ora di creazione e pubblicazione dell'evento: il timestamp di un evento in un log potrebbe essere molto precedente al timestamp in cui il log viene finalizzato e diventa disponibile per la raccolta.
- Limitazione: i limiti di frequenza dell'API lato origine possono rallentare il recupero dei dati.
- Backfill iniziale: l'importazione e la pubblicazione di grandi volumi di dati storici richiedono tempo.
Questi ritardi variano in base all'origine dati e al tipo di log. Per maggiori dettagli sui metodi di acquisizione dei dati, consulta la panoramica sull'acquisizione dei dati. Il Riferimento API di gestione dei feed descrive considerazioni specifiche per i tipi di log come Microsoft Graph, SentinelOne, Okta e CrowdStrike.
Tempo di elaborazione di Google SecOps
Il sistema elabora i dati appena importati attraverso diversi passaggi. La durata di questi passaggi determina quando i dati appena importati diventano disponibili per le query e l'analisi.
La tabella seguente illustra i passaggi di elaborazione dei dati appena importati in base al metodo di ricerca. I dati appena importati diventano disponibili per la ricerca una volta completati questi passaggi.
| Metodo di ricerca | Dati oggetto della ricerca | Fasi di elaborazione che contribuiscono al tempo di disponibilità |
|---|---|---|
| Eventi UDM normalizzati e arricchiti |
|
|
| Ricerca log non elaborati | Testo del log originale non analizzato |
|
| Detection Engine (Rules) | Eventi normalizzati |
|
| Ricerca SOAR | Casi ed entità |
Si tratta di un ciclo di vita diverso, in quanto cerca avvisi e casi, non log. L'ora si basa su:
|
Esempio di flusso di dati
L'esempio seguente mostra come Google SecOps importa, elabora, migliora e analizza i tuoi dati di sicurezza, rendendoli disponibili per ricerche e ulteriori analisi.
Esempio di passaggi per il trattamento dei dati
- Recupera i dati di sicurezza da servizi cloud come Amazon S3 o da Google Cloud. Google SecOps cripta questi dati in transito.
- Separa e archivia i dati di sicurezza criptati nel tuo account. L'accesso è limitato a te e a un numero limitato di dipendenti Google per l'assistenza, lo sviluppo e la manutenzione dei prodotti.
- Analizza e convalida i dati di sicurezza non elaborati, semplificandone l'elaborazione e la visualizzazione.
- Normalizza e indicizza i dati per ricerche rapide.
- Archivia i dati analizzati e indicizzati nel tuo account.
- Arricchisce con i dati di contesto.
- Offre agli utenti un accesso sicuro per cercare ed esaminare i propri dati di sicurezza.
- Confronta i tuoi dati di sicurezza con il database di malware di Google Threat Intelligence per identificare le corrispondenze. In Ricerca SIEM, apri la scheda Panoramica per un dominio, un hash di file o un indirizzo IP e fai clic su Contesto VT per visualizzare le informazioni di Google Threat Intelligence. Google SecOps non condivide i tuoi dati di sicurezza con Google Threat Intelligence.
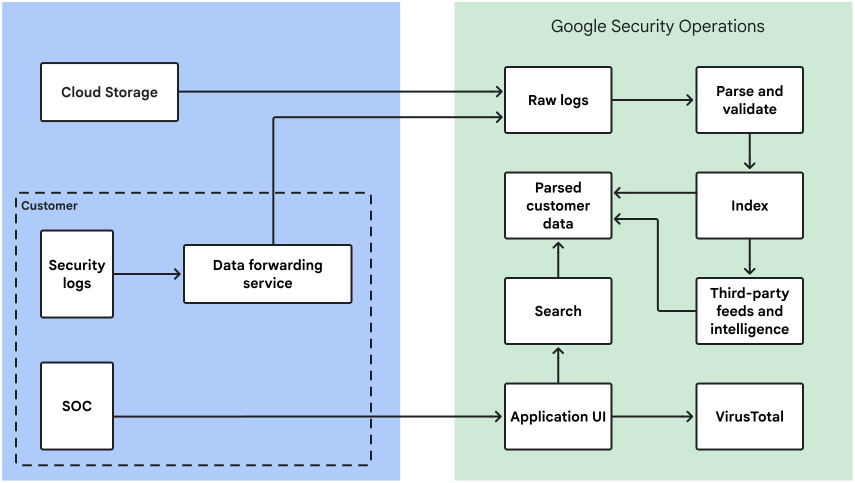
Esempi di tempo previsto per la disponibilità nella Ricerca
Il tempo previsto prima che i dati appena importati diventino disponibili per la Ricerca è la somma delle durate del flusso lungo il flusso di dati.
Ad esempio, un tempo medio tipico per la disponibilità dei dati nella ricerca UDM è di circa 5 minuti e 30 secondi dal momento in cui i dati vengono inviati al servizio di importazione di Google SecOps.
| Passaggio del flusso di dati | Descrizione | Durata del flusso |
|---|---|---|
| Cloud Storage in Log non elaborati | Importa i log non elaborati da Cloud Storage. | Meno di 30 secondi |
| Log di sicurezza in Servizio di forwarding dei dati | Trasmette i log di sicurezza dai sistemi interni alla piattaforma. | N/D |
| Servizio di inoltro dei dati in Log non elaborati | Invia i dati di sicurezza non elaborati ricevuti da varie origini alla pipeline di importazione. | Meno di 30 secondi |
| Log non elaborati in Analizza e convalida | Analizza e convalida i log non elaborati nel formato UDM. | Meno di 3 minuti |
| Analisi e convalida fino all'indicizzazione | Indicizza i dati UDM analizzati per una ricerca rapida. | N/D |
| Indice in Dati dei clienti analizzati | Rende i dati indicizzati disponibili come dati dei clienti analizzati per l'analisi. | Meno di 2 minuti |
Risoluzione dei problemi
Questa sezione fornisce indicazioni per la risoluzione dei problemi.
Latenza e limiti
I ritardi di elaborazione e visualizzazione all'interno della piattaforma Google SecOps sono soggetti ai seguenti limiti di architettura dopo che Google SecOps riceve i dati:
- Visibilità nella ricerca: da 2 a 15 minuti dopo l'importazione.
- Esecuzione della regola: da 5 a 10 minuti dopo l'arrivo dell'evento.
Hai bisogno di ulteriore assistenza? Ricevi risposte dai membri della community e dai professionisti di Google SecOps.