


Datenverfügbarkeit für die Suche
In diesem Dokument wird der Lebenszyklus der Datenaufnahme beschrieben, einschließlich des End-to-End-Datenflusses und der Latenz. Außerdem wird erläutert, wie sich diese Faktoren auf die Verfügbarkeit kürzlich aufgenommener Daten für Abfragen und Analysen auswirken.
Daten in Google SecOps aufnehmen und verarbeiten
In diesem Abschnitt wird beschrieben, wie Google SecOps Sicherheitsdaten aufnimmt, verarbeitet und analysiert.
Datenaufnahme
Die Pipeline für die Datenaufnahme beginnt mit der Erfassung Ihrer Sicherheitsrohdaten aus Quellen wie:
- Sicherheitsprotokolle aus Ihren internen Systemen
- In Cloud Storage gespeicherte Daten
- Ihr Security Operations Center (SOC) und andere interne Systeme
Google SecOps überträgt diese Daten über eine seiner sicheren Aufnahmemethoden auf die Plattform.
Die primären Aufnahmemethoden sind:
Direkte Google Cloud Aufnahme
Google SecOps verwendet die direkte Google Cloud Aufnahme, um automatisch Logs und Telemetriedaten aus der Google CloudIhrer Organisation abzurufen, einschließlich Cloud Logging, Cloud Asset Inventory-Metadaten und Security Command Center Premium-Ergebnissen.
Ingestions-APIs
Senden Sie Daten über die öffentlichen REST-Ingestions-APIs direkt an Google SecOps. Diese Methode wird für benutzerdefinierte Integrationen oder zum Senden von Daten als unstrukturierte Logs oder vorformatierte UDM-Ereignisse (Unified Data Model) verwendet.
Bindplane-Agent
Sie können den vielseitigen Bindplane-Agent in Ihrer Umgebung (lokal oder in anderen Clouds) bereitstellen, um Logs aus einer Vielzahl von Quellen zu erfassen und an Google SecOps weiterzuleiten.
Datenfeeds
In Google SecOps konfigurieren Sie Datenfeeds, um Logs aus Drittanbieterquellen abzurufen, z. B. aus bestimmten Cloud-Speicher-Buckets von Drittanbietern (wie Amazon S3) oder APIs von Drittanbietern (wie Okta oder Microsoft 365).
Normalisierung und Datenanreicherung
Sobald Daten in Google SecOps eingehen, werden sie von der Plattform in den folgenden Phasen verarbeitet:
Parsen und Normalisierung
Ein Parser verarbeitet zuerst Logrohdaten, um die Daten aus ihrem ursprünglichen Format zu validieren, zu extrahieren und in das standardisierte UDM zu transformieren. Mit Parsing und Normalisierung können Sie unterschiedliche Datenquellen (z. B. Firewall-Logs, Endpunktdaten, Cloud-Logs) mit einem einzigen, konsistenten Schema analysieren. Das ursprüngliche Rohlog bleibt zusammen mit dem UDM-Ereignis gespeichert.
Indexierung
Nach der Normalisierung indexiert Google SecOps die UDM-Daten, um schnelle Abfragen für riesige Datasets zu ermöglichen. Dadurch werden die UDM-Ereignisse durchsuchbar.
UDM-Aliasing und -Anreicherung
- Google SecOps führt UDM-Aliasing und -Anreicherung durch, um UDM-Ereignisse mit wertvollem Kontext anzureichern. Dazu werden Kontextdaten und Indikatoren für Logentitäten identifiziert und hinzugefügt. Beispielsweise wird die
login nameeines Nutzers mit seinen verschiedenenIP addresses,hostnamesundMAC addressesverknüpft. - Standortbestimmung: Google SecOps reichert IP-Adressen mit Standortdaten an.
- Google SecOps führt UDM-Aliasing und -Anreicherung durch, um UDM-Ereignisse mit wertvollem Kontext anzureichern. Dazu werden Kontextdaten und Indikatoren für Logentitäten identifiziert und hinzugefügt. Beispielsweise wird die
EKG-Anreicherung
Google SecOps führt ein ECG-Aliasing durch, bei dem Kontext aus mehreren Quellen (z. B. IdPs, CMDBs und Threat Intelligence) zusammengeführt wird, um ein konsolidiertes Entitätsprofil im Entitätskontextgraphen zu erstellen.
Threat Intelligence: Google SecOps vergleicht Ereignisdaten automatisch mit den umfangreichen Threat Intelligence-Daten von Google, einschließlich Quellen wie Google Threat Intelligence und Safe Browsing, um bekannte bösartige Bedrohungen wie
domains,IP addressesundfile hasheszu identifizieren.WHOIS: Google SecOps reichert Domainnamen mit ihren öffentlichen WHOIS-Registrierungsinformationen an.
Datenverfügbarkeit für die Analyse
Nach der Verarbeitung und Anreicherung sind UDM-Daten sofort für die Analyse verfügbar:
Echtzeiterkennung
Die Detection Engine wendet automatisch benutzerdefinierte und von Google erstellte Regeln, für die Live-Regeln aktiviert sind, auf eingehende Live-Daten an, um Bedrohungen zu identifizieren und Benachrichtigungen zu generieren.
Suche und Prüfung
Ein Analyst kann die Suchmethoden verwenden, um alle diese normalisierten und angereicherten Daten zu durchsuchen. Beispielsweise können Sie die UDM-Suche verwenden, um zwischen verwandten Entitäten (z. B. von einem
userzu einemassetund zu einem schädlichendomain) zu wechseln und Benachrichtigungen zu untersuchen.
Suchmethoden
Google SecOps bietet verschiedene Methoden zum Suchen in Ihren Daten, die jeweils einem anderen Zweck dienen.
UDM-Suche
Die UDM-Suche ist die primäre und schnellste Suchmethode, die für die meisten Untersuchungen verwendet wird.
- Wonach wird gesucht? Es werden die normalisierten und indexierten UDM-Ereignisse abgefragt. Da alle Daten in dieses Standardformat geparst werden, können Sie eine Abfrage schreiben, um dieselbe Aktivität (z. B. eine Anmeldung) in allen Ihren verschiedenen Produkten (z. B. Windows, Okta, Linux) zu finden.
- So funktionierts: Sie verwenden eine bestimmte Syntax, um Felder, Operatoren und Werte abzufragen.
Beispiel:
principal.hostname = "win-server" AND target.ip = "10.1.2.3"Die Ergebnisse sind in der Regel innerhalb von 2–15 Minuten nach der Aufnahme verfügbar.
Suche in Logs zu Rohdaten
Mit der Rohlogsuche können Sie in der ursprünglichen, nicht geparsten Logeintrag nach etwas suchen, das möglicherweise keinem UDM-Feld zugeordnet wurde. Diese Suchmethode ist für schnelle Suchen optimiert und liefert in der Regel in weniger als 2 Sekunden Ergebnisse für bestimmte Indikatoren wie Dateihashes oder IP-Adressen.
- Was wird durchsucht? Es wird der ursprüngliche Rohtext der Logs gescannt, bevor sie geparst und normalisiert wurden. Das ist nützlich, um bestimmte Strings, Befehlszeilenargumente oder andere Artefakte zu finden, die keine indexierten UDM-Felder sind.
- Funktionsweise: Sie verwenden das Präfix
raw =. Sie kann langsamer als die UDM-Suche sein, da keine indexierten Felder durchsucht werden. - Beispiel (String):
raw = "PsExec.exe" - Beispiel (regulärer Ausdruck):
raw = /admin\$/
Statistiksuche
Verwenden Sie die Statistiksuche für langfristige Trends, bei denen Millionen von Datenzeilen aggregiert werden. Da die Plattform statistische Analysen und Gruppierungen durchführen muss, sind die Ladezeiten für diese Abfragen länger.
Suche in natürlicher Sprache (Gemini)
Mit der Suche in natürlicher Sprache (Gemini) können Sie Fragen in einfachem Englisch stellen, die Gemini dann in eine formale UDM-Abfrage übersetzt.
- Wonach wird gesucht? Es bietet eine konversationelle Oberfläche zum Abfragen von UDM-Daten.
- So funktioniert es: Sie geben eine Frage ein und Gemini generiert die zugrunde liegende UDM-Suchanfrage für Sie, die Sie dann ausführen oder verfeinern können.
- Beispiel: „Zeige mir alle fehlgeschlagenen Anmeldungen des Nutzers ‚bob‘ in den letzten 24 Stunden.“
SOAR-Suche
Die SOAR-Suche ist spezifisch für SOAR-Komponenten. Sie verwenden es, um Sicherheitsvorfälle zu verwalten, nicht um in Logs zu suchen.
- Wonach wird gesucht? Es wird nach Fällen und Entitäten (z. B. Nutzern, Assets, IP-Adressen) auf der SOAR-Plattform gesucht.
- So funktioniert es: Sie können Freitext- oder feldbasierte Filter verwenden, um Fälle beispielsweise nach ID, Meldungsname, Status und zugewiesenem Nutzer zu suchen.
- Beispiel: Suchen Sie nach
CaseIds:180oderAlertName:Brute Force.
Datenaufnahmepipeline für die Suchverfügbarkeit
Die End-to-End-Datenverfügbarkeit ist die Gesamtzeit zwischen dem Auftreten eines Ereignisses und dem Zeitpunkt, an dem es für die Suche oder Regelausführung in Google SecOps verfügbar ist. Diese Latenz ist die Summe der folgenden beiden Komponenten:
Verzögerung der Verfügbarkeit auf Quellseite: Die Zeit zwischen dem Auftreten eines Ereignisses und dem Zeitpunkt, zu dem das Quellsystem die Protokolldaten für die Aufnahme verfügbar macht. Diese Verzögerung hängt von der Architektur, der Verarbeitung, dem Batching und den API-Veröffentlichungszeitplänen des Quellsystems ab. Google SecOps kann diese Verzögerung nicht beeinflussen. Beispiele hierfür sind Verzögerungen, wenn ein System Logs in einen Storage-Bucket schreibt oder sie auf einem API-Endpunkt veröffentlicht.
Google SecOps-Verarbeitungszeit: Die Zeit, die Google SecOps benötigt, um die Daten nach dem Empfang zu verarbeiten. Diese Dauer umfasst interne Pipelinephasen wie Aufnahme, Parsing, Normalisierung, Indexierung und Anreicherung.
Sie müssen beide Komponenten berücksichtigen, wenn Sie Probleme mit der Zeitachse der Datensichtbarkeit beheben.
Verzögerungen, die von der Datenquelle verursacht werden
Die folgenden Faktoren können die quellseitige Verfügbarkeitsverzögerung beeinflussen:
- Batchverarbeitung: Einige Systeme generieren Logs in Batches in festgelegten Intervallen (z. B. stündlich).
- API-Latenz: Bei der Quell-API kann es zu Verzögerungen kommen, bis neue Ereignisse abgefragt werden können.
- Zeitpunkt der Ereigniserstellung und -veröffentlichung: Der Zeitstempel eines Ereignisses in einem Protokoll kann viel früher sein als der Zeitstempel, zu dem das Protokoll fertiggestellt und für die Erfassung verfügbar wird.
- Drosselung: Quellseitige API-Ratenbegrenzungen können den Datenabruf verlangsamen.
- Erster Backfill: Die Bereitstellung und Aufnahme großer Mengen an Verlaufsdaten nimmt Zeit in Anspruch.
Diese Verzögerungen variieren je nach Datenquelle und Logtyp. Weitere Informationen zu Aufnahmemethoden finden Sie unter Datenaufnahme – Übersicht. In der Feed Management API-Referenz werden spezifische Überlegungen für Logtypen wie Microsoft Graph, SentinelOne, Okta und CrowdStrike beschrieben.
Google SecOps-Verarbeitungszeit
Neu aufgenommene Daten werden in mehreren Schritten verarbeitet. Die Dauer dieser Schritte bestimmt, wann neu aufgenommene Daten für Abfragen und Analysen verfügbar sind.
In der folgenden Tabelle sind die Verarbeitungsschritte für neu aufgenommene Daten nach Suchmethode aufgeführt. Neu aufgenommene Daten können nach Abschluss dieser Schritte durchsucht werden.
| Suchmethode | Daten, die durchsucht werden | Verarbeitungsschritte, die zur Verfügbarkeitszeit beitragen |
|---|---|---|
| Normalisierte und angereicherte UDM-Ereignisse |
|
|
| Suche in Rohlogs | Ungeparster Original-Logtext |
|
| Erkennungs-Engine (Regeln) | Normalisierte Ereignisse |
|
| SOAR-Suche | Fälle und Entitäten |
Dies ist ein anderer Lebenszyklus, da nach Benachrichtigungen und Fällen und nicht nach Logs gesucht wird. Die Zeit basiert auf Folgendem:
|
Beispiel für einen Datenfluss
Das folgende Beispiel zeigt, wie Google SecOps Ihre Sicherheitsdaten aufnimmt, verarbeitet, erweitert und analysiert, um sie für Suchanfragen und weitere Analysen verfügbar zu machen.
Beispiel für Datenverarbeitungsschritte
- Ruft Sicherheitsdaten von Cloud-Diensten wie Amazon S3 oder von derGoogle Cloudab. Google SecOps verschlüsselt diese Daten bei der Übertragung.
- Ihre verschlüsselten Sicherheitsdaten werden getrennt und in Ihrem Konto gespeichert. Der Zugriff ist auf Sie und eine kleine Anzahl von Google-Mitarbeitern für Produktsupport, Entwicklung und Wartung beschränkt.
- Parst und validiert Sicherheitsrohdaten, um sie einfacher zu verarbeiten und anzusehen.
- Normalisiert und indexiert die Daten für schnelle Suchvorgänge.
- Speichert die geparsten und indexierten Daten in Ihrem Konto.
- Anreicherung mit Kontextdaten.
- Bietet Nutzern sicheren Zugriff, um ihre Sicherheitsdaten zu suchen und zu prüfen.
- Vergleicht Ihre Sicherheitsdaten mit der Malware-Datenbank von Google Threat Intelligence, um Übereinstimmungen zu finden. Öffnen Sie in der SIEM-Suche den Tab Übersicht für eine Domain, einen Datei-Hash oder eine IP-Adresse und klicken Sie auf VT-Kontext, um Informationen von Google Threat Intelligence aufzurufen. Google SecOps gibt Ihre Sicherheitsdaten nicht an Google Threat Intelligence weiter.
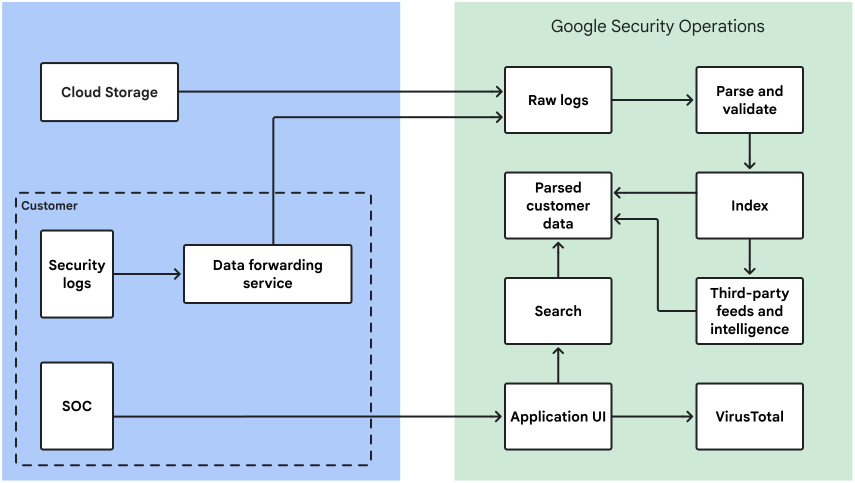
Beispiele für die erwartete Zeit bis zur Verfügbarkeit in der Suche
Die erwartete Zeit, bis die neu aufgenommenen Daten für die Suche verfügbar sind, ist die Summe der Flussdauern entlang des Datenflusses.
Eine typische durchschnittliche Zeit für die Datenverfügbarkeit in der UDM-Suche beträgt beispielsweise etwa 5 Minuten und 30 Sekunden ab dem Zeitpunkt, an dem die Daten an den Google SecOps-Aufnahmedienst gesendet werden.
| Datenflussschritt | Beschreibung | Ablaufdauer |
|---|---|---|
| Cloud Storage zu Rohe Logs | Nimmt Rohlogs aus Cloud Storage auf. | Weniger als 30 Sekunden |
| Sicherheitsprotokolle an Datenweiterleitungsdienst | Überträgt Sicherheitsprotokolle von internen Systemen an die Plattform. | – |
| Datenweiterleitungsdienst zu Rohprotokollen | Sendet von verschiedenen Quellen empfangene Sicherheitsrohdaten an die Aufnahmepipeline. | Weniger als 30 Sekunden |
| Rohlogs zu Parsen und validieren | Parst und validiert Rohlogs in das UDM-Format. | Weniger als 3 Minuten |
| Parsen und validieren bis Index | Indexiert die geparsten UDM-Daten für eine schnelle Suche. | – |
| Index zu Geparste Kundendaten | Stellt die indexierten Daten als geparste Kundendaten für die Analyse zur Verfügung. | Weniger als 2 Minuten |
Fehlerbehebung
In diesem Abschnitt finden Sie Hinweise zur Fehlerbehebung.
Latenz und Limits
Für Verarbeitungs- und Visualisierungsverzögerungen innerhalb der Google SecOps-Plattform gelten die folgenden architektonischen Limits, nachdem Google SecOps die Daten erhalten hat:
- Sichtbarkeit in der Suche: 2 bis 15 Minuten nach der Aufnahme.
- Regelausführung: 5 bis 10 Minuten nach dem Eintreffen des Ereignisses.
Benötigen Sie weitere Hilfe? Antworten von Community-Mitgliedern und Google SecOps-Experten erhalten