


Comprendre la disponibilité des données pour la recherche
Ce document détaille le cycle de vie de l'ingestion de données, y compris le flux de données et la latence de bout en bout, ainsi que l'impact de ces facteurs sur la disponibilité des données récemment ingérées pour les requêtes et l'analyse.
Ingérer et traiter des données dans Google SecOps
Cette section décrit comment Google SecOps ingère, traite et analyse les données de sécurité.
Ingestion de données
Le pipeline d'ingestion de données commence par collecter vos données de sécurité brutes à partir de sources telles que :
- Journaux de sécurité de vos systèmes internes
- Données stockées dans Cloud Storage
- Votre centre des opérations de sécurité (SOC) et d'autres systèmes internes
Google SecOps transfère ces données vers la plate-forme à l'aide de l'une de ses méthodes d'ingestion sécurisées.
Les principales méthodes d'ingestion sont les suivantes :
Ingestion Google Cloud directe
Google SecOps utilise l'ingestion Google Cloud directe pour extraire automatiquement les journaux et les données de télémétrie de votre organisation Google Cloud, y compris Cloud Logging, les métadonnées de l'inventaire des éléments cloud et les résultats de Security Command Center Premium.
API d'ingestion
Envoyez des données directement à Google SecOps à l'aide de ses API d'ingestion REST publiques. Vous utilisez cette méthode pour les intégrations personnalisées ou pour envoyer des données sous forme de journaux non structurés ou d'événements UDM (Unified Data Model) préformatés.
Agent BindPlane
Vous pouvez déployer l'agent Bindplane polyvalent dans votre environnement (sur site ou dans d'autres clouds) pour collecter les journaux d'une grande variété de sources et les transférer vers Google SecOps.
Flux de données
Dans Google SecOps, vous configurez des flux de données pour extraire les journaux de sources tierces, telles que des buckets de stockage cloud tiers spécifiques (comme Amazon S3) ou des API tierces (comme Okta ou Microsoft 365).
Normalisation et enrichissement des données
Une fois les données arrivées dans Google SecOps, la plate-forme les traite en suivant les étapes suivantes :
Analyse syntaxique et normalisation
Un analyseur traite d'abord les données de journaux brutes pour valider, extraire et transformer les données de leur format d'origine au format UDM standardisé. L'analyse syntaxique et la normalisation vous permettent d'analyser des sources de données disparates (par exemple, des journaux de pare-feu, des données de point de terminaison, des journaux cloud) à l'aide d'un schéma unique et cohérent. Le journal brut d'origine reste stocké avec l'événement UDM.
Indexation
Après la normalisation, Google SecOps indexe les données UDM pour accélérer les requêtes sur des ensembles de données volumineux, ce qui permet de rechercher les événements UDM.
Aliasing et enrichissement de l'UDM
- Google SecOps effectue l'aliasing et l'enrichissement UDM pour enrichir les événements UDM avec un contexte utile, en identifiant et en ajoutant des données contextuelles et des indicateurs pour les entités de journaux. Par exemple, il associe le
login named'un utilisateur à ses différentsIP addresses,hostnamesetMAC addresses. - Géolocalisation : Google SecOps enrichit les adresses IP avec des données de géolocalisation.
- Google SecOps effectue l'aliasing et l'enrichissement UDM pour enrichir les événements UDM avec un contexte utile, en identifiant et en ajoutant des données contextuelles et des indicateurs pour les entités de journaux. Par exemple, il associe le
Enrichissement de l'ECG
Google SecOps effectue un aliasing ECG qui fusionne le contexte de plusieurs sources (telles que les IdP, les CMDB et les renseignements sur les menaces) pour créer un profil d'entité consolidé dans le graphique de contexte d'entité.
Renseignement sur les menaces : Google SecOps compare automatiquement les données d'événement aux vastes renseignements sur les menaces de Google, y compris des sources telles que Google Threat Intelligence et Navigation sécurisée, pour identifier les menaces malveillantes connues, comme
domains,IP addressesetfile hashes.WHOIS : Google SecOps enrichit les noms de domaine avec leurs informations d'enregistrement public WHOIS.
Disponibilité des données pour l'analyse
Une fois traitées et enrichies, les données UDM sont immédiatement disponibles pour l'analyse :
Détection en temps réel
Le moteur de détection exécute automatiquement les règles personnalisées et créées par Google pour lesquelles l'option Règle en direct est activée sur les données entrantes en direct afin d'identifier les menaces et de générer des alertes.
Recherche et investigation
Un analyste peut utiliser les méthodes de recherche pour effectuer des recherches dans toutes ces données normalisées et enrichies. Par exemple, en utilisant la recherche UDM pour passer d'une entité associée à une autre (par exemple, d'un
userà sonasset, puis à undomainmalveillant) et examiner les alertes.
Méthodes de recherche
Google SecOps propose plusieurs méthodes distinctes pour rechercher vos données, chacune ayant un objectif différent.
Recherche UDM
La recherche UDM est la méthode de recherche principale et la plus rapide, utilisée pour la plupart des investigations.
- Éléments recherchés : interroge les événements UDM normalisés et indexés. Comme toutes les données sont analysées dans ce format standard, vous pouvez écrire une seule requête pour trouver la même activité (comme une connexion) dans tous vos différents produits (par exemple, Windows, Okta, Linux).
- Comment ça fonctionne ? Vous utilisez une syntaxe spécifique pour interroger des champs, des opérateurs et des valeurs.
Exemple :
principal.hostname = "win-server" AND target.ip = "10.1.2.3"Les résultats sont généralement disponibles dans un délai de 2 à 15 minutes après l'ingestion.
Recherche dans les journaux bruts
Utilisez la recherche dans les journaux bruts pour trouver un élément dans le message de journal d'origine non analysé qui n'a peut-être pas été mappé à un champ UDM. Cette méthode de recherche est optimisée pour les recherches à grande vitesse. Elle renvoie généralement des résultats en moins de deux secondes pour des indicateurs spécifiques tels que les hachages de fichiers ou les adresses IP.
- Éléments recherchés : il analyse le texte brut d'origine des journaux avant qu'ils ne soient analysés et normalisés. Cela est utile pour rechercher des chaînes spécifiques, des arguments de ligne de commande ou d'autres artefacts qui ne sont pas des champs UDM indexés.
- Fonctionnement : vous utilisez le préfixe
raw =. Elle peut être plus lente que la recherche UDM, car elle ne recherche pas les champs indexés. - Exemple (chaîne) :
raw = "PsExec.exe" - Exemple (expression régulière) :
raw = /admin\$/
Recherche de stats
Utilisez la recherche de statistiques pour les tendances à long terme qui agrègent des millions de lignes de données. Comme la plate-forme doit effectuer une analyse statistique et un regroupement, attendez-vous à des temps de chargement plus longs pour ces requêtes.
Recherche en langage naturel (Gemini)
La recherche en langage naturel (Gemini) vous permet de poser des questions en anglais simple, que Gemini traduit ensuite en requête UDM formelle.
- Ce qu'elle recherche : elle fournit une interface de conversation pour interroger les données UDM.
- Comment ça marche : vous saisissez une question, et Gemini génère la requête de recherche UDM sous-jacente, que vous pouvez ensuite exécuter ou affiner.
- Exemple : "Affiche toutes les connexions ayant échoué de l'utilisateur 'bob' au cours des dernières 24 heures"
Recherche SOAR
La recherche SOAR est spécifique aux composants SOAR. Vous l'utilisez pour gérer les incidents de sécurité, et non pour rechercher des informations dans les journaux.
- Éléments recherchés : recherche des demandes et des entités (comme des utilisateurs, des éléments ou des adresses IP) sur la plate-forme SOAR.
- Fonctionnement : vous pouvez utiliser des filtres de texte libre ou basés sur des champs pour rechercher des demandes, par exemple, par ID, nom d'alerte, état et utilisateur attribué.
- Exemple : Recherchez
CaseIds:180ouAlertName:Brute Force.
Pipeline d'ingestion de données pour la disponibilité de la recherche
La disponibilité des données de bout en bout correspond au délai total entre le moment où un événement se produit et celui où il est disponible pour la recherche ou l'exécution de règles dans Google SecOps. Cette latence est la somme des deux composants suivants :
Délai de disponibilité côté source : délai entre le moment où un événement se produit et le moment où le système source rend les données de journal disponibles pour l'ingestion. Ce délai dépend de l'architecture, du traitement, du traitement par lot et des calendriers de publication des API du système source. Google SecOps ne peut pas influencer ce délai. Par exemple, des retards peuvent survenir lorsqu'un système écrit des journaux dans un bucket de stockage ou les publie sur un point de terminaison d'API.
Temps de traitement Google SecOps : temps nécessaire à Google SecOps pour traiter les données après les avoir reçues. Cette durée inclut les étapes internes du pipeline, telles que l'ingestion, l'analyse, la normalisation, l'indexation et l'enrichissement.
Vous devez tenir compte de ces deux composants lorsque vous résolvez les problèmes liés aux délais de visibilité des données.
Retards provenant de la source de données
Les facteurs suivants peuvent influencer le délai de disponibilité côté source :
- Traitement par lot : certains systèmes génèrent des journaux par lot à intervalles réguliers (par exemple, toutes les heures).
- Latence de l'API : l'API source peut présenter des retards inhérents à la mise à disposition des nouveaux événements pour les requêtes.
- Heure de création et de publication de l'événement : le code temporel d'un événement dans un journal peut être bien antérieur à celui de la finalisation du journal et de sa mise à disposition pour la collecte.
- Limitation du débit : les limites de débit des API côté source peuvent ralentir la récupération des données.
- Remplissage initial : la diffusion et l'ingestion de grands volumes de données historiques prennent du temps.
Ces délais varient selon la source de données et le type de journal. Pour en savoir plus sur les méthodes d'ingestion, consultez Présentation de l'ingestion de données. La documentation de référence de l'API Feed Management décrit les considérations spécifiques à certains types de journaux, tels que Microsoft Graph, SentinelOne, Okta et CrowdStrike.
Délai de traitement de Google SecOps
Le système traite les données nouvellement ingérées en plusieurs étapes. La durée de ces étapes détermine le moment où les données nouvellement ingérées deviennent disponibles pour les requêtes et l'analyse.
Le tableau suivant détaille les étapes de traitement des données nouvellement ingérées par méthode de recherche. Les données nouvellement ingérées deviennent consultables une fois ces étapes terminées.
| Méthode de recherche | Données recherchées | Étapes de traitement contribuant au délai de disponibilité |
|---|---|---|
| Événements UDM normalisés et enrichis |
|
|
| Recherche dans les journaux bruts | Texte du journal d'origine non analysé |
|
| Moteur de détection (règles) | Événements normalisés |
|
| Recherche SOAR | Demandes et entités |
Il s'agit d'un cycle de vie différent, car il recherche des alertes et des cas, et non des journaux. L'heure est basée sur :
|
Exemple de flux de données
L'exemple suivant montre comment Google SecOps ingère, traite, améliore et analyse vos données de sécurité, en les rendant disponibles pour les recherches et les analyses ultérieures.
Exemple d'étapes de traitement des données
- Récupère les données de sécurité à partir de services cloud tels qu'Amazon S3 ou deGoogle Cloud. Google SecOps chiffre ces données en transit.
- Sépare et stocke vos données de sécurité chiffrées dans votre compte. L'accès est limité à vous et à un petit nombre d'employés Google pour l'assistance, le développement et la maintenance du produit.
- Analyse et valide les données de sécurité brutes, ce qui facilite leur traitement et leur affichage.
- Normalise et indexe les données pour des recherches rapides.
- Stocke les données analysées et indexées dans votre compte.
- Enrichit avec des données contextuelles.
- Offre un accès sécurisé aux utilisateurs pour rechercher et examiner leurs données de sécurité.
- Compare vos données de sécurité avec la base de données de logiciels malveillants de Google Threat Intelligence pour identifier les correspondances. Dans Recherche SIEM, ouvrez l'onglet Présentation pour un domaine, un hachage de fichier ou une adresse IP, puis cliquez sur Contexte VT pour afficher les informations Google Threat Intelligence. Google SecOps ne partage pas vos données de sécurité avec Google Threat Intelligence.
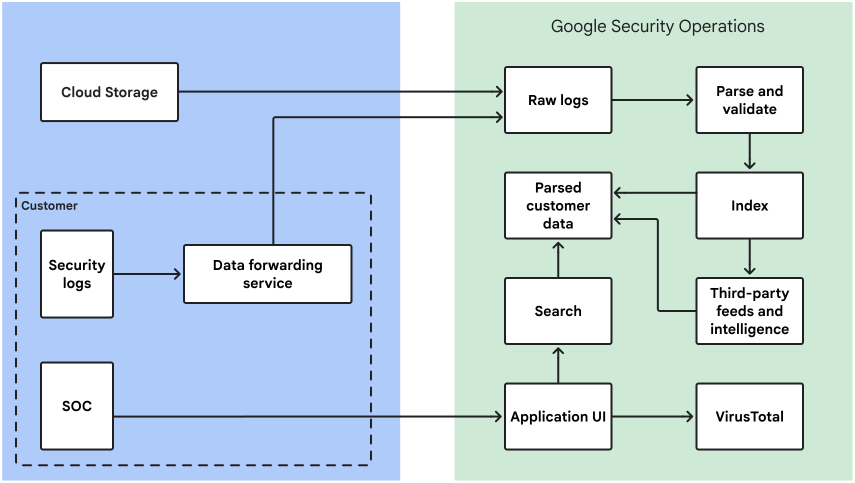
Exemples de délais avant que la recherche soit disponible
Le délai prévu avant que les données nouvellement ingérées ne soient disponibles pour la recherche correspond à la somme des durées de flux le long du flux de données.
Par exemple, le délai moyen de disponibilité des données dans la recherche UDM est d'environ 5 minutes et 30 secondes à compter de l'envoi des données au service d'ingestion Google SecOps.
| Étape de flux de données | Description | Durée du flux |
|---|---|---|
| Cloud Storage vers Journaux bruts | Ingère les journaux bruts depuis Cloud Storage. | Moins de 30 secondes |
| Journaux de sécurité vers Service de transfert de données | Transmet les journaux de sécurité des systèmes internes à la plate-forme. | N/A |
| Service de transfert de données vers Journaux bruts | Envoie les données de sécurité brutes reçues de différentes sources au pipeline d'ingestion. | Moins de 30 secondes |
| Journaux bruts à analyser et valider | Analyse et valide les journaux bruts au format UDM. | Moins de 3 minutes |
| Analyser et valider à Indexer | Indexe les données UDM analysées pour une recherche rapide. | N/A |
| Index vers Données client analysées | Rend les données indexées disponibles en tant que données client analysées pour l'analyse. | Moins de 2 minutes |
Dépannage
Cette section fournit des conseils de dépannage.
Latence et limites
Les délais de traitement et de visualisation au sein de la plate-forme Google SecOps sont soumis aux limites architecturales suivantes une fois que Google SecOps a reçu les données :
- Visibilité dans la recherche : 2 à 15 minutes après l'ingestion.
- Exécution de la règle : 5 à 10 minutes après l'arrivée de l'événement.
Vous avez encore besoin d'aide ? Obtenez des réponses de membres de la communauté et de professionnels Google SecOps.